ตั้งแจ้งเตือนยังไงให้รู้ว่าต้องทำอะไรต่อ
ตอนเริ่มติดตามระบบ เรามักอยากให้มีข้อความเตือนทุกครั้งที่ค่าออกนอกช่วง เพราะกลัวว่าจะพลาดอะไรไป จึงตั้งทั้ง CPU หน่วยความจำ จำนวน error และสถานะของทุกบริการให้ส่งเข้ามาพร้อมกัน
แต่เมื่อข้อความมากขึ้น คนรับก็ยังต้องแยกเองว่าอันไหนกระทบงาน อันไหนเป็นอาการที่เห็นตามปกติ และอันไหนต้องทำตอนนี้ ถ้าทุกข้อความใช้ความเร่งด่วนเหมือนกัน ระบบแจ้งเตือนก็อาจไม่ได้ช่วยให้เริ่มแก้ได้เร็วขึ้นตามจำนวนที่ส่ง
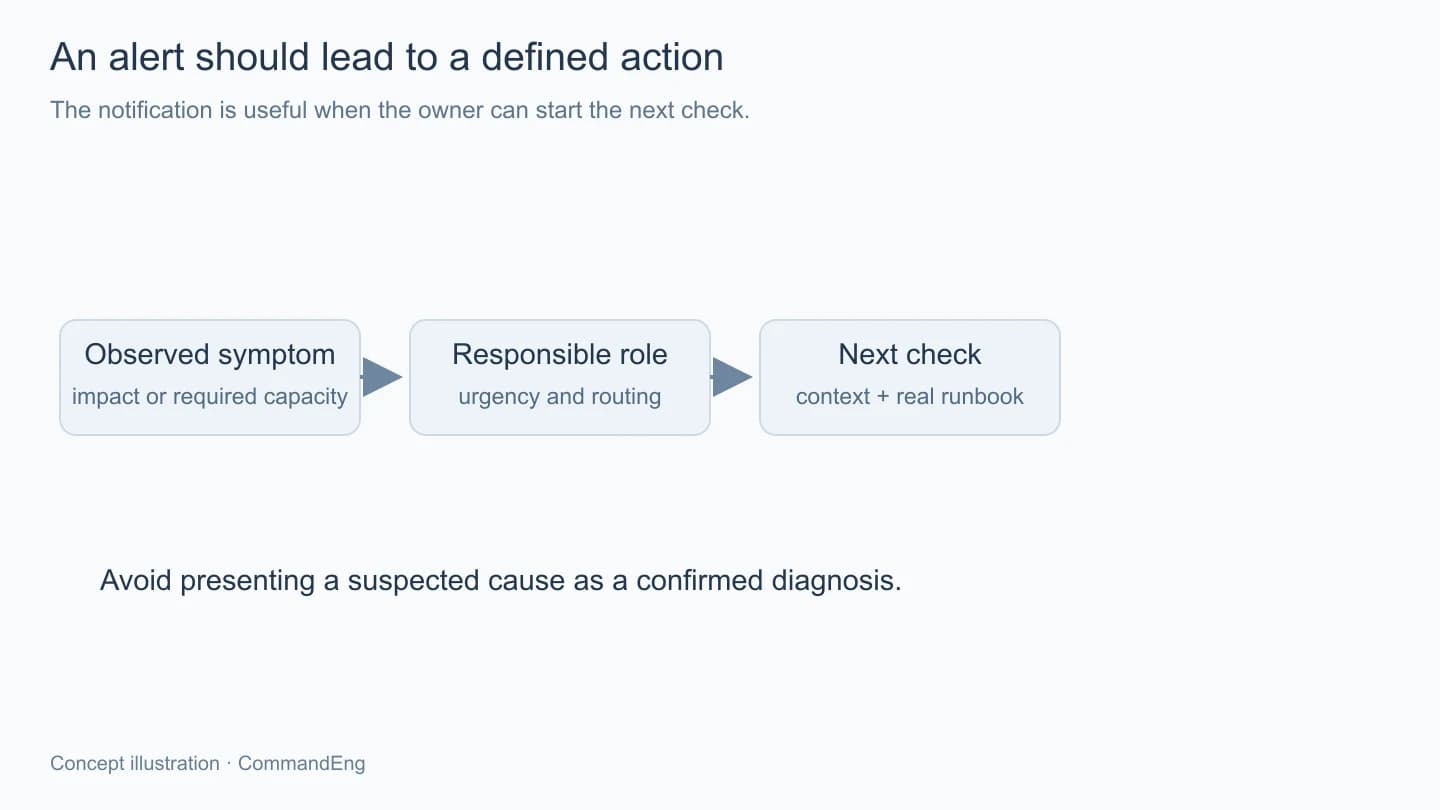
ก่อนเพิ่มกฎ ลองเริ่มจากคำถามว่าเมื่อเตือนแล้วใครจะทำอะไรครับ จากนั้นค่อยเลือกอาการ เงื่อนไขเวลา และข้อมูลที่ควรตามไปด้วย เพื่อให้แต่ละข้อความมีหน้าที่ที่ชัดเจน
เลือกสิ่งที่มีผลต่องานหรือควรลงมือก่อนเกิดผล
อาการที่ผู้ใช้เข้าบริการไม่ได้หรือข้อมูลสำคัญไม่มาถึงช่วยชี้ผลกระทบได้ตรงกว่า metric ภายในบางตัวเพียงอย่างเดียว ส่วนค่าภายในยังมีประโยชน์เป็นข้อมูลตรวจสาเหตุหรือเตือนเรื่องความจุที่ต้องจัดการล่วงหน้าตามงาน
เช่น CPU สูงอาจเกิดในงานที่กำลังประมวลผลตามปกติ ถ้ายังไม่มีปัญหาเรื่องเวลาตอบสนองหรือขอบเขตที่งานกำหนด การส่งข้อความเร่งด่วนทุกครั้งก็อาจไม่ได้เพิ่มการตัดสินใจที่จำเป็น แต่ระบบที่ใกล้พื้นที่เต็มอาจต้องมีแผนจัดการก่อนกระทบข้อมูล แม้ผู้ใช้ยังเปิดเว็บได้อยู่
จึงควรแยกสิ่งที่ต้องแก้ทันที สิ่งที่รอจัดการได้ และข้อมูลเพื่อดูแนวโน้ม ไม่บังคับให้ทุกข้อเข้าช่องทางเดียวกันด้วยคำว่า critical เหมือนกันหมด โดยขอบเขตต้องอิงคนที่ดูแลกับเวลาที่งานยอมรอได้จริง
หากกฎหนึ่งแจ้งมาหลายครั้งแต่ไม่มีใครรู้ว่าควรทำอะไร ควรทบทวนความหมายหรือเงื่อนไข ไม่เพิ่มข้อความอธิบายยาวขึ้นอย่างเดียว เพราะต้นเหตุอาจเป็นกฎที่ยังไม่ได้เชื่อมกับการตัดสินใจใดตั้งแต่แรก
ช่วงเวลาช่วยแยกอาการชั่วคราว แต่ต้องมีเหตุผล
Prometheus ใช้กฎประเมินเงื่อนไขตามรอบ และมี for เพื่อให้เงื่อนไขคงอยู่ตามระยะที่กำหนดก่อนเข้าสู่สถานะ firing ตามการทำงานของมัน จึงช่วยไม่ให้ความผิดปกติสั้นๆ ทุกครั้งกลายเป็นข้อความทันทีได้
แต่การเพิ่มเวลารอนานขึ้นไม่ได้ดีเสมอไป ถ้างานเสียหายเร็ว เราก็ต้องรู้ให้ทัน ส่วนอาการที่ยอมมีสะดุดสั้นได้อาจเลือกขอบเขตต่างกัน ระยะจึงควรมาจากสิ่งที่ต้องรับมือ ไม่คัดค่าจากตัวอย่างเดียวไปใช้กับทุกบริการ
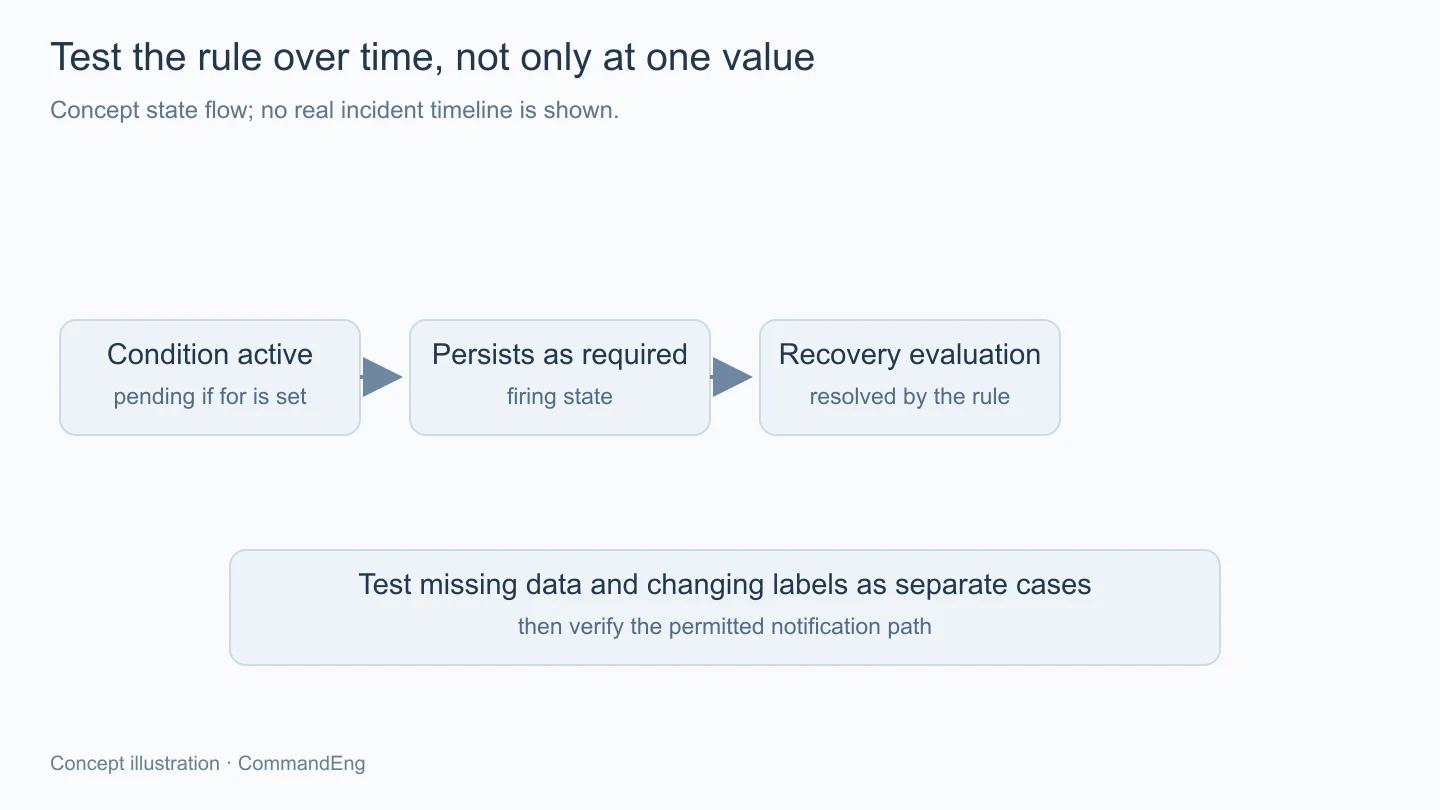
ตัวตนของ alert ยังเกี่ยวกับ label set ด้วย หากเอาค่าที่เปลี่ยนทุกรอบไปไว้ใน label ก็อาจทำให้สถานะถูกมองเป็นคนละชุดตามความหมายของระบบ ควรเก็บข้อมูลอธิบายที่เปลี่ยนไว้ในส่วนที่เหมาะสม และใช้ labels สำหรับจัดกลุ่มกับเลือกเส้นทางแจ้งอย่างมีขอบเขต
ควรตรวจกรณีข้อมูลหายแยกจากค่ากลับปกติด้วย หาก query ไม่มีข้อมูลแล้ว alert หายไป คนรับอาจเข้าใจว่าปัญหาจบ ทั้งที่ต้นทางเก็บ metric ไม่ได้ การกำหนดสิ่งที่คาดว่าจะมีข้อมูลจึงเป็นส่วนหนึ่งของกฎที่ต้องทดสอบ
ข้อความควรพาไปยังขั้นตรวจแรก
อย่างน้อยควรรู้บริการ environment อาการ ช่วงเวลาหรือค่าที่เกี่ยวข้อง และผลกระทบตามสิ่งที่ตรวจได้ ไม่ตั้งชื่อเหมือนยืนยันสาเหตุเมื่อมีเพียงหลักฐานอาการ เช่น เห็นปลายทางไม่ตอบก็ยังไม่ควรฟันธงว่าฐานข้อมูลเสียหายแล้ว
ข้อมูลที่ช่วยต่อได้อาจเป็นลิงก์ Dashboard ที่เลือก service กับเวลาตรงกัน หรือขั้นตรวจสั้นๆ ใน runbook ที่ทีมใช้จริง ไม่ใส่ลิงก์หน้าแรกที่คนต้องไปเลือกตัวกรองใหม่ทั้งหมดเมื่อกำลังรีบ และไม่อ้างว่ามีเอกสารพร้อมหากยังไม่มีใครทำไว้
เจ้าของเรื่องก็ควรชัดว่าเป็นทีมใดหรือบทบาทใด ถ้าอาการเกี่ยวข้องหลายบริการ ควรมีวิธีส่งต่อความรับผิดชอบตามที่ตกลง ไม่ส่งพร้อมกันทุกคนแล้วหวังว่าจะมีใครเริ่มเองเสมอไป
ข้อความไม่จำเป็นต้องรวม log หรือข้อมูลลับเต็มชุดเพื่อให้ดูมีรายละเอียด ควรพาไปแหล่งที่มีสิทธิ์เหมาะสม และเก็บข้อมูลเท่าที่คนรับต้องใช้เริ่มตรวจ เพราะช่องทางแจ้งอาจมีขอบเขตผู้เห็นต่างจากระบบต้นทาง
ลดการเตือนซ้ำโดยยังเห็นผลกระทบ
เมื่อบริการหลักหยุด บริการที่พึ่งมันอาจแสดงอาการหลายตัวพร้อมกัน ระบบอย่าง Alertmanager มีความสามารถจัดกลุ่ม ระงับบางข้อความ และเลือกเส้นทางตามที่รองรับ แต่กติกาควรถูกวางจากความสัมพันธ์จริง ไม่ปิดข้อความทั้งหมดเพียงเพราะมี alert หนึ่งตัวอยู่
หากต้อง silence ระหว่างดูแลระบบ ควรมีขอบเขตและเวลาสิ้นสุดที่เหมาะสม รวมถึงรู้ว่าใครเป็นคนตั้งและเหตุใด เพื่อไม่ให้การหยุดเสียงชั่วคราวกลายเป็นช่องว่างที่ไม่มีใครกลับมาเปิดตรวจ
การแจ้งว่ากลับปกติก็ควรมีความหมายชัด คนรับต้องรู้ว่าอาการผ่านเงื่อนไขที่ตั้งแล้ว ไม่ใช่ข้อรับรองว่าทุกส่วนไม่มีปัญหาอีก และหากยังมีงานตามหลัง เช่น ตรวจข้อมูลที่ตกค้าง ก็ควรอยู่ในขั้นตอนของผู้ดูแลตามหน้าที่นั้น
ทดสอบทั้งกฎและเส้นทางส่งข้อความ
เงื่อนไขใน query สามารถมีกรณีทดสอบตามเวลาที่กำหนดได้ เช่น ผิดสั้นแล้วกลับ ผิดต่อเนื่อง หรือข้อมูลหาย เพื่อดูสถานะ pending กับ firing ตามที่ตั้งใจ โดยใช้ข้อมูลทดสอบที่บอกชัดว่าไม่ใช่เหตุจริง
ส่วนการส่งแจ้งต้องทดสอบถึงผู้รับหรือปลายทางทดสอบที่ได้รับอนุญาตตาม workflow ด้วย เพราะกฎประเมินผ่านไม่ได้ยืนยันว่า routing และช่องทางส่งพร้อม และระบบแจ้งเตือนเองก็ต้องมีการเฝ้าดูไม่ให้เงียบหายโดยไม่มีใครรู้
หลังมีเหตุจริง ควรย้อนดูว่ากฎเตือนทันหรือช้าไป มีข้อความใดไม่ได้ช่วย และขั้นตอนที่ลิงก์ไปยังใช้ได้หรือไม่ การปรับจากข้อมูลนี้จะทำให้ระบบค่อยๆ ตรงงานขึ้น แทนการเพิ่มกฎใหม่ทุกครั้งโดยไม่เคยทบทวนของเก่า
อาจเก็บประวัติว่าแต่ละกฎส่งกี่ครั้ง มีครั้งใดที่ต้องลงมือ และเรื่องใดเป็นเหตุซ้ำที่ควรแก้ต้นทาง ข้อมูลนี้ใช้ปรับกฎกับระบบได้ดีกว่าตั้งเป้าว่าต้องลดจำนวน alert ให้ต่ำที่สุด เพราะบางช่วงจำนวนที่เพิ่มขึ้นอาจสะท้อนปัญหาจริงที่ยังต้องดูแล ไม่ควรถูกซ่อนเพื่อให้รายงานดูเงียบลง
สรุป
alert ที่ช่วยงานควรเชื่อมอาการกับผลกระทบ คนรับผิดชอบ และขั้นตรวจต่อ พร้อมมีเงื่อนไขเวลาที่เหมาะสม เมื่อทดสอบกฎกับเส้นทางแจ้งและทบทวนหลังใช้งาน เราจะลดข้อความที่ไม่มีสิ่งให้ทำต่อ และทำให้ข้อความที่เหลือมีข้อมูลพอเริ่มจัดการได้จริงครับ

