


เวลาต่อ API ให้ระบบคุยกัน เรามักเริ่มจากคำขอที่ตอบกลับมาได้ตามปกติก่อน แล้วค่อยเพิ่มการจัดการเมื่อปลายทางไม่ตอบ แต่พอถึงขั้นนั้น การตั้งให้ลองใหม่อีกสองสามครั้งอาจดูเป็นคำตอบที่จบง่าย ทั้งที่ยังมีรายละเอียดให้คิดต่อว่ากำลังลองงานอะไร และผู้ใช้รอผลอยู่แบบไหน
อย่างงานโหลดข้อมูลมาแสดงบนหน้าเว็บ ถ้าผู้ใช้รออยู่ตรงนั้น เวลาที่ใช้ลองใหม่ทั้งหมดก็เป็นส่วนหนึ่งของเวลารอหน้าเดียวกัน ส่วนงานเบื้องหลังที่ยอมเลื่อนออกไปได้ อาจมีทางเลือกพักคิวแล้วกลับมาทำภายหลังได้มากกว่า จึงไม่จำเป็นต้องใช้จำนวนครั้งกับระยะรอชุดเดียวกัน
ก่อนเลือกว่าจะ retry กี่ครั้ง แอดว่าเริ่มจากกำหนดเวลารวมที่ยอมใช้กับงานนั้นก่อนจะช่วยให้คิดต่อได้ง่ายกว่าครับ จากนั้นค่อยดูว่าความผิดพลาดแบบไหนควรลองใหม่ และต้องกันไม่ให้การลองใหม่ไปเพิ่มภาระให้บริการที่กำลังมีปัญหาอย่างไร
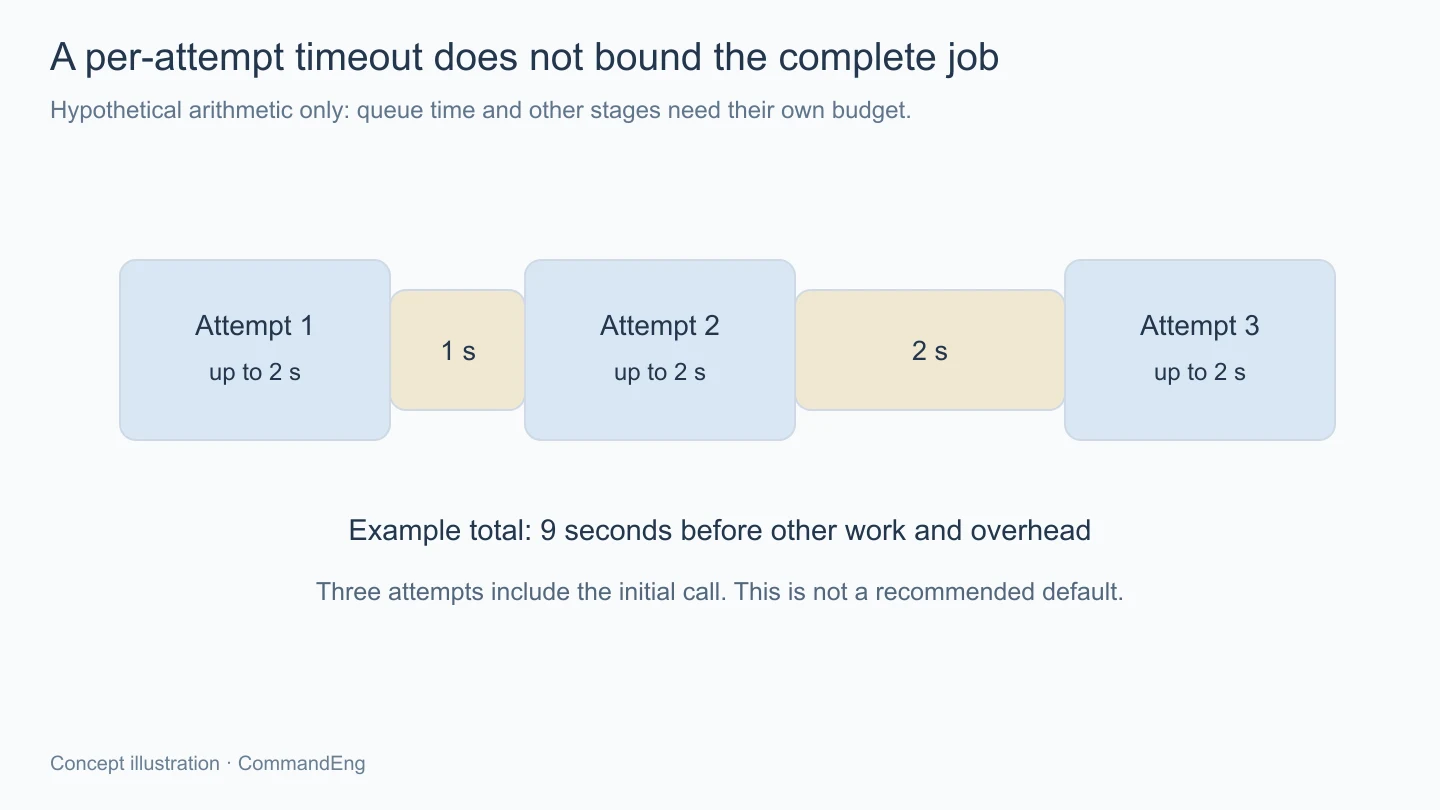
สมมติให้การเรียกหนึ่งครั้งรอได้ไม่เกินสองวินาที และยอมให้มีสาม attempt โดยนับการเรียกครั้งแรกอยู่ในสามครั้งนี้ด้วย หากมีช่วงรอระหว่างครั้งหนึ่งกับสองอีกหนึ่งวินาที และระหว่างครั้งสองกับสามอีกสองวินาที เวลาของส่วนนี้ก็อาจใช้ถึงเก้าวินาทีเมื่อแต่ละครั้งรอจนเต็มเวลา
ตัวเลขนี้เป็นเพียงตัวอย่างคำนวณ ไม่ใช่ค่าที่แนะนำให้ใช้กับทุกระบบ และยังไม่ได้รวมเวลารอคิว เตรียมข้อมูล หรือขั้นถัดไปของงาน ถ้าหน้าจอที่เรียก workflow ยอมรอได้สั้นกว่านั้น การกำหนด timeout ต่อครั้งอย่างเดียวก็ยังไม่ทำให้งานจบในเวลาที่ต้องการ
จึงควรมี deadline หรือขอบเขตเวลารวม แล้วคำนวณเวลาที่เหลือก่อนเริ่มแต่ละครั้ง ถ้าเหลือเวลาไม่พอสำหรับการเรียกกับการส่งผลกลับ ก็ควรจบด้วยสถานะที่ระบบเข้าใจได้ แทนการเริ่ม attempt ใหม่ทั้งที่รู้ว่าจะเกินขอบเขตของผู้เรียก
ต้องตรวจด้วยว่า timeout ของเครื่องมือครอบคลุมช่วงไหน บางตัวแยกเวลาต่อเชื่อมออกจากเวลาอ่านคำตอบ และค่าที่ชื่อคล้ายกันอาจไม่ได้รวมการค้นหา DNS หรือทุกขั้นของการเชื่อมต่อเหมือนกัน การอ่านความหมายของค่าจึงสำคัญพอๆ กับตัวเลขที่ตั้งไว้
ถ้าปลายทางติดขัดชั่วคราว การรอสักช่วงแล้วส่งใหม่อาจช่วยให้งานผ่านได้ แต่ถ้าคำขอขาด field ที่จำเป็น หรือบัญชีไม่มีสิทธิ์ทำงานนั้น การส่งข้อมูลเดิมซ้ำทันทีมักไม่ได้แก้สาเหตุ จึงควรแยกข้อผิดพลาดตามความหมายของ API ก่อนผูกกับนโยบาย retry
สถานะ HTTP เป็นข้อมูลช่วยตัดสินใจส่วนหนึ่ง แต่ต้องอ่านเงื่อนไขของบริการประกอบด้วย เช่น ปลายทางอาจระบุระยะรอผ่าน Retry-After หรือมีรหัสย่อยบอกว่าโควตาชั่วคราวเต็ม ขณะที่บางปัญหาจำเป็นต้องให้คนแก้สิทธิ์หรือข้อมูลก่อน การเหมารวมให้ทุกคำตอบที่ไม่ใช่สำเร็จเข้าวงลองใหม่จึงทำให้ปัญหาที่แก้ด้วยการรอไม่ได้ค้างอยู่นานขึ้น
สำหรับคำขอที่สร้างหรือเปลี่ยนข้อมูล ยังมีคำถามอีกชั้นว่าปลายทางทำไปแล้วหรือยัง เพราะ timeout บอกว่าฝั่งเรารอคำตอบไม่ทัน ไม่ได้ยืนยันว่าคำขอไม่เคยถึงปลายทาง หากสร้างรายการสำเร็จแล้วแต่คำตอบกลับมาไม่ถึง การส่งใหม่อาจสร้างรายการเพิ่มได้
ก่อนอนุญาต retry กับขั้นแบบนี้ จึงต้องดูว่ามี idempotency key หรือรหัสอ้างอิงให้ตรวจผลเดิมหรือไม่ และบริการรับรองพฤติกรรมไว้อย่างไร ชื่อ HTTP method หรือข้อความ error เพียงอย่างเดียวไม่พอที่จะสรุปว่าทุกการส่งซ้ำปลอดภัย
เมื่อบริการปลายทางมีปัญหา หลายงานอาจผิดพลาดในช่วงเวลาใกล้กัน หากทุกงานรอเท่ากันแล้วส่งใหม่พร้อมกัน ก็มีโอกาสสร้างคลื่นคำขอรอบใหม่ให้บริการที่ยังฟื้นตัวไม่ทัน แนวทาง backoff จึงค่อยๆ เพิ่มช่วงรอ ส่วน jitter ช่วยกระจายจังหวะไม่ให้ทุกงานกลับมาตรงเวลาเดียวกันทั้งหมด
การเพิ่มช่วงรอควรมีเพดานและอยู่ภายในเวลารวมที่กำหนดด้วย ไม่อย่างนั้นจำนวนครั้งอาจดูน้อย แต่เวลาที่งานค้างอยู่กลับยาวเกินความต้องการของผู้ใช้ได้ สำหรับงานเบื้องหลังที่ต้องรอนาน ควรดูด้วยว่าระบบปล่อยทรัพยากรระหว่างรอได้หรือกำลังยึด worker ไว้เฉยๆ
สิ่งที่ต้องเลือกจึงมีทั้งระยะเริ่มรอ วิธีเพิ่มระยะ เพดาน และเงื่อนไขหยุด การนำค่าตัวอย่างจากไลบรารีมาใช้ตรงๆ อาจทำให้ระบบเริ่มทำงานได้เร็ว แต่ยังต้องกลับมาตรวจว่าตรงกับลักษณะงานจริง โดยเฉพาะค่าที่หมายถึงลองได้ไม่จำกัดครั้งหากยังไม่ชน timeout รวม
ถ้าปลายทางส่งเวลาที่ควรรอกลับมา ก็ควรนำมาพิจารณาร่วมกับ deadline ของงาน ถ้ารอนานขนาดนั้นไม่ได้ ทางออกอาจเป็นการบอกสถานะว่าต้องกลับมาลองภายหลัง หรือพักงานเบื้องหลัง ไม่ใช่ลดระยะรอแล้วฝืนส่งต่อเพียงเพื่อให้ครบจำนวน attempt
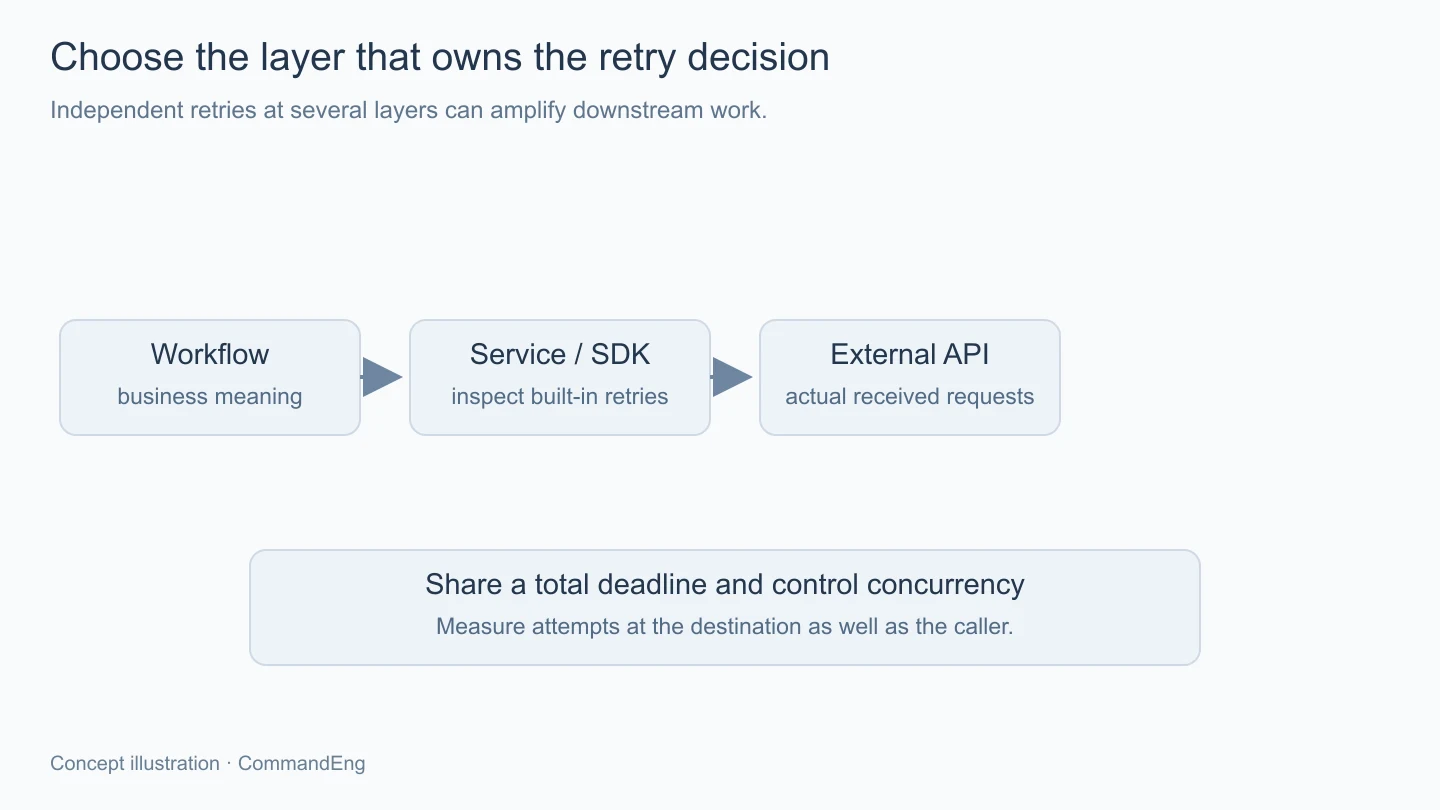
ระบบหนึ่งอาจมีทั้ง HTTP client ที่ลองใหม่เอง โค้ดบริการที่ครอบการเรียกอีกชั้น และ workflow ที่ลอง node ซ้ำด้วย ถ้าแต่ละชั้นนับของตัวเอง จำนวนคำขอที่ถึงปลายทางจริงอาจมากกว่าที่คนดูเฉพาะ workflow คาดไว้มาก
จึงควรกำหนดว่าชั้นไหนเป็นผู้รับผิดชอบการลองใหม่หลัก แล้วตรวจค่าของ SDK และตัวกลางที่ใช้อยู่ให้ครบด้วย การเลือกชั้นที่มองเห็นความหมายของงานกับเวลาที่เหลือได้ ช่วยให้ตัดสินใจหยุดได้ตรงกว่าชั้นที่รู้เพียงว่าเชื่อมต่อไม่สำเร็จ
ถ้าใช้ Temporal ก็ต้องแยก Activity ที่ติดต่อบริการภายนอกออกจาก Workflow ที่จัดลำดับงาน เพราะนโยบาย retry ของทั้งสองไม่ได้มีบทบาทเหมือนกัน การตั้งค่าให้ retry ส่วนที่ล้มเหลวควรอิงชนิดงานกับ timeout ที่เกี่ยวข้อง ไม่ใช้ความเข้าใจว่าการลองใหม่ทั้ง workflow เท่ากับการลองใหม่เฉพาะการเรียก API เสมอไป
นอกจากจำนวนครั้ง ยังควรจำกัดงานที่กำลังเรียกปลายทางพร้อมกัน เพราะแม้แต่ละงานจะรออย่างเหมาะสม แต่ถ้าคิวจำนวนมากถูกปล่อยพร้อมกันก็ยังสร้างภาระสูงได้ การ retry จึงต้องอยู่ร่วมกับการควบคุมคิวและความสามารถของบริการที่เรียกด้วย
ข้อมูลที่ควรเก็บคือจำนวน attempt เวลารวม เหตุผลที่เริ่มลองใหม่ และเหตุผลที่หยุด โดยผูกกลับไปรหัสงานเดิมได้ เมื่องานล้มเหลวถาวรจะได้แยกจากงานที่ผ่านหลังรอ และเห็นว่านโยบายกำลังช่วยงานกลุ่มไหนอยู่
การลองในสภาพแวดล้อมทดสอบอาจจำลองทั้งการตอบช้า การปฏิเสธข้อมูล การเชื่อมต่อขาดหลังรับคำขอ และคำตอบที่ให้รอก่อนลองใหม่ จากนั้นตรวจจำนวนคำขอจริงที่ปลายทางได้รับด้วย จะช่วยจับการลองซ้ำที่ซ่อนอยู่หลายชั้นได้ แนวทางนี้ยังเป็นวิธีตรวจ ไม่ใช่ผลวัดของระบบที่นำมาอ้างว่าใช้นโยบายใดดีที่สุดแล้ว
เมื่อครบเวลาหรือครบครั้งที่อนุญาต งานต้องมีทางไปต่อที่ชัด เช่น คืนข้อผิดพลาดที่ผู้เรียกจัดการได้ พักไว้รอผู้ดูแล หรือบันทึกเพื่อกลับมาตรวจผลภายหลัง การหยุด retry จึงเป็นส่วนหนึ่งของการจัดการงาน ไม่ใช่ปล่อยให้รายการนั้นหายไปจากสายตา
จำนวน retry ที่เหมาะสมต้องดูร่วมกับเวลารวม ชนิดข้อผิดพลาด และผลที่จะเกิดจากการส่งซ้ำ เมื่อกำหนดผู้รับผิดชอบการลองใหม่ให้ชัด เว้นจังหวะตามสภาพบริการ และมีทางจัดการเมื่อหยุดแล้ว ก็จะช่วยให้งานผ่านปัญหาชั่วคราวได้โดยยังควบคุมเวลารอและจำนวนคำขอที่ระบบสร้างขึ้น