


พอเว็บเริ่มมีบทความหลายเรื่อง นอกจากอยากรู้ว่าคนอ่านเข้ามาจากที่ไหน ก็มีอีกคำถามที่น่าสนใจคือมีบอทตัวไหนเข้ามาเก็บเนื้อหาไปแล้วบ้าง บางตัวอาจมาหาหน้าสำหรับระบบค้นหา บางตัวเข้ามาสร้างตัวอย่างลิงก์ และบางครั้งก็เป็นบริการที่เปิดหน้าตามคำขอของผู้ใช้ในเวลานั้น
ถ้าอยากศึกษาจริงๆ การเห็นชื่อบอทในหน้าสถิติยังไม่พอจะตอบว่ามันเข้ามาอ่านบทความไหน เมื่อไร และได้รับเนื้อหาฉบับใดกลับไป เพราะข้อมูลแต่ละแหล่งมองเห็นคนละช่วงของการเข้าถึง และชื่อที่คำขอส่งมาก็ยังอาจต้องตรวจยืนยันอีกชั้น
แอดเลยอยากเริ่มจากวางหลักฐานที่จะเก็บให้ชัดก่อนครับ เรื่องนี้ยังเป็นแนวทางออกแบบการศึกษา ไม่ใช่รายงานว่าตรวจพบบอทใดบน CommandEng แล้ว การแยกขอบเขตไว้ตั้งแต่ต้นจะช่วยให้เมื่อมีข้อมูลจริง เราตอบได้ตามสิ่งที่เห็นโดยไม่สรุปเกินจาก request ที่บันทึกไว้
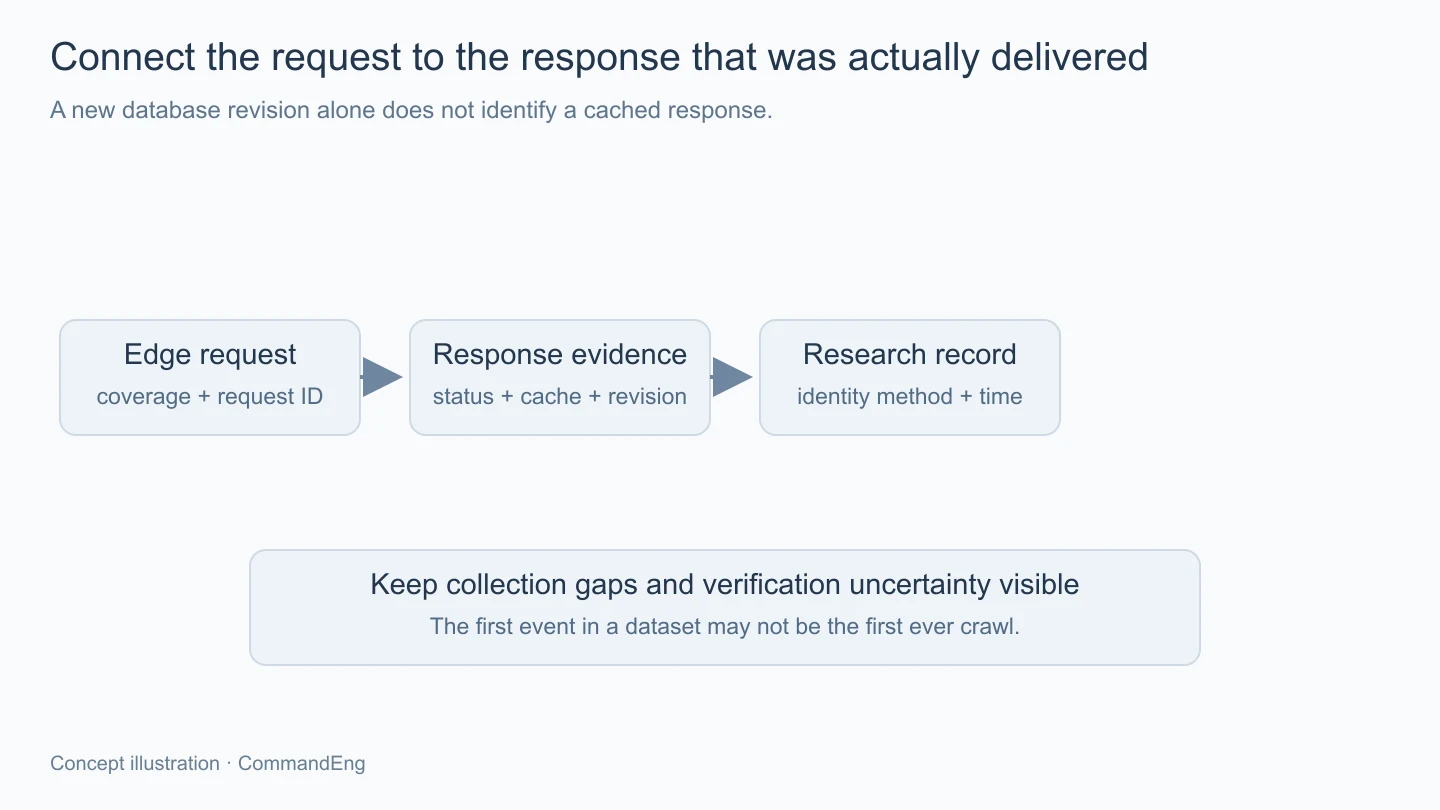
คำถามอย่างบทความนี้ได้รับคำขอจากบอทครั้งแรกเมื่อไร สามารถเริ่มตอบจาก access log ที่มี URL กับเวลา แต่ต้องรู้ก่อนว่า log เริ่มเก็บวันไหน ถ้าเริ่มหลังบทความเผยแพร่ไปนานแล้ว เหตุการณ์แรกที่เจอจะเป็นครั้งแรกในชุดข้อมูล ไม่ใช่หลักฐานว่าบอทเพิ่งค้นพบหน้านั้นเป็นครั้งแรกจริงๆ
ส่วนคำถามว่ากลับมาถี่แค่ไหน ต้องใช้หลายเหตุการณ์ในช่วงเวลาที่ต่อเนื่องกัน พร้อมตรวจว่ามีข้อมูลขาดระหว่างทางหรือไม่ การหายไปจาก log หนึ่งช่วงอาจเกิดจากไม่มีคำขอ หรือเกิดจากหมดระยะเก็บข้อมูล เปลี่ยนระบบ และการสุ่มเก็บเพียงบาง request ก็ได้
อีกคำถามคือได้รับเนื้อหาฉบับใหม่หลังแก้หรือยัง ตรงนี้ต้องผูกเวลาของ request เข้ากับฉบับที่ระบบส่งออกจริงด้วย การรู้เพียงเวลาแก้ในฐานข้อมูลยังไม่พอ เพราะผลที่ตอบผ่าน cache อาจเป็นฉบับก่อนหน้าอยู่
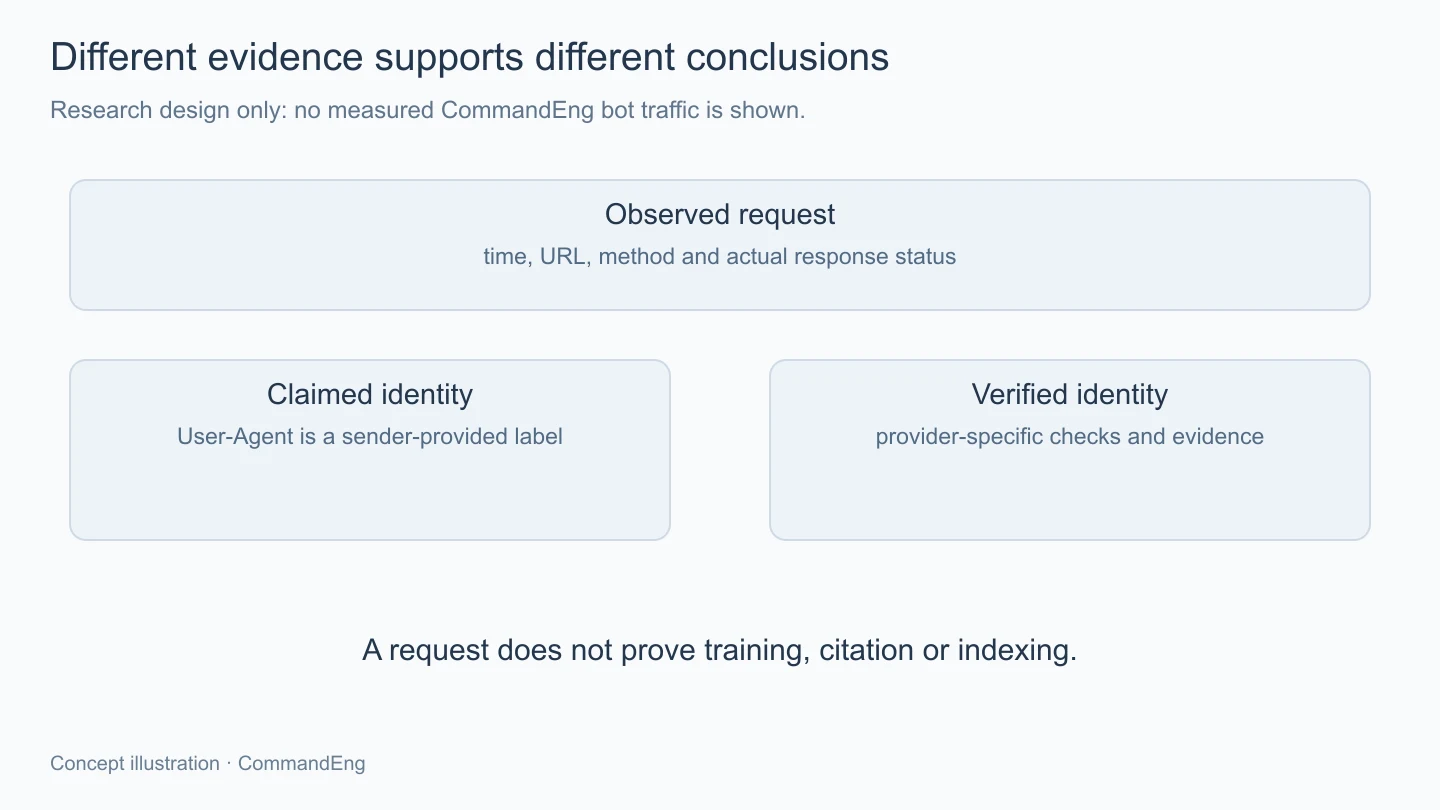
และถึงจะยืนยันได้ว่ามีการขอหน้าและรับข้อมูลกลับไป ก็ยังไม่ใช่หลักฐานว่าถูกนำไปฝึกโมเดล ถูกอ้างในคำตอบ หรือถูกนำเข้า index แล้ว คำถามเหล่านี้ต้องใช้หลักฐานจากอีกฝั่งเพิ่มเติม การแยกการเข้าถึงออกจากการใช้เนื้อหาจึงเป็นเงื่อนไขสำคัญของการอ่านผล
เว็บที่มี CDN อาจตอบไฟล์จากข้างหน้าได้โดยไม่เรียกกลับมาถึงแอปทุกครั้ง หากเก็บเฉพาะ log ของแอป ก็จะเห็นเพียงคำขอที่ผ่านเข้ามาถึงจุดนั้น ส่วน request ที่ตอบจาก cache ข้างหน้าอาจไม่ปรากฏในชุดเดียวกัน
จึงควรทำแผนเส้นทางก่อนว่า browser หรือบอทเข้ามาที่ CDN แล้วผ่าน reverse proxy หรือไปหาแอปอย่างไร จากนั้นเลือกข้อมูลที่ครอบคลุมคำถาม เช่น edge request สำหรับการเข้าถึงที่ขอบระบบ และ origin log สำหรับการประมวลผลที่มาถึงหลังบ้านจริง
เครื่องมืออย่าง NGINX มี access log ที่กำหนดรูปแบบข้อมูลได้ ส่วนแพลตฟอร์มที่ให้บริการ CDN หรือโฮสต์เว็บอาจมีข้อมูล request และการจำแนกบอทให้ใช้ แต่ต้องตรวจสิ่งที่บัญชีนั้นเข้าถึงได้จริง ระยะเวลาเก็บ และการสุ่มข้อมูลก่อน ไม่ควรถือว่าชื่อเมนูที่มีคำว่า traffic จะให้ log ครบทุกเหตุการณ์เสมอ
หากเก็บหลายชั้น ต้องมีวิธีจับคู่ request เช่น request ID ที่ส่งต่ออย่างถูกต้อง เพื่อไม่ให้นับ edge กับ origin ของคำขอเดียวกันเป็นสองการเข้าชม ในทางกลับกันก็ต้องรักษาข้อมูลไว้ว่าขั้นไหนตอบเองจาก cache เพื่ออธิบายว่าทำไมจึงไม่มีเหตุการณ์คู่กันที่แอป
User-Agent ช่วยบอกว่าคำขอนั้นอ้างตัวเป็นอะไร แต่ผู้ส่งสามารถกำหนดข้อความนี้ได้ จึงไม่ควรยืนยันชื่อผู้ให้บริการจากการค้นคำว่า Googlebot หรือชื่อบอทอื่นในข้อความอย่างเดียว
สำหรับ Google มีเอกสารวิธีตรวจทั้งการเทียบ IP กับช่วงที่ประกาศ และการตรวจ reverse DNS แล้วตรวจ forward DNS กลับให้ตรง IP เดิม โดยต้องใช้เงื่อนไขโดเมนที่ถูกต้องตามประเภท crawler หรือ fetcher ด้วย การพบคำว่า google อยู่กลาง hostname อย่างเดียวไม่ได้เท่ากับผ่านการตรวจตามวิธีนี้
ผู้ให้บริการแต่ละรายอาจมีวิธีประกาศและยืนยันต่างกัน หากใช้ข้อมูล verified bot จากผู้ให้บริการ CDN ก็ควรบันทึกด้วยว่าใครเป็นผู้จัดประเภทและใช้ข้อมูลรุ่นใด ไม่รวมทุกผลให้กลายเป็นการตรวจของเว็บเราเองโดยไม่อธิบายที่มา
ในชุดข้อมูลจึงอาจมีสถานะอ้างตัว ยังไม่ตรวจ ตรวจยืนยันแล้ว และยังระบุไม่ได้ เพื่อไม่บังคับให้ทุก request ต้องมีชื่อเจ้าของที่แน่นอน รายการที่ตรวจไม่ผ่านก็ไม่จำเป็นต้องเดาต่อว่าเป็นใคร เพียงรักษาความต่างระหว่างคำกล่าวอ้างกับผลที่ตรวจได้ไว้
ข้อมูลพื้นฐานควรมีเวลาและ timezone, host, path, method, status, User-Agent และจุดที่เก็บ log ส่วน IP ที่ใช้ยืนยันตัวตนต้องได้มาจากเส้นทาง proxy ที่เชื่อถือได้ ถ้าแอปเห็นเพียง IP ของ proxy ก็ต้องแก้ความเข้าใจของข้อมูลก่อนนำไปตรวจว่าเป็นบอทใด
สำหรับการศึกษาการกลับมาอ่านฉบับใหม่ ควรเพิ่มรหัสฉบับของบทความหรือค่าอ้างอิง response ที่ตามย้อนกลับได้ โดยตรวจด้วยว่ารหัสนั้นตรงกับเนื้อหาที่ตอบจริง ไม่ใช่หยิบ revision ล่าสุดจากฐานมาแนบกับ cache ฉบับเก่า
Status ก็มีความหมายต่างกัน เช่น 200 บอกว่าคำขอสำเร็จตามความหมายของ HTTP แต่ไม่ได้บอกว่าปลายทางนำเนื้อหาไปใช้อย่างไร ส่วน 304 เป็นการยืนยันการใช้ฉบับที่ผู้เรียกมีอยู่ตามเงื่อนไข ไม่ใช่การส่ง body บทความฉบับเต็มใหม่ใน response นั้น และ HEAD ก็ไม่ควรถูกนับเหมือน GET ที่รับ body กลับไป
Query string บางชนิดทำให้เกิด URL หลายแบบของหน้าเดียวกันได้ จึงควรเก็บทั้ง URL ที่ร้องขอและกติกาที่ใช้รวมเป็นบทความเดียว โดยตัดข้อมูลละเอียดอ่อนที่ไม่จำเป็นออกก่อน การเก็บ token หรือข้อมูลผู้ใช้ไปพร้อม URL ทุกอันไม่ได้ทำให้การศึกษาบอทแม่นขึ้น
เริ่มจากช่วงเวลาที่เก็บข้อมูลต่อเนื่องได้ และเลือกบทความกลุ่มที่มีวันที่เผยแพร่กับประวัติแก้ไขชัดเจน จากนั้นแยก request ของผู้ดูแล เครื่องมือทดสอบสุขภาพ และการตรวจเว็บของเราเองออกจากกลุ่มที่จะศึกษา เพื่อไม่ให้การทดสอบสร้างภาพว่ามีบอทมาอ่านถี่ขึ้น
ผลที่นำเสนอควรบอกช่วงเวลา แหล่ง log ระดับความครบ และเกณฑ์ยืนยันตัวตนควบคู่กับตัวเลขเสมอ หากยังไม่มี log ย้อนหลัง ก็เริ่มบอกได้ว่าเก็บตั้งแต่วันใด แทนการสร้างตารางย้อนหลังจากวันที่เผยแพร่บทความ
ข้อมูล IP และรายละเอียด request ควรจำกัดสิทธิ์กับระยะเก็บตามความจำเป็น ส่วนรายงานที่แชร์ออกไปใช้ข้อมูลรวม หรือปกปิดรายละเอียดที่ไม่จำเป็นได้ การตรวจยืนยันควรทำในส่วนที่ควบคุมการเข้าถึง แล้วเผยแพร่เฉพาะผลที่อธิบายคำถามของงานวิจัย
การรู้ว่าบอทใดเข้ามาที่บทความต้องอาศัยทั้ง log ที่ครอบคลุมเส้นทาง การตรวจตัวตน และข้อมูลของฉบับที่ตอบกลับ เมื่อวางสามส่วนนี้ให้เชื่อมกันได้ เราจะศึกษาช่วงเวลาและรูปแบบการกลับมาได้จากหลักฐานจริง พร้อมบอกข้อจำกัดของข้อมูลได้ชัด ส่วนการถูกนำเนื้อหาไปใช้ต่อในระบบใดยังคงเป็นอีกคำถามที่ request อย่างเดียวตอบแทนไม่ได้