


เว็บบทความมักมีข้อมูลชื่อเรื่อง ผู้เขียน วันเผยแพร่ และภาพอยู่ในฐานเดียวกันอยู่แล้ว พออยากอธิบายหน้าให้ระบบค้นหา เราก็สามารถนำข้อมูลชุดนั้นมาสร้าง Article structured data เพิ่มได้ โดยไม่ต้องให้คนเขียนกรอกซ้ำทุกช่อง
แต่การสร้าง JSON ที่อ่านได้ยังเป็นเพียงส่วนหนึ่งครับ สิ่งที่สำคัญต่อมาคือข้อมูลนั้นกำลังอธิบายบทความที่คนเห็นจริงหรือไม่ ทั้งชื่อ บุคคลที่รับผิดชอบ ภาพ และวันที่ ไม่ให้หน้าเว็บกับ metadata เล่าคนละฉบับ
ก่อนมองหารูปแบบผลค้นหาที่อยากได้ จึงควรเริ่มจากจัดข้อมูลของหน้าให้ตรงกัน แล้วใช้เครื่องมือตรวจตามหน้าที่ของมัน
Article เป็นกลุ่มชนิดข้อมูลที่ใช้อธิบายบทความ โดยมีชนิดที่เฉพาะขึ้นอย่าง BlogPosting ให้เลือกตามลักษณะเนื้อหา จุดเริ่มคือเลือกสิ่งที่ตรงกับหน้าจริง ไม่เปลี่ยนบทเล่าทั่วไปให้เป็นข่าวเพียงเพราะอยากได้ผลแสดงบางแบบ
ข้อมูลควรเป็นตัวแทนของเนื้อหาที่คนอ่านเข้าถึงได้ หากหน้าไม่มีผู้เขียนตามที่อ้าง หรือภาพใน markup เป็นของที่ไม่เกี่ยวกับเรื่อง ความครบของรูปแบบก็ไม่ได้ทำให้ความหมายถูกขึ้น
สำหรับเว็บที่มีหลาย template ต้องรู้ว่า structured data อธิบายหน้าบทความหรือหน้ารวม การนำค่าของบทแรกในรายการไปใส่ให้หน้าคลังทั้งหมดอาจทำให้ระบบได้รับข้อมูลที่ไม่ตรงหน้าที่ของ URL นั้น
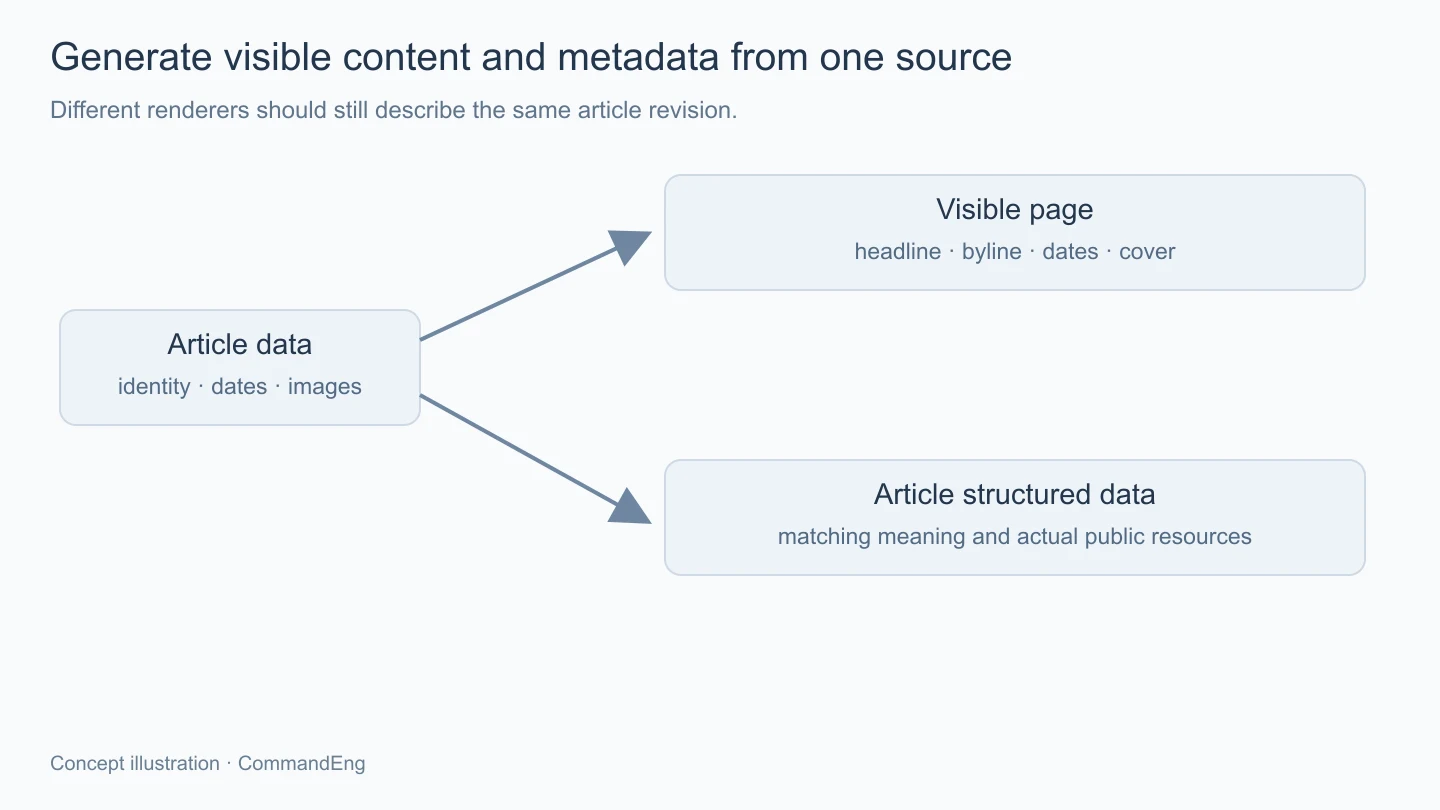
แนวทางที่ดูแลง่ายคือสร้างข้อมูลจากแหล่งเดียวกับส่วนที่แสดงให้คนอ่าน แล้วกำหนดการแปลงตามชนิดหน้า ไม่เก็บ JSON อีกชุดที่ต้องแก้ตามมือหลังเปลี่ยนชื่อหรือภาพทุกครั้ง
headline ควรตรงกับชื่อบทความที่อธิบายอยู่ ส่วน author ต้องเป็นคนหรือองค์กรที่เป็นผู้เขียนตามจริง ไม่หยิบชื่อผู้ดูแลระบบหรือบัญชีที่กดเผยแพร่มาแทนโดยไม่ดูบทบาท
หากเว็บแสดงหลายผู้เขียน ก็ควรส่งข้อมูลแต่ละรายแยกตามโครงที่รองรับ ไม่รวมชื่อทั้งหมดเป็นข้อความก้อนเดียวจนดูเหมือนบุคคลหนึ่ง และหากมีหน้าโปรไฟล์จริงก็สามารถใช้ URL นั้นช่วยระบุตัวตนได้
ชื่อในช่องผู้เขียนควรเป็นชื่อของผู้เขียนเอง ไม่เติมคำว่าเขียนโดย ตำแหน่ง หรือข้อความโฆษณารวมไปในชื่อ เพราะข้อมูลชนิดอื่นมีหน้าที่ของมัน และสิ่งที่แสดงในหน้าอาจจัดวางคำประกอบต่างจากค่าที่เป็นตัวตน
ถ้ายังไม่รู้ข้อมูลบางส่วน ควรแก้เรื่องแหล่งที่มาและความรับผิดชอบก่อน ไม่สร้างโปรไฟล์หรือประวัติผู้เขียนขึ้นมาเพื่อให้ช่องดูครบ การมีข้อมูลที่ตรงกับหน้าและตรวจได้เป็นฐานสำคัญกว่าจำนวน property
datePublished กับ dateModified มีความหมายต่างกัน จึงควรใช้วันเผยแพร่กับวันแก้เนื้อหาตามที่ระบบบันทึกไว้อย่างมีนโยบาย ไม่เปลี่ยนทุกบทเป็นวันปัจจุบันเพียงเพราะมีการบิ้วเว็บไซต์ใหม่
ระบุ timezone เมื่อส่งเวลา และเทียบกับวันที่คนเห็นบนหน้าด้วย ถ้าจุดหนึ่งแปลงเป็น UTC แต่อีกจุดจัดวันตามเวลาไทย การแสดงวันอาจคลาดกันได้แม้เริ่มจาก timestamp เดียวกัน จึงต้องตรวจรูปแบบการแปลงไม่ใช่แก้ข้อมูลต้นทางด้วยการบวกวันเอง
วันเหตุการณ์ในเนื้อหา เช่น วันเปิดตัวผลิตภัณฑ์ ไม่ใช่วันเผยแพร่บทความโดยอัตโนมัติ หากหน้าเล่าข่าวเก่าหรือมีลำดับเวลาของโครงการ ต้องรักษาชื่อฟิลด์ให้ตรงกับสิ่งที่กำลังอธิบาย ไม่หยิบวันที่เด่นที่สุดในบทมาใช้แทน
เมื่อแก้ข้อความเล็กน้อยหรือมีงานระบบที่ไม่ได้เปลี่ยนตัวบท ก็ควรใช้กติกาเดียวกับวันที่อัปเดตที่แสดงจริง เพื่อให้ metadata ไม่บอกว่าบทเพิ่งปรับเนื้อหาสำคัญทั้งที่เปลี่ยนเพียงส่วนทั่วไปของเว็บไซต์
ภาพที่ระบุควรเกี่ยวกับเนื้อหาบทความและเป็น URL ที่ระบบเข้าถึงได้ ไม่ชี้ไฟล์ชั่วคราวของ preview หรือภาพที่ต้องใช้ session ของผู้ดูแล การเห็นภาพในหน้าที่เราล็อกอินไม่ได้พิสูจน์ว่าทางสาธารณะเปิดได้เหมือนกัน
หากสร้างหลายอัตราส่วนสำหรับตำแหน่งแสดง ควรตรวจว่าทุกไฟล์ยังแทนเรื่องเดียวกันและไม่ตัดส่วนสำคัญออกโดยไม่ตั้งใจ ส่วนโลโก้ทั่วไปของเว็บก็ไม่จำเป็นต้องทำหน้าที่แทนภาพของทุกบทเหมือนกันทั้งหมด
การตรวจ URL ภาพควรมีทั้งสถานะตอบกลับกับชนิดไฟล์ และถ้ามี CDN หรือการแปลงรูปให้ดูปลายทางที่ markup ส่งจริงด้วย บางครั้งเปลี่ยนภาพบนหน้าแล้วแต่ structured data ยังคง URL เก่าไว้เพราะสร้างคนละขั้น
ตัวอย่าง JSON-LD สมมติสำหรับเว็บตัวอย่าง ซึ่งต้องปรับข้อมูลและตรวจหน้าเองก่อนใช้:
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "เริ่มอ่านสถานะอุปกรณ์จาก MQTT",
  "image": ["https://example.com/images/mqtt-cover.webp"],
  "datePublished": "2026-07-10T10:00:00+07:00",
  "author": {
    "@type": "Organization",
    "name": "Example Lab",
    "url": "https://example.com/about"
  }
}
ตัวอย่างเลือก author เป็นองค์กรตามสถานการณ์สมมตินั้น ไม่ใช่กติกาว่าเว็บทุกแห่งควรใช้ Organization และไม่ได้แสดงทุก property ที่อาจเหมาะกับหน้าจริง ควรอ่านแนวทางของชนิดข้อมูลที่เลือกแล้วเพิ่มเฉพาะสิ่งที่มีข้อมูลรองรับ
ถ้าสร้างผ่านโค้ด ให้ serialize และแทรกในหน้าอย่างถูกต้องตามระบบที่ใช้ ไม่ต่อข้อความจากชื่อหรือเนื้อหาลงใน script แบบไม่จัดการอักขระ เพราะข้อมูลที่มีเครื่องหมายพิเศษต้องยังเป็นข้อมูล ไม่หลุดไปเปลี่ยนโครง HTML ที่ครอบอยู่
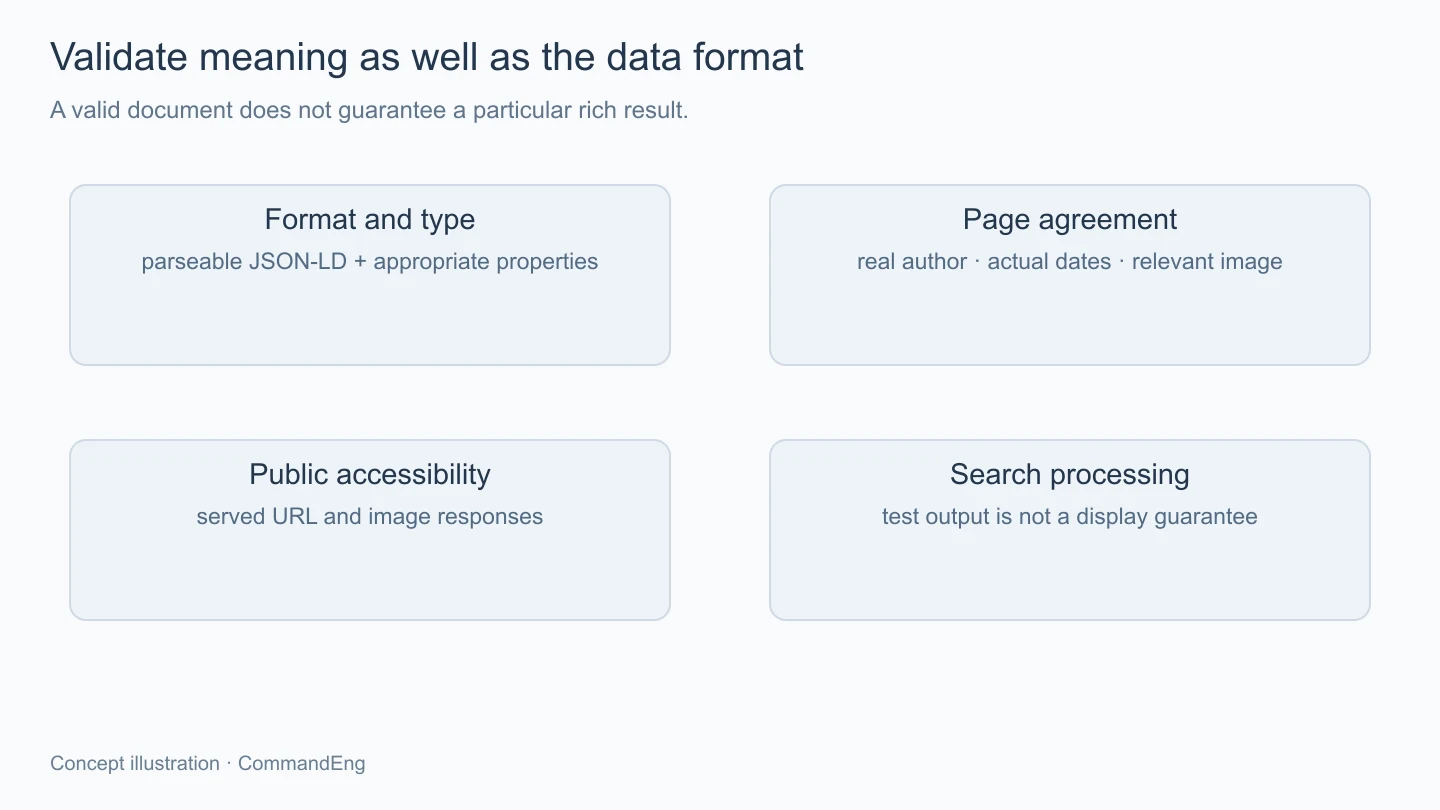
ใช้ Rich Results Test ดูปัญหาที่เครื่องมือรายงานได้ แล้วอ่าน markup คู่กับหน้าสาธารณะอีกครั้ง ตรวจชื่อ ผู้เขียน วัน และภาพอย่างตรงไปตรงมา เพราะตัวตรวจไม่สามารถรู้ทุกกรณีว่าข้อมูลที่กรอกเป็นข้อเท็จจริงของบทนั้นหรือไม่
หลังเผยแพร่ให้ดูผลที่ส่งออกจาก URL จริง รวมถึงแคชและคำตอบที่ระบบอ่านได้ การตรวจเฉพาะโค้ดตัวอย่างผ่านไม่ได้รับรองว่า template ตอนใช้งานสร้างข้อมูลครบแบบเดียวกันทุกบท
และถึง markup ถูกต้อง ก็ยังไม่ได้รับรองว่าจะมี rich result ในรูปแบบที่ต้องการหรืออันดับดีขึ้นตามจำนวนฟิลด์ การวางข้อมูลให้ตรงหน้าช่วยให้ระบบเข้าใจได้ชัดขึ้น ส่วนการเลือกแสดงเป็นอีกขั้นที่ต้องแยกจากการตรวจ syntax
Article structured data ควรเป็นคำอธิบายบทความฉบับเดียวกับที่คนอ่านเห็น ใช้ข้อมูลต้นทางร่วมกัน แยกความหมายของผู้เขียนกับบัญชีเผยแพร่ และรักษาวันกับภาพให้ตรง เมื่อผ่านทั้งการตรวจรูปแบบและการอ่านเทียบหน้าจริง เราจะได้ metadata ที่ดูแลต่อได้โดยไม่ต้องสร้างข้อมูลเพิ่มเพียงเพื่อหวังรูปแบบผลค้นหาครับ