


ระบบเล็กๆ ที่รันด้วย Compose อาจมีเว็บ ฐานข้อมูล และคิวอยู่ในไฟล์เดียวกัน ตอนเริ่มทุกอย่างพร้อมกัน แอปเว็บมีโอกาสเปิดขึ้นมาก่อนฐานข้อมูลพร้อมรับคำขอ จึงเกิดอาการรอบแรกเชื่อมไม่ผ่าน แต่สั่งเริ่มเว็บใหม่ภายหลังกลับใช้งานได้
การจัดลำดับเริ่มช่วยแก้เงื่อนไขช่วงนี้ได้ แต่ยังต้องดูว่าระบบต้องการรอถึงสถานะไหน เพราะ container ที่เริ่ม process แล้วกับฐานข้อมูลที่พร้อมทำงานเป็นคนละช่วง และหลังจากทุกตัวเริ่มครบ dependency ก็ยังมีโอกาสหยุดหรือเปลี่ยน connection อีกได้
จึงควรแยกเรื่องการเริ่มระบบกับการดูแลระหว่างรันครับ depends_on ช่วยกำหนดความสัมพันธ์ตอน Compose จัดการบริการ ส่วนการเชื่อมต่อใหม่และสถานะงานเมื่อบริการหายกลางทางยังเป็นส่วนที่แอปต้องมีวิธีรับมือด้วย
การระบุ dependency แบบรอให้ service เริ่มทำงาน ช่วยจัดลำดับสร้างและเริ่ม container แต่ไม่ได้รู้รายละเอียดภายในทุกแอป เช่น ฐานข้อมูลอาจเปิด process แล้วกำลังกู้ข้อมูล หรือบริการค้นหาอาจเริ่มแล้วแต่ยังโหลดข้อมูลไม่ครบ
Compose รองรับเงื่อนไขอย่าง service_healthy เพื่อรอ healthcheck ของ dependency และ service_completed_successfully สำหรับงานที่ต้องจบสำเร็จก่อน ส่วน service_started มีความหมายเรื่องเริ่มทำงาน จึงควรเลือกตามสิ่งที่บริการปลายทางต้องใช้จริง
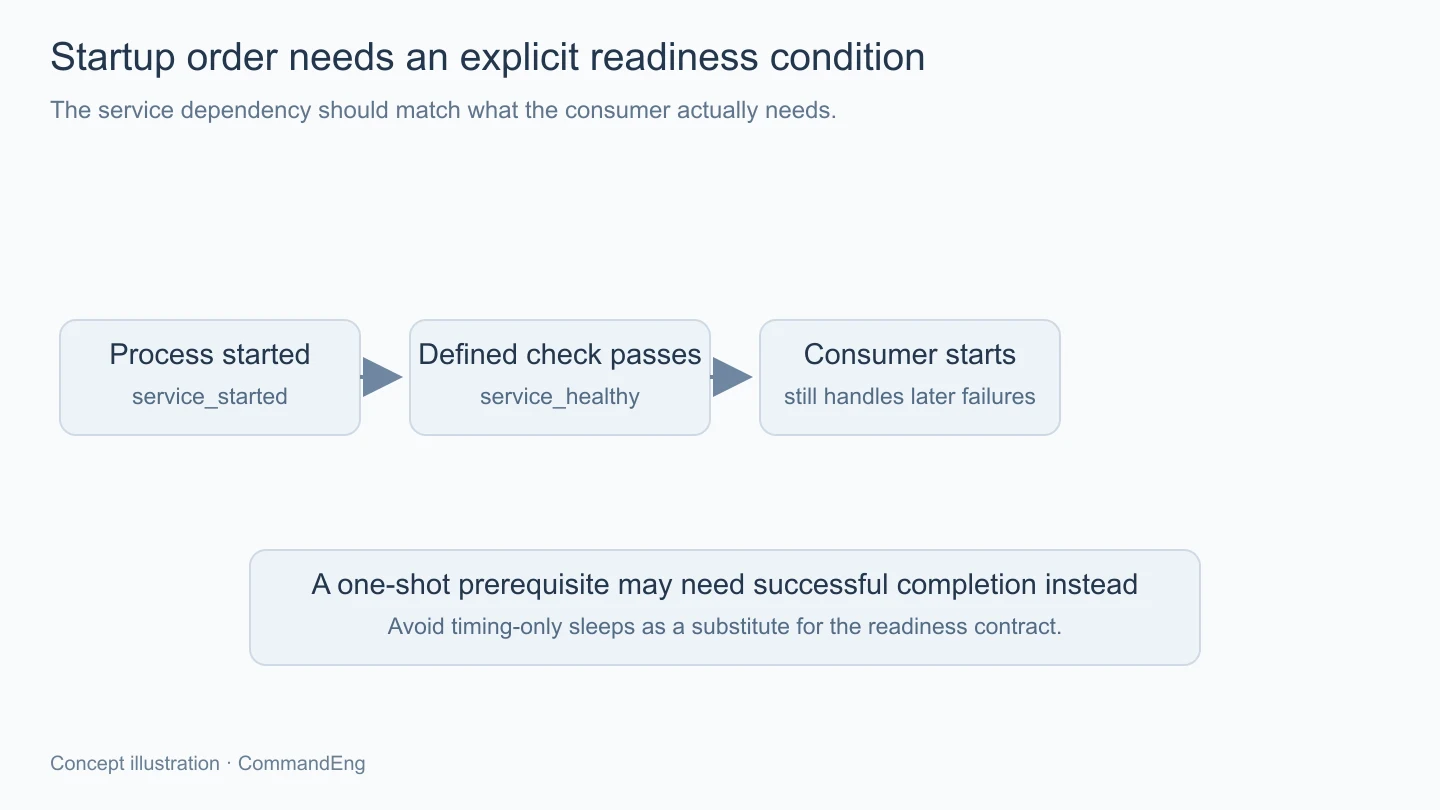
การเลือก service_healthy จึงต้องมี healthcheck ที่นิยามถูกด้วย หากตรวจเพียงว่าพอร์ตเปิด ก็อาจผ่านก่อนส่วนที่แอปต้องใช้พร้อม แต่ถ้าตรวจทุกบริการภายนอกที่ฐานข้อมูลไม่จำเป็นต้องพึ่ง ก็อาจกันการเริ่มทั้งระบบเกินความจำเป็น
จุดตรวจควรตอบคำถามที่เฉพาะกับ dependency นี้ เช่น พร้อมรับการเชื่อมต่อที่ต้องใช้แล้วหรือยัง ไม่ใช่ใช้ชื่อ healthy เป็นคำรับรองว่าทุกธุรกรรมของระบบจะสำเร็จหลังจากนั้นได้ตลอด
ลองสมมติมี service ชื่อ app กับ db ที่ app ต้องใช้ฐานข้อมูล ส่วนของการตั้ง dependency อาจเขียนเป็น fragment ได้ดังนี้ โดย db ต้องมี healthcheck ที่เหมาะสมอยู่ในนิยามของตัวเอง และตัวอย่างนี้ยังไม่ใช่ Compose file ครบชุดที่จะนำไปรันได้ทันที
services:
  app:
    depends_on:
      db:
        condition: service_healthy
ก่อนเพิ่ม dependency ควรตรวจด้วยว่ามันจำเป็นต่อการเริ่มแอปจริงหรือเปล่า หากบริการแจ้งเตือนมีปัญหาแต่เว็บยังเปิดอ่านข้อมูลได้ การบังคับรอส่วนแจ้งเตือนทุกครั้งอาจทำให้ส่วนที่ยังใช้ได้ถูกหยุดไปด้วย
ขณะที่งานเตรียมข้อมูลบางอย่างอาจต้องทำให้เสร็จก่อนรับคำขอ กรณีนี้ต้องแยก job ที่มีจุดจบกับบริการที่รันยาวให้ชัด รวมถึงวิธีป้องกันการเตรียมข้อมูลซ้ำหากมีการสั่งเริ่มหลายครั้ง ไม่ใช้เพียงลำดับ startup แทนการควบคุมการทำงานพร้อมกันทั้งหมด
หากสร้าง dependency วนกันจนแต่ละตัวรออีกตัว ก็ต้องกลับไปดูขอบเขตหน้าที่ของระบบ การใส่เวลาหน่วงเพิ่มให้บังเอิญเริ่มผ่านอาจซ่อนความสัมพันธ์ที่ยังนิยามไม่ลงตัว และทำให้ผลต่างออกไปเมื่อเครื่องช้าหรือข้อมูลมากขึ้น
หลังแอปเชื่อมฐานข้อมูลสำเร็จ การหยุดฐานข้อมูลหรือสร้าง container ใหม่อาจทำให้ connection เก่าถูกตัด แอปจึงต้องรู้ว่า connection ใช้ต่อไม่ได้และมีวิธีเชื่อมใหม่ตามไลบรารีที่ใช้ ไม่ถือว่า depends_on จะตามซ่อมทุก connection ภายในโปรแกรมให้
Healthcheck ที่ยังตรวจต่อได้ก็เป็นข้อมูลสถานะ แต่ไม่ใช่ระบบประสานธุรกรรมที่กำลังทำอยู่ หากคำขอถูกส่งไปแล้วแต่ยังไม่ได้คำตอบก่อน connection หาย ยังต้องตรวจผลหรือใช้กลไกป้องกันการทำซ้ำตามความหมายของคำขอนั้น
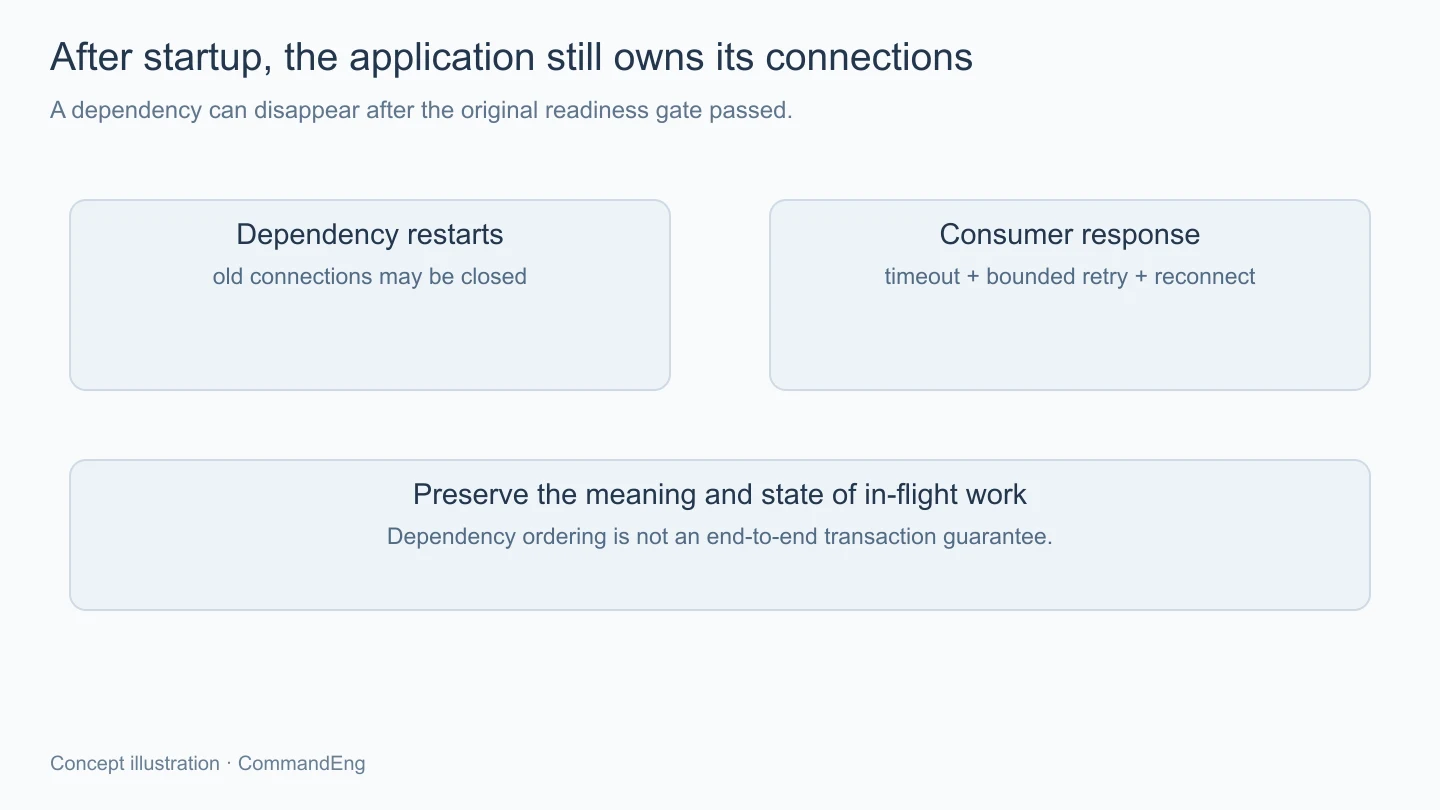
การรับมือในแอปอาจมีทั้ง timeout การจำกัดจำนวนงานที่รอ การเชื่อมใหม่ และการคืนสถานะให้ผู้เรียกเข้าใจ ขอบเขตขึ้นกับงาน เช่น หน้าอ่านข้อมูลอาจแสดงว่ายังไม่พร้อม ส่วนงานเบื้องหลังอาจพักไว้แล้วกลับมาทำต่อโดยรักษารหัสงานเดิม
สิ่งที่ไม่ควรเกิดคือให้ทุกส่วนค้างโดยไม่มีกำหนด หรือปล่อยให้คำขอเพิ่มขึ้นเรื่อยๆ จนทรัพยากรหมด การทดสอบ startup อย่างเดียวจะยังไม่เห็นพฤติกรรมช่วงนี้ จึงต้องมีกรณี dependency หายหลังเริ่มระบบผ่านด้วย
Compose มีตัวเลือก restart ภายใต้รูปแบบ dependency แบบยาว ซึ่งใช้กับการจัดการ dependency ผ่านคำสั่ง Compose ตามเงื่อนไขในเอกสาร ต้องแยกจาก restart policy ระดับ service ที่บอกพฤติกรรมเมื่อ container ออกจากการทำงาน
จึงไม่ควรอ่านว่าเปิด restart ใน depends_on แล้วทุกครั้งที่ฐานข้อมูลหลุดหรือถูก runtime restart เว็บจะถูกดูแลตามกันทั้งหมดโดยอัตโนมัติ ต้องตรวจว่าเหตุการณ์ใดถูกครอบคลุมและ Compose รุ่นที่ใช้รองรับตัวเลือกนั้นอย่างไร
ในงานที่ยังไม่จำเป็นต้องผูกการเริ่มใหม่ตามกัน การให้แอปตรวจ connection แล้วกู้คืนอาจตรงจุดกว่า ส่วนการ restart ทั้งบริการเป็นทางเลือกที่ต้องเข้าใจผลต่องานค้างและผู้ใช้ ไม่ใช้แทนการจัดการข้อผิดพลาดทุกชนิดในโค้ด
เมื่อจะเปลี่ยนค่าพวกนี้ ควรอ่าน configuration ที่ Compose resolve แล้วด้วย เพราะการรวมหลายไฟล์หรือ override ตาม environment อาจเปลี่ยนเงื่อนไขจากไฟล์ที่กำลังเปิดดูอยู่ การยืนยันจาก container ที่สร้างจริงช่วยป้องกันการวินิจฉัยจากไฟล์คนละฉบับ
เริ่มจากระบบทดสอบที่มีข้อมูลแยก แล้วทำให้ dependency ใช้เวลาเตรียมตัวต่างกัน ดูว่า app ถูกเริ่มเมื่อไรและ healthcheck ให้ความหมายตรงช่วงที่พร้อมจริงหรือไม่ การหน่วงใน fixture ใช้ตรวจกลไก ไม่ใช่ตัวเลขประสิทธิภาพของเครื่องจริง
จากนั้นหยุด dependency หลัง app รับงานได้แล้ว แล้วตรวจคำขอที่กำลังทำ คำขอใหม่ และการกลับมาหลัง dependency พร้อมอีกครั้ง ต้องรู้ว่างานใดสำเร็จ งานใดยังยืนยันผลไม่ได้ และมีการสร้างผลซ้ำจาก retry หรือไม่
ควรตรวจการ shutdown ด้วย เพราะลำดับหยุดช่วยลดช่วงที่แอปยังพยายามใช้ dependency ที่กำลังถูกเอาออก แต่แอปยังต้องรับสัญญาณหยุดและปิดงานตามที่ออกแบบไว้ การมีลำดับอย่างเดียวไม่ได้ทำให้งานที่ยังเปิดอยู่จบอย่างถูกต้องเอง
ผลที่ควรเก็บเป็นเวลา สถานะบริการ และผลของงานทดสอบ โดยระบุรุ่น Compose กับ configuration ที่ใช้จริง บทนี้ยังไม่ใช่ผลทดสอบ startup ของเครื่อง Homelab ผู้ใช้ จึงไม่ระบุว่าฐานข้อมูลใดพร้อมในกี่วินาที
depends_on ควรใช้กำหนดลำดับและเงื่อนไขเริ่มให้ตรงความพร้อมที่แอปต้องใช้ ส่วนการเชื่อมต่อและงานที่ค้างเมื่อ dependency หายยังต้องดูแลในแอป เมื่อทดสอบทั้งช่วงเริ่ม ระหว่างรัน และตอนหยุด เราจะรู้ว่าระบบพร้อมใช้งานอย่างไรตลอดวงจร มากกว่าผ่านเพียงการเปิด container ครั้งแรก