


เมื่อเว็บรับงานมากขึ้น การเพิ่ม replica ของแอปช่วยแบ่งงานได้บางส่วน แต่แอปแต่ละตัวก็อาจมี connection pool สำหรับต่อฐานข้อมูลของตัวเองตามไปด้วย ถ้าเพิ่มจำนวนฝั่งเว็บโดยไม่ดูเพดานรวม ปัญหาที่เห็นภายหลังอาจกลายเป็นเปิด connection ใหม่ไม่ได้ ทั้งที่แต่ละ process ยังตั้ง pool ไว้ไม่ใหญ่
จุดที่ต้องมองเพิ่มคือฐานข้อมูลรับการเชื่อมต่อจากทุกฝ่ายร่วมกัน ทั้งเว็บ worker งานตามเวลา และเครื่องมือของผู้ดูแล จำนวน connection จึงเป็นทรัพยากรของทั้งระบบ ไม่ใช่ค่าที่บริการใดบริการหนึ่งกำหนดจากความต้องการของตัวเองล้วนๆ
ก่อนเพิ่มเพดาน แอดว่าเริ่มจากทำบัญชีผู้ใช้ connection ก่อนจะช่วยให้เลือกทางได้ชัดครับ ว่ามีกี่ pool แต่ละตัวเกิดเมื่อไร และช่วงที่รันมากที่สุดจะรวมกันได้ถึงไหน แล้วค่อยดูคิวรอกับงานจริงในฐานข้อมูลประกอบ
ไลบรารีบางชุดสร้าง pool ต่อ process บางแอปมี client หลายตัวตามฐานข้อมูลหรือ credential และบางสภาพแวดล้อมสร้าง instance เพิ่มตามคำขอ จึงควรอ่านขอบเขตจาก driver กับการเริ่มแอปจริง ไม่เห็นค่า pool size หนึ่งจุดแล้วคิดว่าเป็นเพดานทั้งระบบ
ลองสมมติว่ามีแปด process แต่ละ process อนุญาตสูงสุดสิบ connection เพดานฝั่งแอปตามกติกานี้อาจรวมเป็นแปดสิบได้ ตัวเลขนี้เป็นตัวอย่างคูณ ไม่ใช่จำนวนที่ตรวจพบ และไม่ได้หมายความว่าทุก pool เปิดครบสิบอยู่ตลอด เพราะพฤติกรรมเปิดจริงขึ้นกับไลบรารีกับงานที่เข้ามา
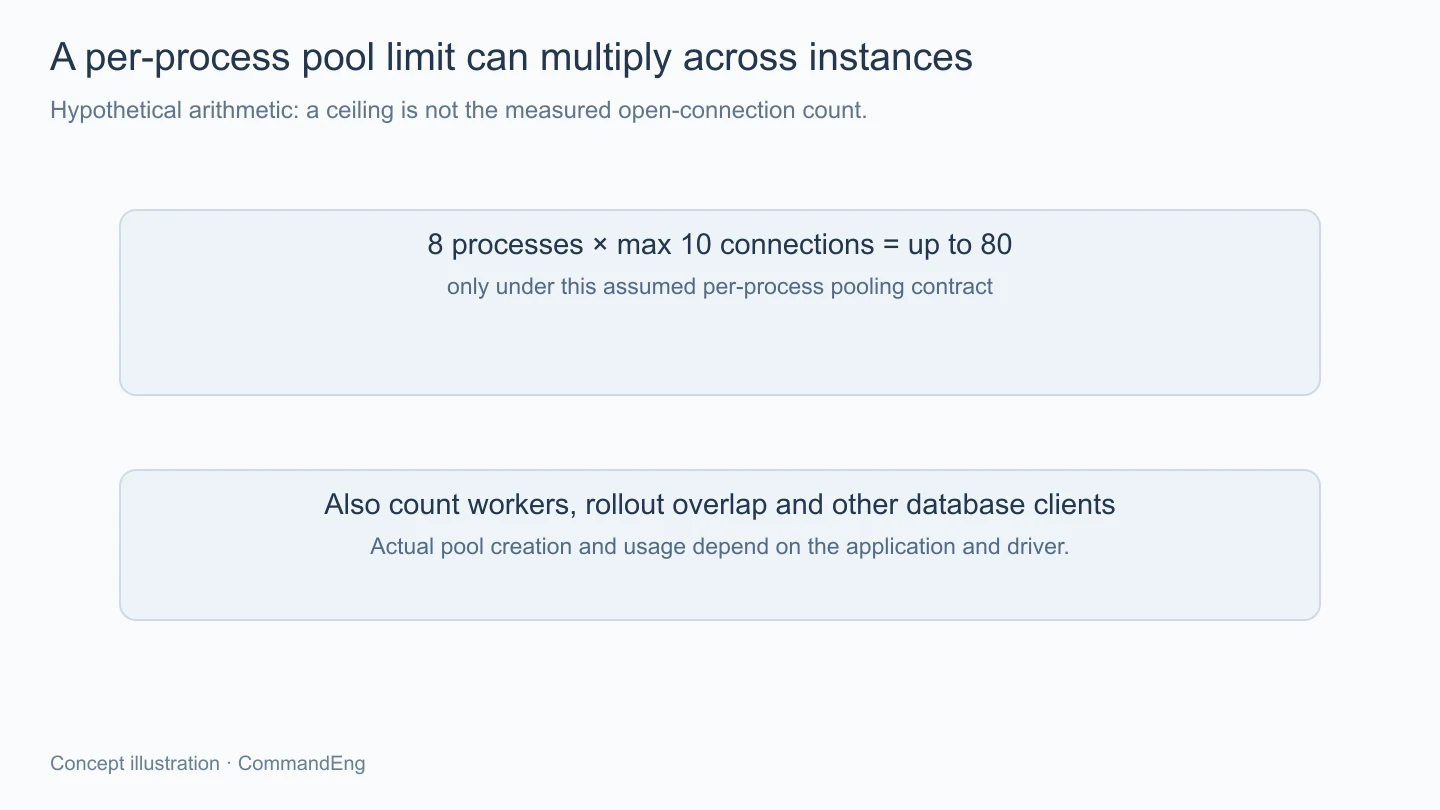
เมื่อมี worker หรือ replica ที่เกิดชั่วคราวระหว่าง rolling update ต้องนับร่วมด้วย หากดูเฉพาะจำนวน steady state อาจพลาดช่วงที่แอปเก่ากับใหม่อยู่พร้อมกันและต่างก็เชื่อมฐานข้อมูลอยู่
การสร้าง client ใหม่ทุก request ยังอาจทำให้ขอบเขตการใช้ pool ต่างจากที่คาด ควรตรวจ lifecycle ที่โปรเจกต์ใช้และวิธีคืน resource ตาม driver ไม่เพิ่ม pool size เพื่อชดเชยการถือ connection ที่ไม่ถูกปล่อยกลับโดยยังไม่แก้สาเหตุ
PostgreSQL มี max_connections สำหรับจำกัดการเชื่อมต่อพร้อมกัน และมีทรัพยากรที่จัดตามค่านี้ การเพิ่มเพดานจึงไม่ใช่การเพิ่มตัวเลขโดยไม่มีต้นทุน ต้องคิดกับหน่วยความจำ งานพร้อมกัน และสภาพฐานข้อมูลที่ให้บริการจริง
ควรเหลือขอบเขตสำหรับงานดูแลและบริการอื่นตามสิทธิ์กับ configuration ที่ใช้ ไม่ให้งานเว็บใช้ได้เต็มจนเมื่อเกิดเหตุไม่มีทางเชื่อมเข้าไปตรวจตามปกติ ส่วนจำนวนที่ควรเหลือต้องเลือกจากระบบจริง ไม่คัดลอกค่าเริ่มต้นของอีกเครื่องมาเป็นงบของเรา
จำนวน connection ที่เปิดกับจำนวน query ที่กำลังทำงานก็ไม่เท่ากัน บาง connection ว่างรอใช้งาน บางตัวอยู่ใน transaction และบางตัวกำลังรอ resource การเปิด connection ได้มากจึงไม่ได้ยืนยันว่าฐานข้อมูลทำงานเสร็จพร้อมกันได้มากเท่านั้นอย่างมีประโยชน์
ข้อมูลจากเครื่องมือตรวจอย่าง pg_stat_activity ช่วยอ่านสถานะตามสิทธิ์ที่ได้รับ แต่ควรเก็บบริบทเวลาและการเปลี่ยนจำนวนแอปร่วมด้วย การนับจาก snapshot จุดเดียวอาจยังไม่เห็นช่วง peak หรือวงจรที่ connection ไม่ถูกคืน
เมื่อ pool เต็ม คำขออาจต้องรอ connection ก่อนเริ่ม query จึงควรแยกเวลา acquire ออกจากเวลารันคำสั่งและเวลารวมของ request หากเห็นหน้าเว็บช้าแล้วดูเฉพาะเวลา query ก็อาจพลาดช่วงรอที่เกิดก่อนหน้า
การขยาย pool อาจช่วยบางเงื่อนไขถ้าฐานข้อมูลยังมีพื้นที่ให้ทำงาน แต่ถ้าคอขวดอยู่ในฐานข้อมูล การส่งงานพร้อมกันมากขึ้นอาจเพิ่มการรอแทน ต้องใช้ข้อมูลทั้งด้านแอปกับฐานข้อมูลเลือก ไม่สรุปว่าคิวทุกชนิดหายได้ด้วยจำนวน connection
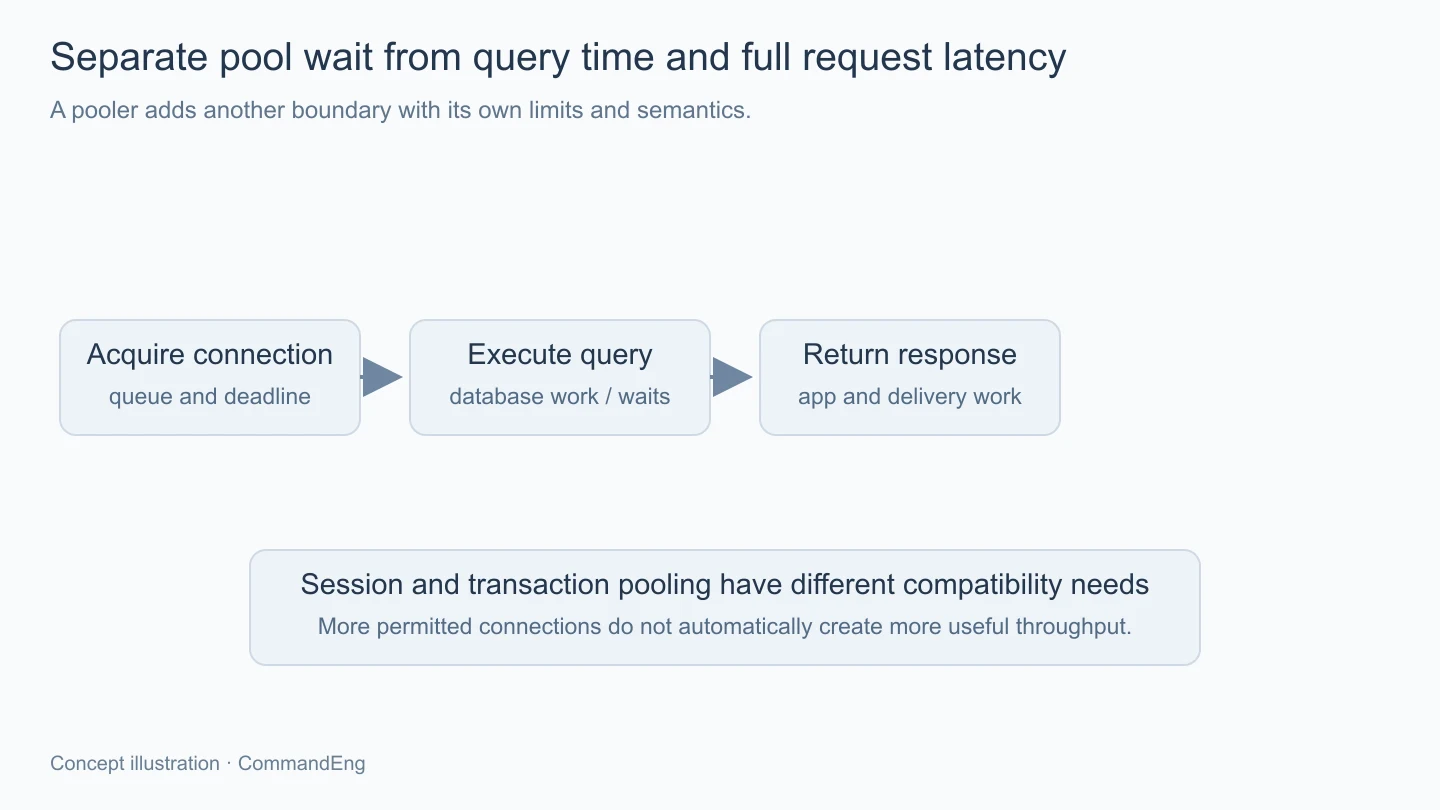
ควรกำหนดระยะรอที่สัมพันธ์กับ deadline ของ request หากผู้เรียกเลิกรอไปแล้ว งานที่ยังอยู่ในคิวหรือ query ที่เริ่มภายหลังต้องมีพฤติกรรมชัด ไม่ปล่อยให้ใช้ทรัพยากรต่อโดยไม่มีใครรอผลและไม่รู้ว่าจะยกเลิกได้อย่างไร
Transaction ที่เปิดนานก็ยึด connection ตามขอบเขตของมันด้วย ควรตรวจว่ามีการรอ API ภายนอกหรือทำงานที่ไม่จำเป็นอยู่ภายใน transaction หรือไม่ ก่อนเลือกขยายเพดานเพื่อรองรับการถือครองที่อาจลดได้
เครื่องมืออย่าง PgBouncer จัดการการเชื่อมต่อระหว่าง client กับ PostgreSQL ได้อีกชั้น แต่จำนวนฝั่ง client กับจำนวน server connection เป็นคนละด้าน จึงต้องตรวจ limits ทั้งคู่ รวมถึงขอบเขต pool ตามฐานข้อมูลและผู้ใช้ที่ตั้งไว้
Session pooling กับ transaction pooling มีวิธีผูก server connection ต่างกัน ใน transaction pooling ไม่ควรสมมติว่า session state ที่แอปทิ้งไว้จะตามกลับมาบน server เดิมทุกครั้ง ต้องตรวจ compatibility ของ driver และคุณสมบัติที่แอปใช้ตามรุ่นจริง
กรณีอย่าง prepared statements ก็มีรายละเอียดตามรูปแบบกับความสามารถที่รองรับ จึงไม่ควรจำเป็นกฎกว้างว่าทุกอย่างใช้ได้หรือใช้ไม่ได้เพียงเพราะเปิด transaction pooling อ่านข้อกำหนดของ pooler กับไลบรารีร่วมกันก่อนเปลี่ยนเส้นทาง
Pooler ยังไม่ทำให้ query ที่หนักเบาลงเอง และไม่ได้แทนสิทธิ์ฐานข้อมูล การตั้ง credential, ขอบเขต connection และการตรวจสถานะต้องรักษาตามงานเดิม ไม่เปิดให้ทุกบริการใช้บัญชีเดียวเพียงเพื่อรวมการเชื่อมต่อให้ง่าย
แผนทดสอบควรมีทั้งช่วงจำนวน replica ปกติ ช่วงเพิ่มตามโหลด และช่วงเก่ากับใหม่อยู่ร่วมกัน โดยใช้สภาพแวดล้อมกับข้อมูลที่แยกจากงานจริง แล้วดูจำนวนเปิด จำนวนใช้ คิวรอ error และเวลารวมพร้อมกัน
ตรวจกรณีฐานข้อมูลช้าหรือการเชื่อมต่อถูกตัดด้วย เพื่อดูว่าแอปคืน connection และกู้ pool ได้ตามที่คาดหรือไม่ การรีสตาร์ต process แล้วอาการหายยังไม่บอกว่าต้นเหตุของการถือ resource ถูกแก้แล้ว
ค่าที่เลือกควรมีเหตุผลจาก workload กับงบระบบ และกลับมาทบทวนเมื่อเพิ่ม worker หรือเปลี่ยนรูปแบบ deploy บทนี้ยังไม่มีผล load test ของเว็บมาใช้กำหนดจำนวน connection ที่เหมาะให้เครื่องจริง
Connection pool ต้องถูกนับตามทุก process และทุกช่วงที่ระบบมี instance เพิ่ม แล้วเทียบกับงบฐานข้อมูลและเวลารอที่ยอมรับได้ เมื่อแยกการรอ connection งาน query และขอบเขต pooling mode ชัด เราจะเพิ่ม replica ได้โดยรู้ผลต่อฐานข้อมูล และแก้คอขวดจากหลักฐานแทนการขยายเพดานไปทีละฝั่ง