


หลังรันบริการใน Homelab ไปสักระยะ พื้นที่ดิสก์อาจเพิ่มขึ้นแม้จำนวน container กับชุดข้อมูลหลักดูไม่ต่างจากเดิม สิ่งที่ต้องตามอีกทางคือ log เพราะทุก request การเชื่อมต่อใหม่ หรือข้อความ debug สามารถถูกเขียนสะสมตลอดเวลาที่บริการเปิดอยู่ได้
การดูเฉพาะขนาด image จึงอาจยังไม่พบส่วนที่โต และถ้ารีบลบไฟล์ที่เห็นว่าใหญ่โดยไม่รู้ว่าใครดูแลอยู่ ก็อาจทำให้เสียข้อมูลสำหรับตามปัญหาหรือรบกวนระบบบันทึกของ Docker เอง สิ่งที่ควรรู้ก่อนคือข้อความแต่ละทางถูกเก็บไว้ที่ไหนและมีขอบเขตแค่ไหน
แอดมองว่าเรื่องนี้ควรจัดเป็นนโยบายของบริการตั้งแต่ต้นครับ ให้เก็บพอสำหรับตามเหตุการณ์ แต่มีขอบเขตพื้นที่และระยะเวลาที่ตอบโจทย์ ไม่รอให้ดิสก์เต็มแล้วค่อยเลือกระหว่างลบทุกอย่างกับหยุดบริการ
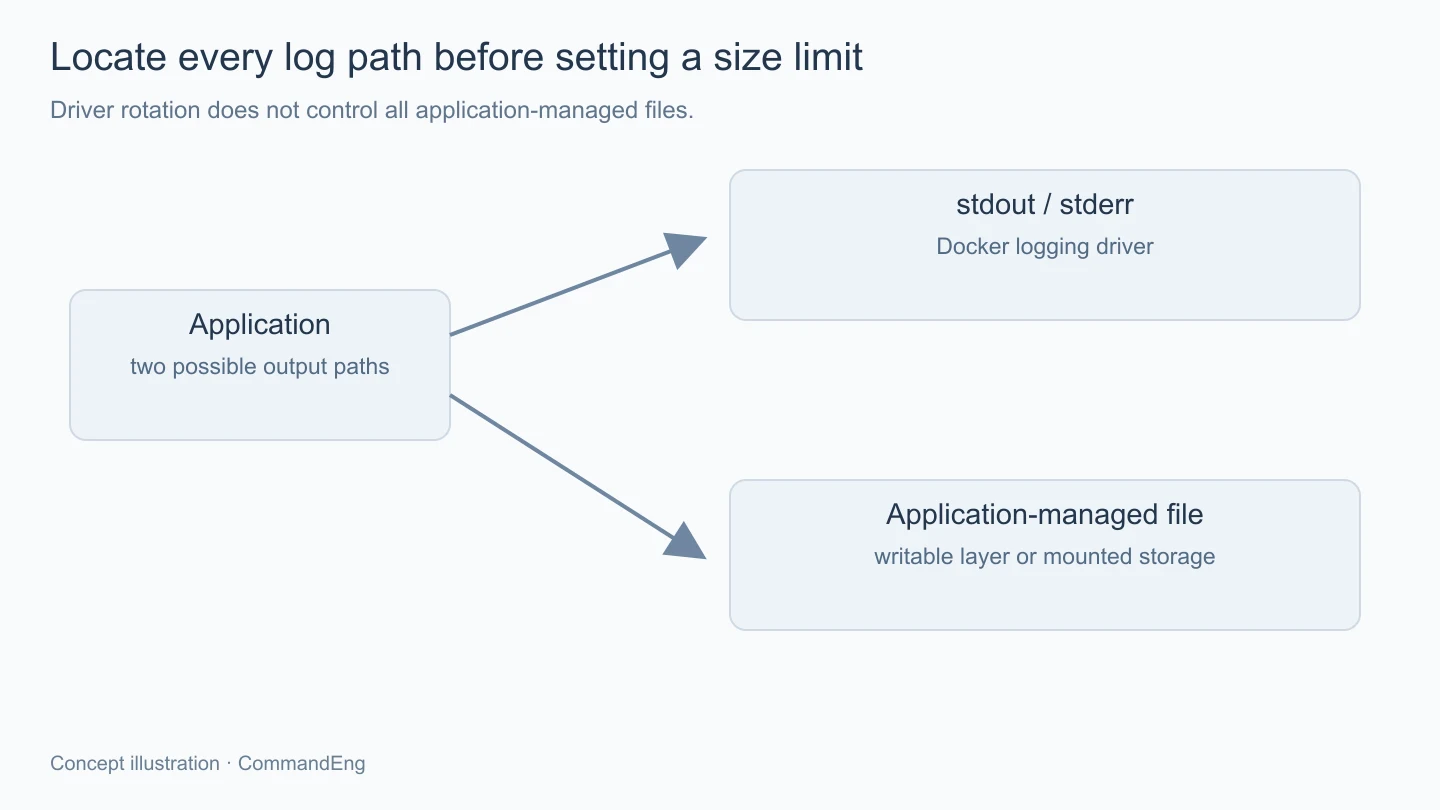
แอปใน container อาจเขียนข้อความไป stdout หรือ stderr แล้ว Docker logging driver เป็นผู้รับต่อ หรืออาจเขียนลงไฟล์ภายในแอปเอง ซึ่งไฟล์นั้นอยู่ใน writable layer หรือ volume อีกที สองทางนี้ต้องดูแลขนาดแยกกัน
การตั้ง rotation ของ logging driver ไม่ได้ควบคุมไฟล์ที่แอปเปิดเขียนเองทั้งหมด ถ้าแอปมีทั้ง access log บน stdout และ debug log ใน volume การปรับ driver อย่างเดียวจึงยังเหลืออีกแหล่งที่โตต่อได้
ควรตรวจ configuration ของ container ที่ใช้งานจริงว่าเลือก driver ใดและมี options อะไร ไม่อนุมานจากค่าเริ่มต้นของ Docker เพียงอย่างเดียว เพราะผู้ดูแลอาจเปลี่ยน daemon หรือกำหนดรายบริการไว้แล้ว และ container เก่าอาจยังใช้ค่าคนละชุดกับตัวที่เพิ่งสร้าง
เมื่อเห็นแหล่งเก็บครบแล้ว จึงค่อยดูปริมาณการเขียนตามเวลาและประเภทข้อความ การมี log มากอาจเป็น traffic ที่เพิ่มขึ้น debug ที่เปิดค้าง หรือ error เดิมที่วนซ้ำ ซึ่งแต่ละสาเหตุควรแก้ที่แอปร่วมกับการกำหนดพื้นที่ ไม่ใช่เพิ่มเพดานอย่างเดียว
Docker มี logging driver หลายแบบ โดย local driver รองรับการหมุนเวียนไฟล์ตามกลไกของมัน ส่วน json-file ต้องกำหนดตัวเลือกให้เหมาะหากต้องการจำกัดการสะสม ไม่ควรคาดว่าทุก driver มีค่าเริ่มต้นกับวิธีเก็บเหมือนกัน
ตัวอย่าง fragment ด้านล่างเป็นการกำหนด logging ของบริการสมมติใน Compose ค่าที่เลือกใช้เพื่อให้เห็นรูปแบบ ไม่ใช่ผลคำนวณพื้นที่เหมาะสมของเว็บหรือเครื่องผู้ใช้ และยังต้องมีนิยามส่วนอื่นของ service จึงจะเป็นไฟล์ที่ใช้งานครบได้
services:
  app:
    logging:
      driver: local
      options:
        max-size: "10m"
        max-file: "3"
ตัวเลือกเหล่านี้ต้องอ่านตาม driver ที่เลือก และขอบเขตเป็นราย container ไม่ใช่ quota รวมทั้งเครื่อง หากมีหลายบริการหรือเพิ่ม replica จำนวนสำเนารวมก็เพิ่มตาม อีกทั้งพื้นที่แอป ฐานข้อมูล และไฟล์อื่นยังต้องถูกนับแยกอยู่ดี
การหมุนไฟล์ด้วยขนาดยังไม่ได้รับรองว่าจะดูย้อนหลังได้กี่วัน เพราะขึ้นกับอัตราข้อความ หาก error เกิดถี่ขึ้น ข้อมูลเก่าก็ถูกหมุนออกเร็วขึ้นได้ จึงต้องวัดอัตราการเขียนจริงก่อนสัญญาว่าจะมีหลักฐานครบช่วงเวลาหนึ่งเสมอ
เมื่อเปลี่ยนค่าเริ่มต้นของ daemon ต้องอ่านขั้นตอนนำค่าไปใช้ตาม Docker แต่ที่ต้องระวังคือ container ที่มีอยู่เดิมไม่ได้เปลี่ยน logging configuration ตามให้ทั้งหมดโดยอัตโนมัติ การเห็นไฟล์ตั้งค่าใหม่จึงยังไม่ยืนยันว่าปริมาณพื้นที่ของตัวเดิมถูกจำกัดแล้ว
หากต้องสร้างบริการใหม่เพื่อใช้ configuration ใหม่ ต้องมีแผนรักษาข้อมูลถาวรกับช่วงหยุดของงานตามปกติ ไม่เอาการแก้ log ไปปะปนกับการลบ volume ที่เก็บฐานข้อมูล เพราะสองอย่างมีหน้าที่ต่างกัน
หลังนำค่าขึ้นใช้ ให้ตรวจ driver และ options ของ container ใหม่ แล้วทดลองให้มีข้อความในสภาพแวดล้อมแยกตามขอบเขตที่ต้องการ เพื่อยืนยันการหมุนและการอ่านผ่านเครื่องมือที่รองรับ ไม่ดูเพียงว่าคำสั่งสร้าง container คืนผลสำเร็จ
ไฟล์ภายในของ local กับ json-file ถูกออกแบบให้ Docker daemon ดูแล เอกสารจึงเตือนไม่ให้ใช้เครื่องมือภายนอกไปแก้ไฟล์เหล่านั้นโดยตรง การจัดการพื้นที่ฉุกเฉินควรใช้ขั้นตอนที่รองรับและรู้ผลกระทบ ไม่หยิบคำสั่งลบหรือ truncate ตาม path ภายในมาใช้กับทุกเครื่อง
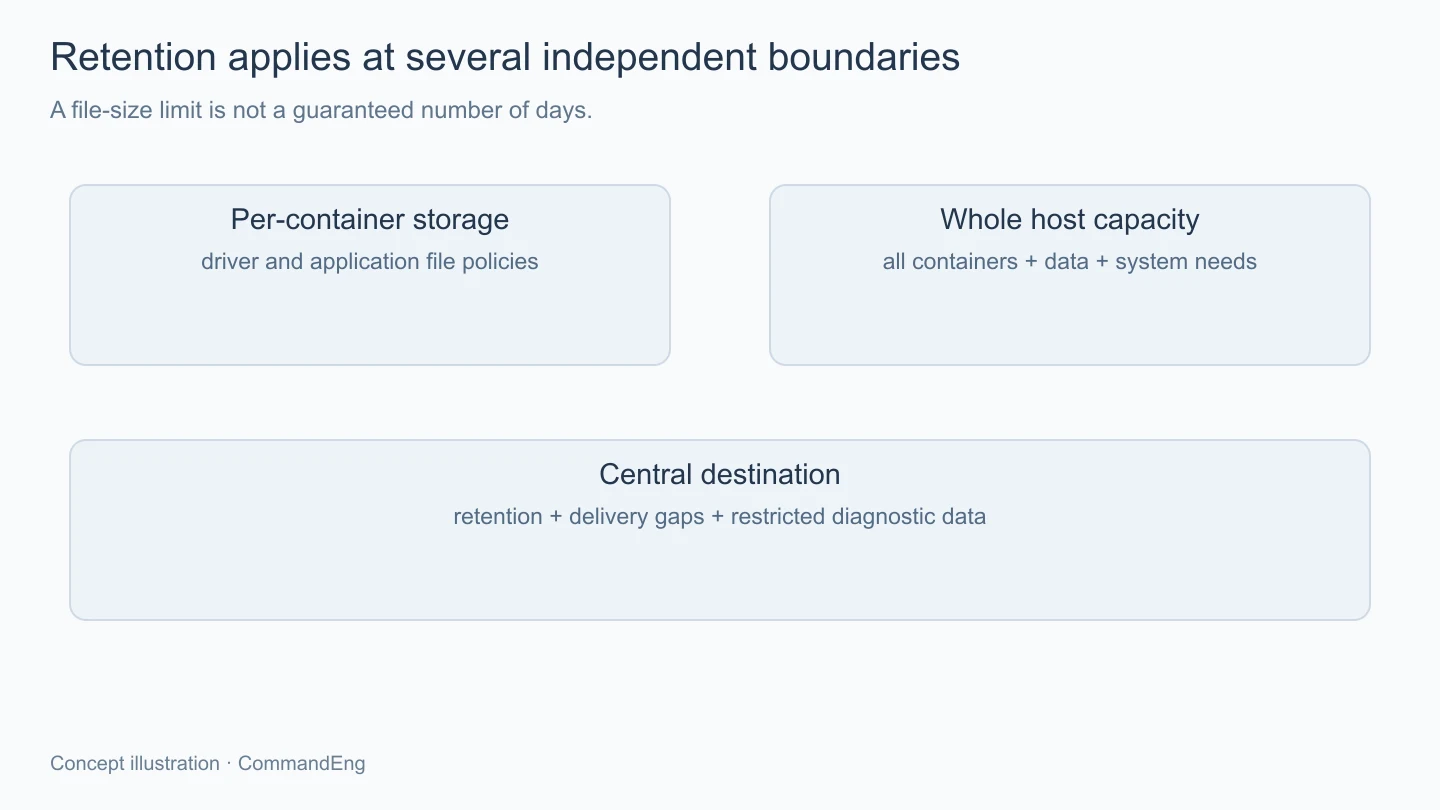
ถ้าส่ง log ไปเก็บรวม ส่วนปลายทางต้องมีนโยบายรับ เก็บ ค้น และลบของตัวเอง การมีสำเนานอกเครื่องช่วยตามเหตุการณ์เมื่อ container เปลี่ยนได้ แต่ก็มีต้นทุนพื้นที่กับขอบเขตข้อมูลที่ต้องดูแลเพิ่ม
ควรเลือก field ที่ตามเหตุการณ์ได้ เช่น เวลา ชื่อบริการ รหัส request และระดับข้อความ พร้อมตัด credential หรือข้อมูลผู้ใช้ที่ไม่จำเป็น การเอา environment ทุกค่าใส่ log เพื่อช่วย debug อาจทำให้ข้อมูลลับถูกคัดลอกไปอยู่หลายระบบโดยไม่มีประโยชน์ต่อคำถามที่กำลังตรวจ
เส้นทางส่ง log เองก็อาจมีปัญหาได้ Docker มีโหมดส่งแบบ blocking กับ non-blocking ซึ่งมีผลต่างกันเมื่อปลายทางรับไม่ทัน แบบมี buffer ช่วยลดการค้างจาก back pressure ได้ตามกลไก แต่เมื่อ buffer เต็มก็มีโอกาสทิ้งข้อความ จึงต้องเลือกโดยรู้ว่าอะไรสำคัญกับบริการนั้น
ไม่ควรถือว่าการมีระบบรวม log ทำให้ข้อมูลครบทุกบรรทัดแน่นอน ต้องมีวิธีสังเกตการส่งไม่ทัน ช่องว่าง และขีดจำกัดของแต่ละจุดด้วย โดยเฉพาะหากนำข้อมูลนั้นไปใช้รายงานเหตุการณ์หรือวิเคราะห์จำนวนคำขอภายหลัง
ตอนเกิดเหตุควรเก็บช่วงเวลาก่อนและหลังเหตุการณ์ที่จำเป็น พร้อมรหัส container กับรุ่นชิ้นงาน เพราะหลังสร้าง container ใหม่ ชื่อบริการเดิมอาจชี้ไปคนละ instance และ log ที่กำลังอ่านก็อาจไม่ใช่รอบที่มีปัญหาแล้ว
การขอ log แบบมีช่วงเวลาและจำนวนบรรทัดช่วยให้เริ่มตรวจได้โดยไม่เทข้อมูลทั้งหมดออกมา แต่ต้องรู้ว่าเกณฑ์นั้นอาจตัดเหตุการณ์ต้นทางที่เกิดก่อนหน้าด้วย หากจำเป็นให้ขยายตามหลักฐาน ไม่สรุปว่าไม่มี error เพียงเพราะไม่เจอในบรรทัดท้ายสุด
สำหรับการวางขนาดเก็บ ควรอ่านอัตราที่เกิดทั้งช่วงปกติและช่วงมีปัญหา พร้อมนับจำนวน container ที่จะรันจริง จากนั้นเผื่อพื้นที่ระบบตามเหตุผลของงาน ตัวเลขในตัวอย่าง configuration ไม่ควรถูกยกไปแทนผลตรวจปริมาณของเครื่อง
เมื่อปรับระดับข้อความ ต้องรักษารายการที่ใช้ตามข้อผิดพลาดและการเปลี่ยนสถานะสำคัญไว้ด้วย การปิด log ทั้งหมดอาจทำให้พื้นที่หยุดโต แต่คนดูแลก็สูญเสียทางตามเหตุการณ์ที่เป็นสาเหตุของการเขียนมากผิดปกติไปพร้อมกัน
พื้นที่ log ต้องตามจากทั้ง stdout/stderr ที่ driver ดูแลและไฟล์ที่แอปเขียนเอง แล้วกำหนดขอบเขตแต่ละจุดตามปริมาณกับระยะที่ต้องใช้จริง เมื่อยืนยัน configuration ของ container และดูแลปลายทางรวมร่วมกัน ก็จะควบคุมการสะสมได้โดยยังเก็บหลักฐานที่ช่วยแก้ปัญหา แทนการปล่อยให้ดิสก์เป็นตัวตัดสินว่าจะเหลือข้อมูลใดให้ตรวจ