


เมื่อเริ่มเอาบริการมารันด้วย Docker สิ่งหนึ่งที่ต้องคิดต่อจากเปิดใช้งานได้คือถ้าโปรแกรมหยุดแล้วจะให้กลับมาอย่างไร บางบริการควรเปิดใหม่เองเมื่อ process ล้ม ส่วนงานที่ตั้งใจทำครั้งเดียวแล้วจบก็ไม่ควรถูกเรียกวนเพียงเพราะใช้ค่าตั้งเหมือนบริการอื่น
คำว่า restart จึงมีรายละเอียดมากกว่าการเปิดให้เครื่องดูแลตัวเอง และยังต้องแยกจาก healthcheck ด้วย เพราะ container ที่ process ยังอยู่แต่ตอบงานไม่ได้ อาจมีสถานะต่างจาก container ที่ process ออกไปแล้ว แม้คนใช้งานจะเห็นว่าเปิดบริการไม่ได้เหมือนกัน
ก่อนเลือก policy แอดว่าเริ่มจากนิยามการหยุดของแต่ละบริการก่อนจะช่วยได้ครับ ว่ากรณีใดคาดหวังให้กลับมาเอง กรณีใดผู้ดูแลตั้งใจหยุด และถ้ากลับมาแล้วยังเจอสาเหตุเดิมจะตามปัญหาจากที่ไหน
Restart policy ของ Docker Engine ใช้กำหนดพฤติกรรมเมื่อ container ออกจากการทำงานและในเงื่อนไขที่เกี่ยวข้องกับ daemon ส่วน healthcheck เพิ่มสถานะสุขภาพให้ container อีกชุดหนึ่ง เช่น starting, healthy หรือ unhealthy ตามผลคำสั่งตรวจ
ในบริบท Docker Engine แบบปกติ การที่ healthcheck เปลี่ยนเป็น unhealthy อย่างเดียวไม่ได้หมายความว่า restart policy จะสั่งเปิด container ใหม่ให้ทันที ถ้า process หลักยังทำงานอยู่ก็เป็นอีกสถานะที่ต้องมีกลไกดูแลตามที่ออกแบบไว้ ส่วน orchestrator ที่ใช้จัดการ container อาจมีกติกาเพิ่มเติมต่างกัน ต้องดูระบบที่ใช้อยู่จริง
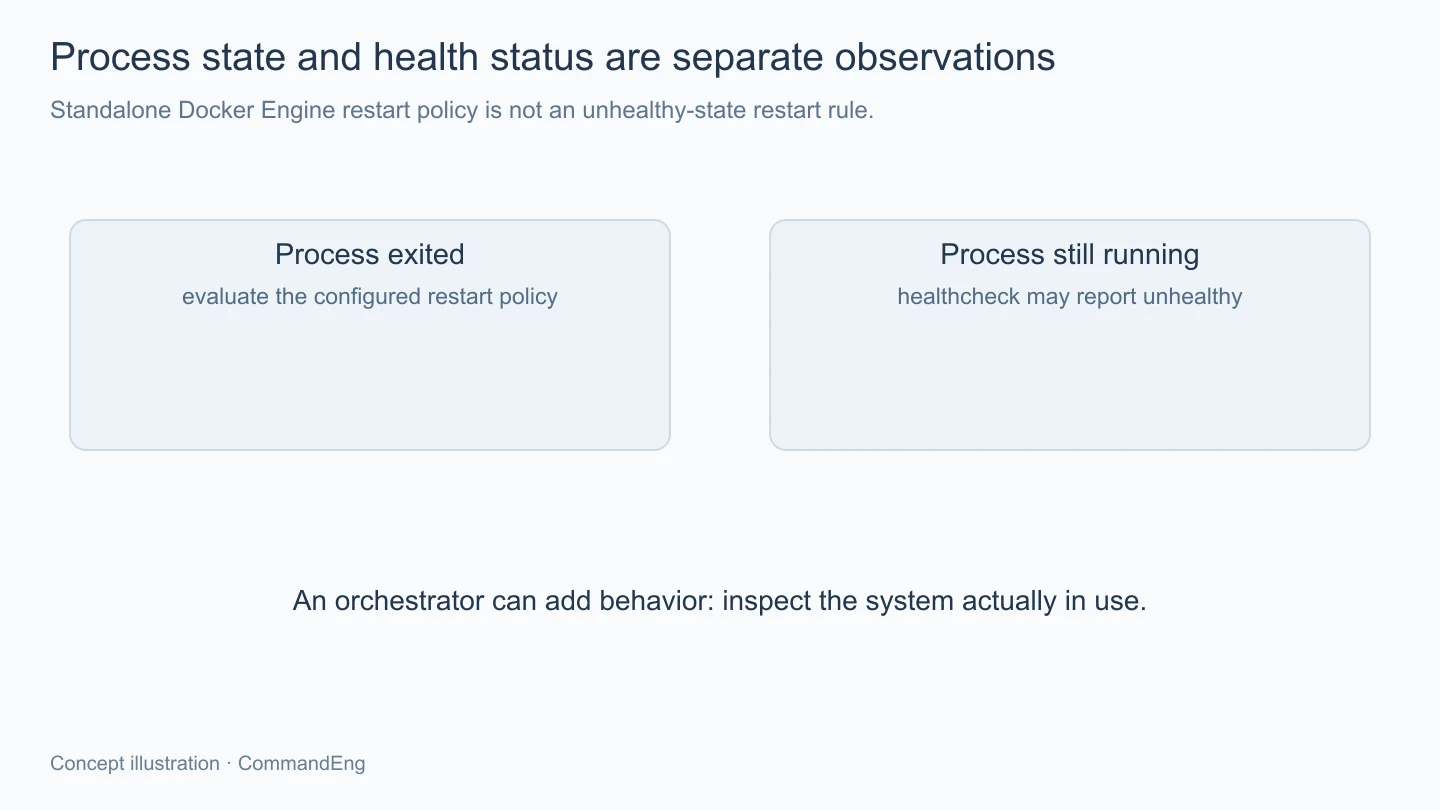
ความต่างนี้มีผลเวลาออกแบบจุดตรวจ หากแอปค้างแต่ process ไม่ออก การตั้ง restart policy อย่างเดียวอาจไม่ตอบโจทย์ ขณะเดียวกันถ้า healthcheck ไปพึ่งบริการภายนอกมากเกินไป การให้กลไกอื่น restart ทุกครั้งที่ตรวจไม่ผ่านก็อาจทำให้แอปถูกเปิดใหม่พร้อมกันทั้งที่สาเหตุอยู่อีกระบบ
จึงควรถามแยกว่าการตรวจนี้บอกความพร้อมให้รับงาน หรือบอกปัญหาที่การเริ่ม process ใหม่มีโอกาสแก้ได้จริง การตั้งชื่อ endpoint ว่า health ไม่ได้เลือกคำตอบให้โดยอัตโนมัติ
ค่า no ไม่ให้ Docker restart โดยอัตโนมัติ ส่วน on-failure ใช้กับการจบที่มี exit code ไม่เป็นศูนย์ และสามารถกำหนดจำนวนการลองกลับมาได้ตามรูปแบบของ policy นี้ จึงเหมาะจะพิจารณาเมื่อความล้มเหลวของ process เป็นจุดที่ต้องการให้ลองใหม่ โดยยังต้องมีทางตามเมื่อหยุดลองแล้ว
always กับ unless-stopped มีพฤติกรรมใกล้กันในแง่ดูแลให้กลับมารัน แต่ต่างกันเมื่อ container ถูกหยุดไว้โดยผู้ดูแลแล้ว daemon กลับมาทำงาน โดย unless-stopped รักษาความตั้งใจที่หยุดไว้ในกรณีนั้น ส่วน always มีพฤติกรรมตามเงื่อนไขการเริ่ม daemon ที่เอกสารกำหนด
รายละเอียดการหยุดด้วยมือจึงสำคัญ ถ้าผู้ดูแลหยุดบริการเพื่อแก้ข้อมูลหรือเปลี่ยนการตั้งค่า ต้องรู้ด้วยว่าหลังเปิด Docker หรือเครื่องใหม่ บริการใดจะกลับมาเอง ไม่เลือก policy จากคำว่า always ที่ดูเหมือนทนทานกว่าโดยไม่คิดถึงงานซ่อมบำรุง
อีกจุดคือ on-failure ไม่ได้เป็นกติกาเดียวกับการเปิดบริการหลัง daemon restart การดูว่ามี restart policy อยู่แล้วจึงยังไม่พอ ต้องอ่านว่าค่าที่เลือกตอบทั้งเหตุการณ์ process ออกและเหตุการณ์ daemon เริ่มใหม่อย่างไรตามเอกสารของ Docker
ลองสมมติงานแปลงไฟล์ที่รับ input หนึ่งชุดแล้วจบ หากเอา policy สำหรับบริการที่ต้องอยู่ตลอดมาใช้ อาจทำให้งานถูกเปิดกลับมาทั้งที่ทำสำเร็จแล้ว ส่วนถ้างานล้มเหลวหลังสร้างไฟล์ไปบางส่วน การเริ่มใหม่ก็ต้องรู้ว่าจะใช้ผลเดิมต่อหรือสร้างซ้ำอย่างไร
จึงควรแยกบริการรับคำขอที่รันยาวออกจาก job ที่มีจุดจบ และกำหนดผู้รับผิดชอบการลองใหม่ให้ชัด ถ้ามี scheduler หรือคิวดูแลงานอยู่แล้ว ยังต้องตรวจด้วยว่าการ restart ระดับ container จะซ้อนกับการส่ง job ซ้ำระดับคิวหรือไม่
การที่ process ออกด้วย code ศูนย์ก็ไม่ได้พิสูจน์ว่างานทางธุรกิจครบเสมอไป หากโปรแกรมจัดการ error แล้วออกแบบเงียบๆ policy ที่ดู exit code จะเห็นตามที่โปรแกรมรายงาน จึงต้องทำให้สถานะจบของแอปตรงกับสิ่งที่ระบบควรใช้ตัดสินใจด้วย
ในทางกลับกันบางงานอาจคืน code ไม่เป็นศูนย์ด้วยเหตุที่ต้องให้คนแก้ เช่น config ขาดหรือสิทธิ์ไม่พอ การเปิดใหม่ด้วยข้อมูลเดิมซ้ำๆ ก็ไม่ทำให้สิ่งเหล่านั้นถูกแก้ จึงควรมีการแจ้งหรือสถานะที่พาผู้ดูแลไปแก้ต้นเหตุได้
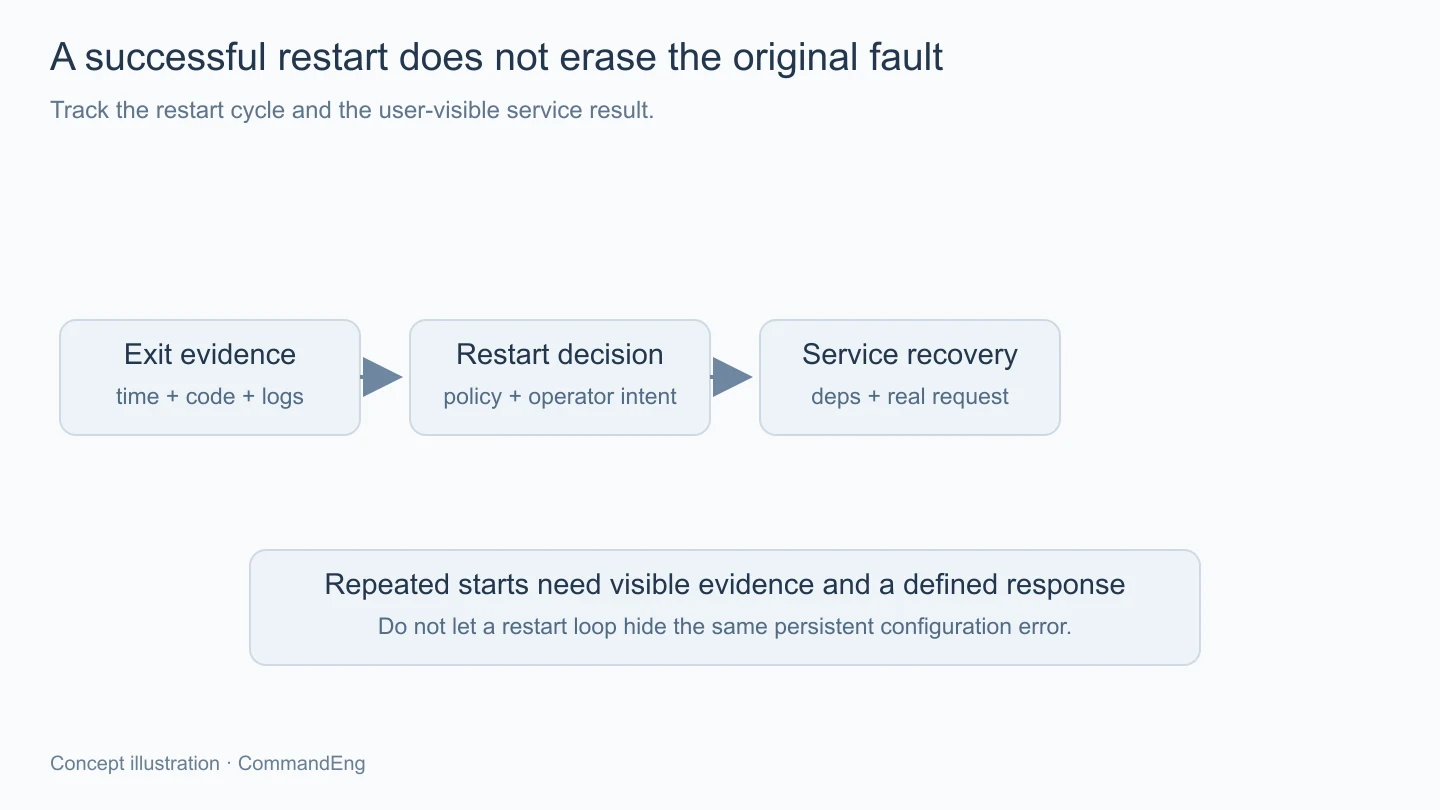
Restart policy ช่วยให้ process กลับมาได้ แต่จำนวนครั้งที่เพิ่มขึ้นควรถูกมองเห็นด้วย ไม่อย่างนั้นบริการอาจดูเหมือนใช้งานได้เป็นช่วงๆ โดยมีการเริ่มใหม่ซ้ำอยู่ข้างหลัง และทำให้ข้อมูลวินิจฉัยของรอบก่อนถูกกลบไปเรื่อยๆ
ข้อมูลที่ควรดูร่วมกันคือสถานะปัจจุบัน จำนวน restart เวลาเริ่มและจบ exit code กับ log ใกล้เหตุการณ์ รวมถึงข้อมูลจากระบบที่อาจบอกว่า process ถูกหยุดเพราะทรัพยากรหรือสัญญาณใด โดยไม่สรุปจากจำนวน restart เพียงค่าเดียวว่าเป็นบั๊กในแอปแน่นอน
ตัวอย่างคำสั่งอ่านข้อมูลสำหรับ container ที่เราดูแลสามารถใช้ docker inspect และ docker logs ได้ แต่ต้องเลือกชื่อกับช่วงเวลาให้ตรง และหลีกเลี่ยงการคัดลอก environment ที่มีรหัสลับไปไว้ในรายงานทั่วไป การตามอาการนี้ไม่จำเป็นต้อง dump ทุก field ของ container ออกมาเผยแพร่
หากพบว่ากลับมาแล้วล้มเหมือนเดิม ควรเก็บหลักฐานก่อนปรับ policy หรือเริ่มใหม่ด้วยมือ การเปลี่ยนเงื่อนไขหลายรอบโดยไม่จดเวลาอาจทำให้แยกไม่ได้ว่าการหยุดครั้งใดมาจากโปรแกรม และครั้งใดเป็นสิ่งที่ผู้ดูแลสั่งเอง
บริการที่เปิดใหม่อาจยังรอฐานข้อมูล รอเครือข่าย หรือกำลังกู้ข้อมูลภายในอยู่ การเห็นสถานะ running จึงควรตามด้วยการตรวจเส้นทางใช้งานจริงที่เหมาะสม ไม่หยุดการตรวจที่ process เริ่มได้เพียงอย่างเดียว
แอปควรรับมือ dependency ที่หายแล้วกลับมาได้ตามลักษณะงาน เช่น สร้าง connection ใหม่และยกเลิกงานที่ยืนยันผลไม่ได้อย่างเหมาะสม การ restart ทั้ง container ทุกครั้งที่ connection เก่าขาดอาจทำให้สูญเสียบริบทของงานซึ่งควรจัดการที่แอป
ควรตรวจด้วยว่าข้อมูลถาวรกับการตั้งค่าถูกจัดวางให้รอดจากวงจรสร้างและเปิด container ตามที่ตั้งใจ หากบริการกลับมาโดยไม่มีข้อมูลที่ต้องใช้ การมี policy ช่วยเปิด process ก็ยังไม่ทำให้บริการกลับสู่สภาพที่คนใช้งานต้องการ
ใช้บริการทดสอบที่แยกจากงานจริงเพื่อตรวจการจบแบบสำเร็จ การจบแบบล้มเหลว การหยุดด้วยมือ และการเริ่ม daemon ตามเงื่อนไขที่ต้องการ แล้วตรวจทั้ง process กับสถานะที่ผู้ใช้เห็น การทดสอบ daemon ต้องวางขอบเขตไม่ให้กระทบบริการอื่นบนเครื่องเดียวกัน
ถ้าใช้ Compose ให้ตรวจ configuration ที่ถูกนำไปสร้าง container จริง และแยก restart policy ระดับบริการจากตัวเลือกที่อยู่ภายใต้ dependency ซึ่งมีหน้าที่ต่างกัน บทนี้เป็นหลักเลือกและวิธีตรวจ ยังไม่ได้รายงานผลการหยุดหรือเปิด Docker ของเครื่องผู้ใช้
Restart policy ควรสอดคล้องกับความหมายของการจบงานและความตั้งใจของผู้ดูแล โดยแยกจาก healthcheck และกลไกกู้คืนระดับแอป เมื่อมองเห็นการเริ่มใหม่ซ้ำและตรวจต่อว่าบริการใช้งานได้จริง ก็จะใช้การ restart เป็นส่วนหนึ่งของการดูแลได้ โดยไม่ปล่อยให้การเปิด process กลับมาบดบังสาเหตุที่ยังต้องแก้