


Container ที่ตอบคำขอได้ดีตอนทำงานปกติยังมีอีกช่วงที่ต้องออกแบบ คือช่วงกำลังหยุดเพื่อเปลี่ยนรุ่นหรือปิดระบบ หากมีงานเขียนข้อมูลหรือประมวลผลอยู่ การหายไปของ process อาจทิ้งผลที่ไม่ตรงกับคำตอบที่ client ได้รับ
การสั่ง stop จึงไม่ควรถูกมองว่าเป็นเพียงปุ่มตรงข้ามกับ start ระบบรัน container มีขั้นส่ง signal และรอก่อนบังคับหยุด แต่โปรแกรมข้างในต้องรู้ด้วยว่าจะใช้โอกาสนั้นจบงานหรือส่งต่องานอย่างไร
สิ่งที่ต้องตรวจคือเส้นทางตั้งแต่ signal ไปถึงแอปและสถานะของงานหลังออกครับ ไม่ใช่ดูเพียงว่า container เปลี่ยนเป็น stopped ได้แล้ว
Docker stop ส่ง signal ให้ main process ของ container ตามค่าที่กำหนดไว้ โดยทั่วไปใช้ SIGTERM หากไม่มีการกำหนดอย่างอื่น แล้วให้ช่วงเวลาสำหรับหยุดก่อนใช้ SIGKILL เมื่อยังไม่ออกตาม timeout
SIGTERM เปิดโอกาสให้โปรแกรมจัดการการหยุดตามที่เขียนหรือ framework รองรับ ส่วน SIGKILL ไม่ใช่ขั้นเรียก cleanup ของแอป เราจึงพึ่งว่าทุกงานจะบันทึกครบในตอนถูกบังคับหยุดไม่ได้
การเพิ่ม timeout ช่วยเฉพาะเมื่อโปรแกรมได้รับ signal และมีทางทำงานต่อจนออกได้จริง หากมันไม่รู้ว่าต้องหยุด หรือมีงานที่รอไม่สิ้นสุด การเพิ่มเวลารอเพียงอย่างเดียวก็อาจได้แค่การหยุดที่ช้าลงก่อนถูกบังคับเหมือนเดิม
ค่าที่เหมาะสมต้องสัมพันธ์กับระยะงานที่อนุญาตให้จบและงบเวลาของระบบที่สั่งปิด ไม่ใช้ค่าเดียวกับทุก container หรือขยายเป็นไม่จำกัดโดยยังไม่รู้ว่าจะส่งผลต่อรอบ deploy อย่างไร
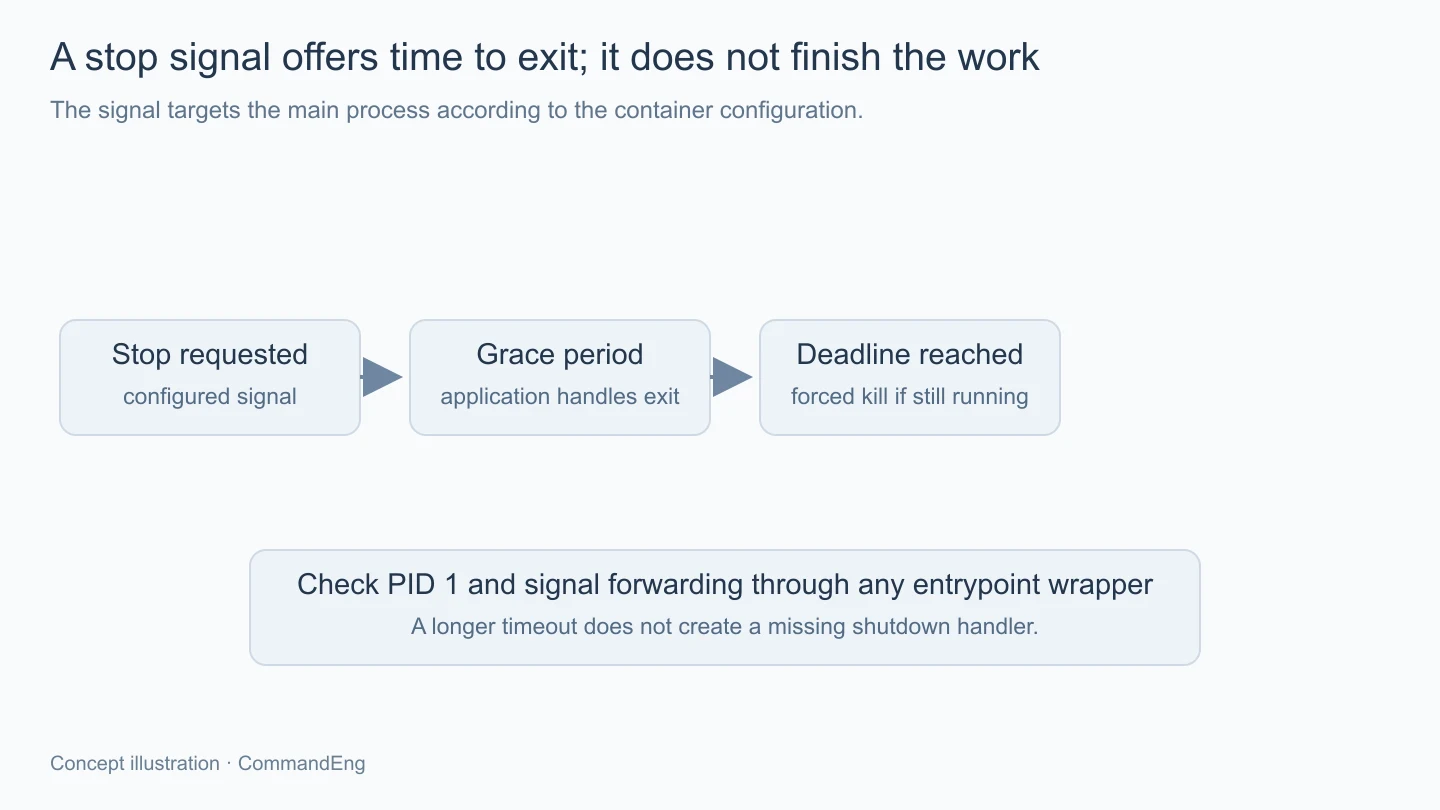
การประกาศ ENTRYPOINT แบบ exec กับแบบ shell ทำให้โครง process ต่างกัน ในรูปแบบ shell อาจมี shell เป็นตัวแรกแล้วโปรแกรมจริงเป็น process ลูก ซึ่งเส้นทางส่ง signal ไม่เหมือนการให้โปรแกรมเป็น main process โดยตรง
Dockerfile ที่เริ่มโปรแกรมผ่าน wrapper จึงควรตรวจว่าตัว wrapper ส่งต่อ signal หรือใช้ exec แทนตัวเองในจังหวะสุดท้ายตามความเหมาะสมหรือไม่ การมีคำสั่ง start ของแอปอยู่ในไฟล์ไม่ได้ยืนยันว่า SIGTERM จะไปถึง handler ของมันตามที่คาด
แต่การเปลี่ยนเป็น exec form ก็ไม่ได้สร้าง graceful shutdown ให้แอปเอง เพียงทำให้ความรับผิดชอบของ process กับการรับ signal ชัดขึ้น เรายังต้องตรวจพฤติกรรมของ runtime framework และงานเบื้องหลังที่แอปเป็นเจ้าของ
จุดนี้ควรตรวจจาก process tree ของ image ที่ใช้จริง เพราะ image ที่ดูแลโดยคนอื่นอาจมี init หรือ entrypoint ที่จัดการเรื่องนี้อยู่แล้ว ไม่ควรแทนที่ด้วย wrapper ใหม่เพียงเพื่อให้ config ดูสั้นโดยยังไม่รู้ว่ากำลังตัดหน้าที่อะไรออกไป
เมื่อรู้ว่าจะปิด โปรแกรมควรเข้าสู่สถานะหยุดรับงานใหม่ตามทางที่ออกแบบ หากยังรับคำขอเข้ามาเรื่อยๆ ระหว่างรอจบงานเดิม ช่วง drain ก็อาจไม่สิ้นสุดหรือสร้างงานที่ไม่มีเวลาทำต่อให้ครบ
สำหรับบริการ HTTP ต้องคิดทั้งการนำออกจากเส้นทางรับ traffic กับคำขอที่มาถึงแล้ว การที่ proxy เลิกเลือก endpoint ใหม่ไม่ได้แปลว่า connection เดิมหรือคำขอที่อยู่ระหว่างทางหายไปพร้อมกัน ควรตรวจตาม server และโครงข่ายที่ใช้จริง
ส่วน worker ที่ดึงงานจากคิวอาจเริ่มจากหยุดรับรายการใหม่ แล้วตัดสินว่างานที่ถืออยู่จะทำจนจบหรือคืนให้ระบบกู้ต่อ การปิด connection คิวทันทีโดยยังมีงานกำลังเขียนอาจทำให้สถานะยืนยันรับงานกับผลในฐานไม่ตรงกัน
จึงต้องกำหนดความหมายของคำว่างานเสร็จให้ชัด เช่น ผลถูก commit แล้วและส่ง acknowledgement ตามสัญญา ไม่ใช้แค่ callback ประมวลผลจบเป็นหลักฐานว่าทุกชั้นยืนยันครบ
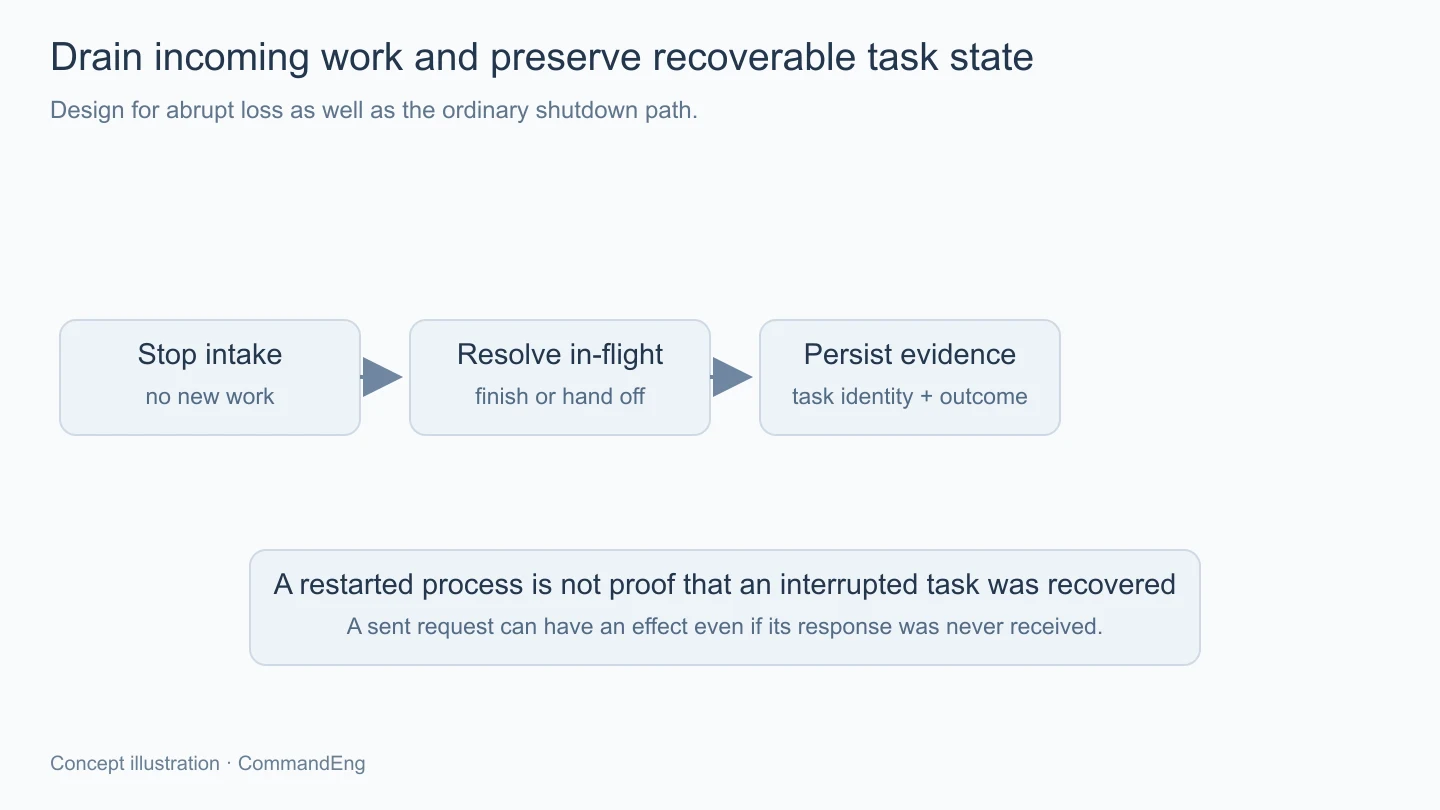
บางงานไม่ควรถูกบังคับให้จบภายในช่วงหยุดเพียงอย่างเดียว หากใช้เวลานานหรือมีผลหลายระบบ ต้องมีสถานะที่เก็บไว้ภายนอก process เพื่อให้แยกได้ว่าเริ่มแล้ว ทำถึงไหน และส่วนใดยังต้องตรวจผลก่อนทำซ้ำ
ตัวอย่างสมมติคืองานส่งคำขอไปบริการภายนอกแล้วถูกหยุดก่อนรับคำตอบ การกลับมาทำใหม่ไม่ได้พิสูจน์ว่าคำขอแรกไม่มีผลไปแล้ว จึงต้องมีตัวตนงานกับวิธีตามสถานะหรือป้องกันผลซ้ำตามสัญญาของบริการนั้น
การ flush log ช่วยเก็บหลักฐานบางส่วน แต่ log ไม่ใช่ที่เก็บสถานะงานหลักเสมอไป และการเรียก cleanup ก็อาจถูกขัดก่อนจบ ระบบที่ต้องรักษางานจึงควรออกแบบให้ทนการหายไปโดยไม่ผ่านทางปิดปกติด้วย
Restart policy มีหน้าที่ตามเงื่อนไขการเริ่ม process ไม่ได้อ่านความหมายของงานค้างให้เรา การเห็น container กลับมารันจึงต้องตรวจคู่กับว่ารายการเดิมถูกกู้ต่อ ซ้ำ หรือหายไปตามกลไกของแอปอย่างไร
ควรมีการทดสอบในสภาพแวดล้อมแยกทั้งช่วงไม่มีงาน ช่วงมีคำขอสั้น และช่วงมีงานเกินเวลาที่อนุญาต พร้อมระบุว่าคาดให้งานใดเสร็จ งานใดถูกยกเลิก และงานใดต้องกลับมาทำต่อหลังเริ่มใหม่
เก็บเวลาที่เริ่มหยุด การรับ signal การหยุดรับงาน และผลของงานที่ตามได้ ไม่ต้องคาดว่าตัวเลขระยะเวลาต้องเหมือนกันทุกครั้ง แต่ต้องเห็นว่าขอบเขตที่ออกแบบไว้ยังมีผลเมื่อ process ถูกบังคับจบจริง
ถ้าใช้ signal ที่ต่างจากค่าปกติ ต้องทดสอบให้ตรงกับ image และ runtime นั้น ไม่เอาผลกด Ctrl+C ตอนรันบนเครื่องพัฒนาไปแทน Docker stop โดยไม่ดูว่าส่ง signal คนละชนิดหรือผ่านคนละ process tree
ระหว่างตรวจควรใช้ข้อมูลและปลายทางทดลองที่ไม่สร้างผลจริงนอกระบบ แล้วอ่านสถานะหลังเริ่มใหม่จากแหล่งเก็บงานด้วย การที่ log มีคำว่า shutdown complete ช่วยได้ แต่ยังต้องสัมพันธ์กับสิ่งที่ฐานหรือคิวเก็บไว้จริง
การหยุด container อย่างมีขั้นตอนต้องมีทั้ง signal ที่ไปถึงโปรแกรม การหยุดรับงาน และทางจัดการงานที่ยังไม่จบภายในเวลา เมื่อเก็บตัวตนกับสถานะงานให้ฟื้นได้แม้ process หายไป เราจะใช้ช่วง graceful shutdown เพื่อลดงานสะดุด พร้อมมีหลักฐานว่าหลังเริ่มใหม่ระบบทำต่ออย่างไร แทนการถือว่าหยุดได้แล้วแปลว่าทุกผลข้างในครบแล้ว