


ตอนเริ่มเพิ่มฟังก์ชันให้บอร์ด เรามักดูจำนวน heap ที่เหลือเป็นข้อมูลประกอบ ถ้ายังมีตัวเลขว่างอยู่ก็ดูเหมือนควรขอ buffer เพิ่มได้ แต่พอมีการเชื่อมต่อเครือข่าย อ่านข้อมูล และสร้างข้อความในช่วงเดียวกัน ก็อาจพบว่าการจัดสรรบางก้อนล้มเหลวทั้งที่ตัวเลขรวมยังไม่เป็นศูนย์
เหตุผลหนึ่งคือหน่วยความจำว่างอาจกระจายเป็นหลายก้อน และพื้นที่แต่ละชนิดก็มีเงื่อนไขการใช้งานต่างกัน โค้ดที่ต้องใช้พื้นที่ต่อเนื่องขนาดหนึ่งจึงไม่ได้รับประโยชน์จากการเอาช่องว่างที่อยู่คนละจุดมาบวกเป็นตัวเลขรวมเฉยๆ
การตรวจจึงควรดูมากกว่าค่า free heap ค่าเดียวครับ ต้องรู้ว่าขอพื้นที่ชนิดไหน ก้อนใหญ่สุดที่ยังหาได้มีเท่าไร และงานส่วนใดกำลังใช้พื้นที่อยู่ในจังหวะที่ล้มเหลว ก่อนจะตัดสินว่าเป็น memory leak หรือจำเป็นต้องเปลี่ยนรุ่นบอร์ด
ลองนึกภาพพื้นที่ว่างหลายช่องที่มีข้อมูลใช้งานอยู่คั่นกลาง ผลรวมของช่องทั้งหมดอาจมากกว่าขนาด buffer ที่ต้องการ แต่หากไม่มีช่องเดียวใหญ่พอ การขอพื้นที่ต่อเนื่องก็ยังไม่สำเร็จ ภาพนี้ช่วยอธิบาย fragmentation ได้โดยไม่ต้องรอให้หน่วยความจำถูกใช้จนหมด
ใน ESP-IDF มี heap_caps_get_free_size สำหรับดูจำนวนว่างตาม capability และ heap_caps_get_largest_free_block สำหรับดูก้อนใหญ่สุดที่จัดสรรได้ในเงื่อนไขเดียวกัน การเปรียบเทียบจึงควรใช้ capability ชุดที่ตรงกัน ไม่เอาตัวเลขรวมจากอีกชนิดพื้นที่มาช่วยสรุปว่าควรขอผ่าน
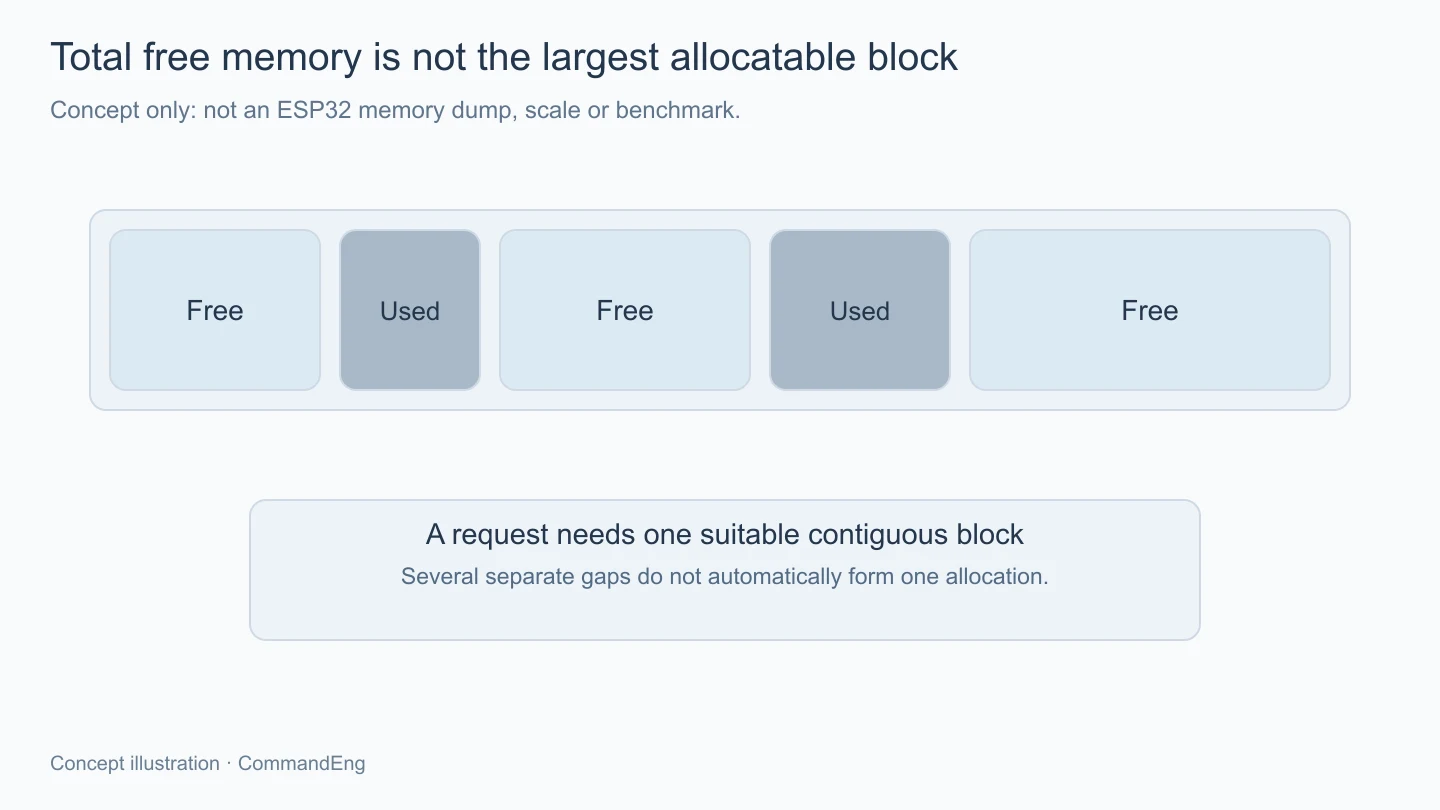
ถ้ารู้ว่าจุดที่ล้มเหลวขอก้อนใหญ่ขนาดใด ก็จะเทียบกับข้อมูลก่อนเกิดเหตุได้ตรงขึ้น แต่การเห็นก้อนใหญ่สุดเล็กยังไม่ได้บอกตัวการว่าโค้ดส่วนไหนทำให้กระจาย ต้องตรวจรูปแบบการจองและคืนพื้นที่ของงานที่เกิดร่วมกันต่อด้วย
รูปประกอบเป็นแนวคิดของช่องว่าง ไม่ใช่ dump หน่วยความจำจากบอร์ดจริง จึงไม่ควรอ่านความยาวของช่องในภาพเป็นผลวัดหรือสัดส่วนการใช้ RAM ของ firmware ใดโดยเฉพาะ
ESP32 กับการตั้งค่า ESP-IDF แต่ละชุดอาจมีหน่วยความจำที่มี capability ต่างกัน เช่น internal memory และพื้นที่ภายนอกที่เปิดใช้ตามฮาร์ดแวร์ บางงานต้องการพื้นที่ที่ตรงข้อกำหนดเฉพาะ จึงไม่สามารถคิดว่ามี PSRAM เหลือแล้วการจัดสรรทุกชนิดจะผ่านเหมือนกัน
ควรเริ่มจาก API หรือไลบรารีที่ขอพื้นที่นั้นว่าต้องการ capability ใด รวมถึง buffer ที่เกี่ยวกับ peripheral หรือเส้นทางการทำงานเฉพาะ เมื่อรู้เงื่อนไขแล้วจึงเก็บข้อมูลพื้นที่ชนิดเดียวกัน ไม่ใช้ตัวเลขจากหน้าสรุปรวมมาทับข้อจำกัดของงานจริง
ตัวอย่างโค้ดอ่านค่าด้านล่างเลือก MALLOC_CAP_8BIT เพื่อแสดงวิธีดูข้อมูลในกลุ่มเดียวกัน ต้องเปลี่ยนเงื่อนไขให้ตรงการจัดสรรที่กำลังตรวจ และไม่ได้หมายความว่าค่านี้เท่ากับ internal RAM ทั้งหมด
#include "esp_heap_caps.h"

size_t free_bytes = heap_caps_get_free_size(MALLOC_CAP_8BIT);
size_t largest_bytes = heap_caps_get_largest_free_block(MALLOC_CAP_8BIT);
size_t minimum_bytes = heap_caps_get_minimum_free_size(MALLOC_CAP_8BIT);
minimum free size เป็นข้อมูลจุดต่ำที่ระบบติดตามตามขอบเขตของ allocator ไม่ใช่ปริมาณที่กำลังว่างในตอนเรียก จึงควรเก็บแยกชื่อ field กับค่าปัจจุบันเพื่อไม่ให้กราฟคนละความหมายถูกนำมาเทียบกันผิด
การอ่านค่าเฉพาะตอนบูตอาจไม่เห็นช่วงใช้พื้นที่สูง เช่น เริ่ม TLS รับ payload ใหญ่ หรือเตรียมข้อมูลส่งออก จึงควรเลือกจุดวัดตามวงจรของงานที่สงสัย พร้อมรหัสรอบเพื่อผูกว่ากำลังดูเหตุการณ์เดียวกันอยู่
ตัวอย่างแผนตรวจอาจเก็บก่อนเริ่มการเชื่อมต่อ หลังรับข้อมูล หลังแปลงข้อมูล และหลังปิด handle แล้ว โดยควรจำกัด log ให้พอเห็นภาพ การพิมพ์ข้อมูลทุกจังหวะอย่างถี่มากอาจเปลี่ยนการใช้เวลาและทรัพยากรจนต่างจากงานที่ต้องการตรวจได้
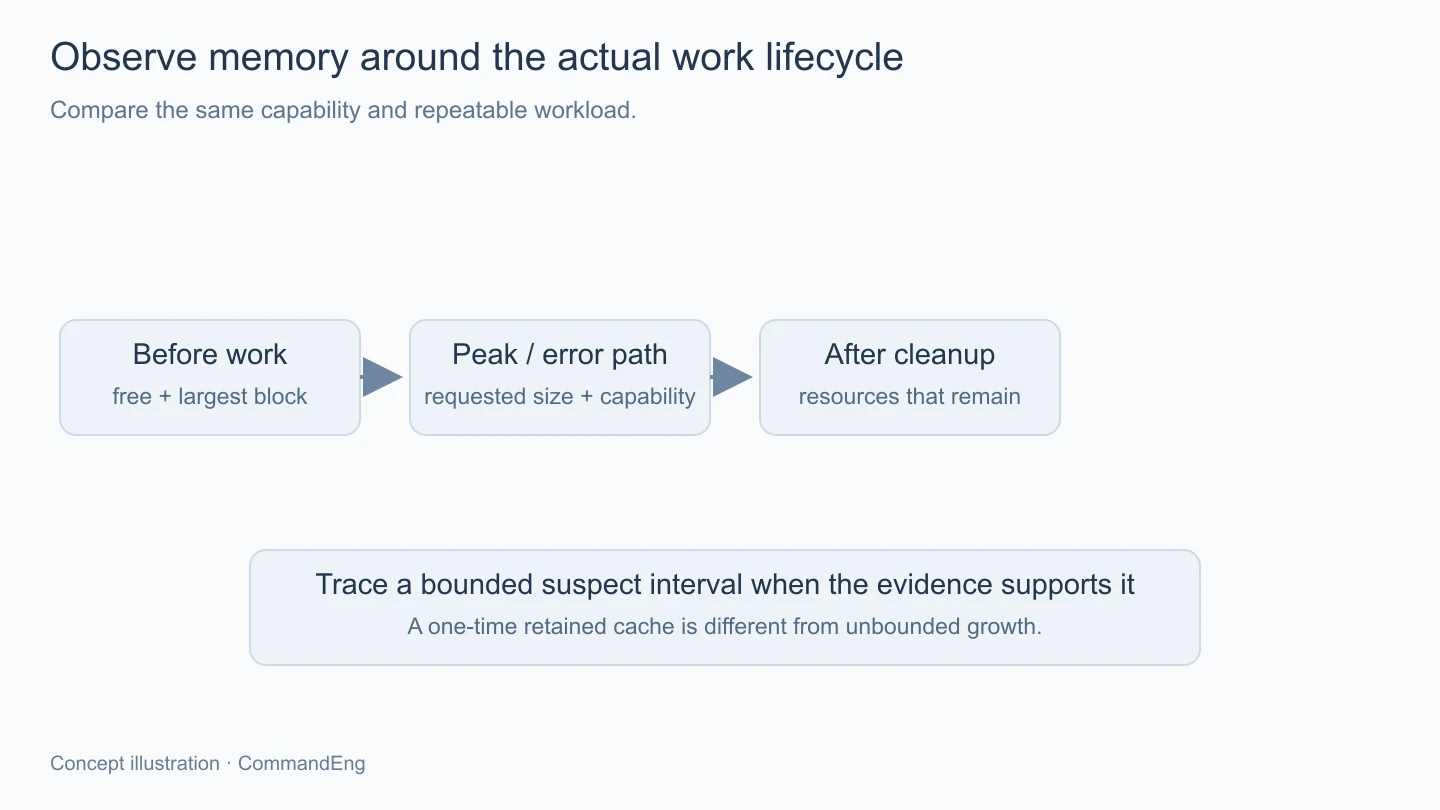
ถ้าหลังจบงานพื้นที่ไม่กลับมาเท่าเดิม ต้องดูก่อนว่ามี cache หรือทรัพยากรที่ตั้งใจเก็บไว้หรือไม่ การจองครั้งแรกแล้วคงไว้ไม่เหมือนการเพิ่มขึ้นทุกครั้งโดยไม่มีขอบเขต จึงควรเปรียบเทียบหลายรอบหลังระบบเข้าสู่สภาพที่เทียบกันได้
ในอีกด้านหนึ่ง ถ้าจำนวนว่างรวมกลับมาแต่ก้อนใหญ่สุดเปลี่ยนไป ก็เป็นข้อมูลให้ตามรูปแบบ allocation ต่อ แต่ยังไม่ใช่ข้อสรุปว่า fragmentation เป็นสาเหตุเดียวของทุกความล้มเหลว ต้องมีขนาดและ capability ของคำขอที่ไม่ผ่านมาประกอบด้วย
Memory leak เกี่ยวกับพื้นที่ที่ไม่ถูกคืนตามวงจรที่ควรเป็น ส่วน heap corruption อาจเกิดจากการเขียนเกินขอบเขต ใช้ pointer หลังคืน หรือจัดการ buffer ผิด เมื่อ allocator ตรวจพบทีหลัง ตำแหน่งที่ crash อาจไม่ใช่จุดแรกที่เขียนข้อมูลเสีย
ESP-IDF มีเครื่องมือ heap tracing กับการตรวจความสมบูรณ์ของ heap ให้ใช้ตามการตั้งค่า เมื่อมีจุดสงสัยแล้วสามารถจำกัดช่วง trace ให้ครอบงานนั้น และตาม allocation ที่ยังค้างกลับไปยังจุดเรียก โดยคำนึงว่าการเปิดเครื่องมือก็ใช้หน่วยความจำกับเวลาเพิ่มด้วย
ควรเริ่มจากวงจรที่ทำซ้ำได้และเลือกข้อมูลขนาดคงที่ก่อน ถ้าทุกครั้งเปลี่ยนทั้ง payload จำนวน connection และงานพร้อมกัน ผลที่ได้จะตามสาเหตุยากขึ้น แม้จะมีตัวเลขจำนวนมากก็ตาม
ส่วน stack ของ task เป็นอีกเรื่องที่ต้องตรวจตามเครื่องมือของ task ไม่เอาตัวเลข free heap เพียงอย่างเดียวไปยืนยันว่า stack ไม่มีปัญหา และต้องดูหน่วยของ API ตาม SDK ที่ใช้ เพราะชื่อคล้ายกันในสภาพแวดล้อมต่างกันอาจรายงานหน่วยไม่ตรงกัน
เมื่อพบว่ามี buffer ใหญ่หลายชุดอยู่พร้อมกัน อาจพิจารณาลดการคัดลอก ประมวลผลเป็นช่วง หรือจำกัดจำนวนงานที่เริ่มพร้อมกัน แต่ต้องตรวจว่าการเปลี่ยนนี้ยังตรงข้อกำหนดของ protocol กับอายุข้อมูล ไม่ตัดแบ่งแบบที่ทำให้ข้อมูลไม่ครบ
ถ้าเกี่ยวกับวงจร error ให้ตรวจการคืนทรัพยากรทั้งกรณีสำเร็จ timeout และยกเลิกงาน เพราะบอร์ดที่ทำงานปกติผ่านหลายรอบอาจยังสะสมพื้นที่เฉพาะตอนเครือข่ายมีปัญหาได้ การทดสอบจึงควรมีเส้นทางเหล่านี้ก่อนสรุปว่าปัญหาหายแล้ว
การเตรียม buffer ใช้ซ้ำอาจช่วยให้ควบคุมขนาดกับอายุได้ แต่ก็จองพื้นที่ค้างไว้อีกแบบ จึงต้องเลือกจากสิ่งที่วัดพบและความต้องการของงาน บทนี้ยังไม่มีตัวเลขจากบอร์ดจริงที่จะใช้ตัดสินว่าแนวทางใดประหยัดพื้นที่ได้มากกว่ากัน
Heap ว่างรวมเป็นเพียงส่วนหนึ่งของคำตอบ ต้องดู largest block, capability และจังหวะการใช้พื้นที่ร่วมกันด้วย เมื่อเก็บข้อมูลตามวงจรงานแล้วค่อยใช้เครื่องมือ tracing หรือ integrity check ในจุดที่มีเหตุรองรับ เราจะเลือกแก้การจอง คืน หรือจัดลำดับงานได้ตรงขึ้น โดยไม่ใช้ตัวเลข RAM ค่าเดียวตัดสินทุกอาการ