


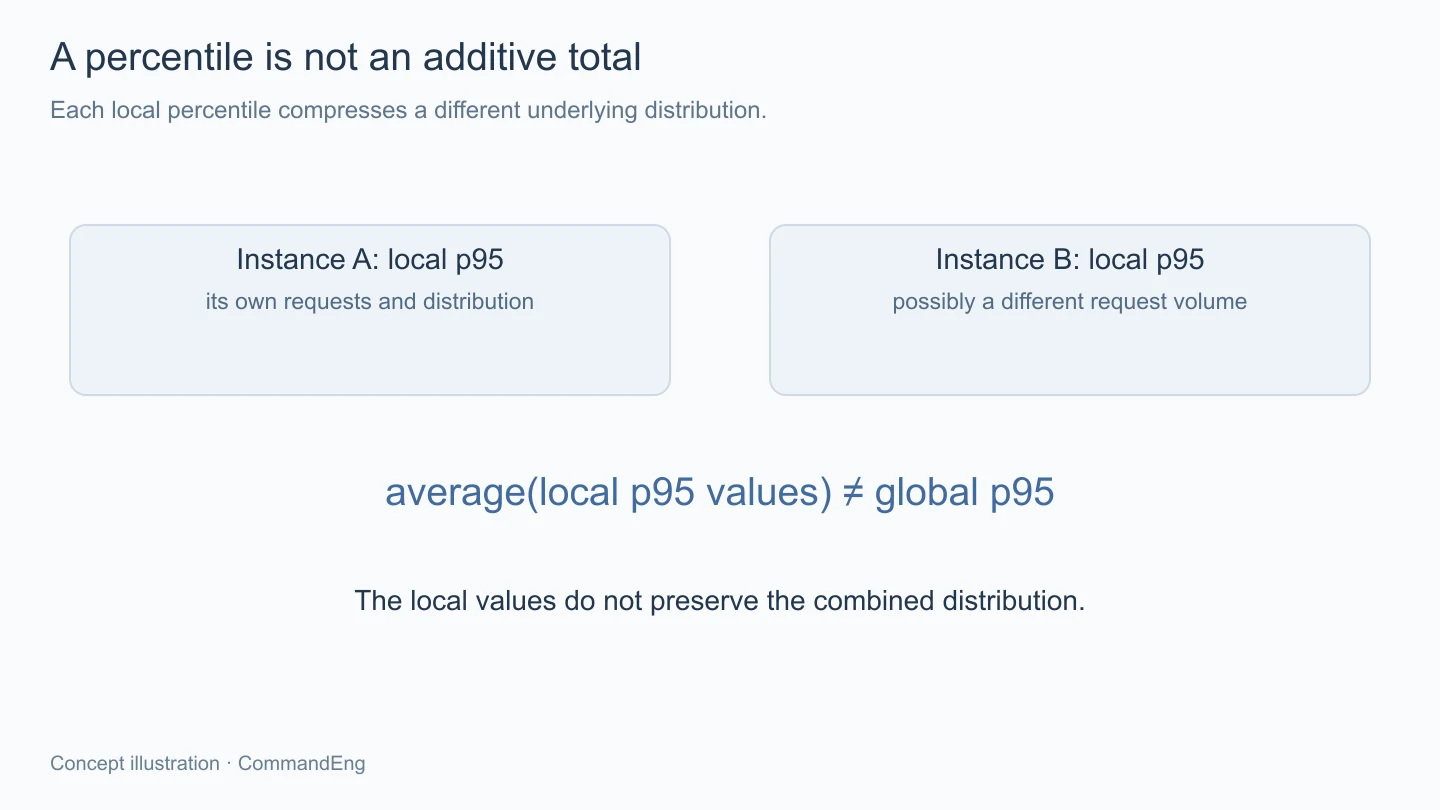
กราฟเวลาตอบสนองที่มีค่าเฉลี่ยดูอ่านง่ายดี แต่ถ้างานส่วนมากเสร็จเร็วและมีบางส่วนรอนาน ค่าเดียวก็อาจเล่าอาการของคนที่รอไม่ครบ เราจึงมักเพิ่ม percentile อย่าง p95 เพื่อมองช่วงปลายของข้อมูลให้ชัดขึ้น
พอระบบมีหลายเครื่อง แต่ละเครื่องก็อาจมี p95 ของตัวเอง แล้วเกิดคำถามต่อว่าเอาค่าเหล่านี้มาเฉลี่ยเพื่อให้เหลือกราฟเดียวได้ไหม หน้าตามันเป็นตัวเลขเวลาเหมือนกัน แต่ความหมายเบื้องหลังต่างจากยอดที่นำมาบวกกันได้ตรงๆ
ก่อนรวมค่าจึงควรย้อนมาดูว่าตัวเลขนั้นถูกสร้างจากข้อมูลแบบใด และการรวมที่ทำยังรักษาความหมายของคำว่าทั้งระบบอยู่หรือเปล่าครับ
Percentile อธิบายตำแหน่งของค่าเมื่อมองการกระจายของข้อมูล โดย p95 ใช้บอกขอบเขตที่ข้อมูลส่วนใหญ่ประมาณร้อยละ95อยู่ไม่เกินค่านั้น ตามวิธีคำนวณและการประมาณของเครื่องมือ จึงช่วยมองกลุ่มที่ช้ากว่าค่ากลางได้ แต่ไม่ได้บอกเวลาของคำขอที่ช้าที่สุด
ถ้าเครื่องหนึ่งรับงานมากกว่าอีกเครื่องมาก p95 ของทั้งสองก็ยังปรากฏเป็นสองค่าเท่ากันบนหน้าจอ การนำมาเฉลี่ยให้น้ำหนักแต่ละเครื่องเท่ากันทั้งที่จำนวนงานต่างกัน จึงไม่แทนตำแหน่งของข้อมูลคำขอทั้งหมด และแม้ถ่วงน้ำหนักด้วยจำนวนงาน ก็ยังไม่สามารถกู้การกระจายเดิมจาก percentile เพียงค่าเดียวได้ทั่วไป
เพราะฉะนั้นจุดที่ต้องรวมคือข้อมูลที่รักษาการกระจายไว้ได้ตามรูปแบบที่ใช้ ไม่ใช่รีบคำนวณ percentile แต่ละเครื่องให้เสร็จก่อนแล้วค่อยหาวิธีเฉลี่ยตัวเลขปลายทาง
สำหรับ classic histogram ของ Prometheus เราจะมีจำนวนการสังเกตที่อยู่ไม่เกินขอบแต่ละ bucket พร้อมผลรวมและจำนวนทั้งหมด ขอบเขตของ bucket จึงเป็นส่วนหนึ่งของข้อมูลที่ต้องรู้ ไม่ใช่ label ที่ตัดออกได้เพราะทำให้กราฟดูรก
Bucket เหล่านี้เป็นแบบสะสม เช่น ค่าที่อยู่ไม่เกินขอบแรกจะนับรวมอยู่ใน bucket ที่มีขอบสูงกว่าด้วย หากนำจำนวนทุก bucket มาบวกกันเป็นจำนวน request ก็จะนับข้อมูลเดิมซ้ำ วิธีอ่านต้องรักษาความหมายว่าแต่ละชุดบอกจำนวนที่อยู่ไม่เกินขอบนั้น
ตัวอย่างนี้เลือกอธิบาย classic histogram เพื่อให้เห็นโครง bucket ที่พบได้ในระบบเดิม ส่วน native histogram มีการเก็บและ query ต่างออกไป ต้องตรวจการรองรับของ library และระบบจัดเก็บที่ใช้จริง ไม่เปลี่ยนชื่อ metric แล้วคาดว่าคำสั่งของทั้งสองรูปแบบใช้แทนกันได้ทุกจุด
เมื่อ classic histogram ของแต่ละ instance ใช้ขอบ bucket ที่เข้ากันได้ เราสามารถรวมอัตราของ bucket ตามขอบเดียวกัน แล้วจึงใช้ histogram_quantile ประมาณ percentile จากชุดที่รวมแล้ว ตัวอย่างชื่อ metric ต่อไปนี้เป็นของสมมติและยังไม่ได้รันกับระบบจริง
histogram_quantile(
  0.95,
  sum by (service, le) (
    rate(app_request_duration_seconds_bucket[5m])
  )
)
ส่วน le ต้องคงไว้เพื่อบอกขอบ bucket สำหรับ classic histogram และควรกรอง environment กับกลุ่มงานให้ตรงตามที่ตั้งใจ หากรวม endpoint อ่านข้อมูลเล็กๆ กับงานส่งออกรายงานที่ใช้เวลาต่างกันมาก ค่าเดียวอาจตอบคำถามด้านหนึ่งได้ แต่ซ่อนอาการของงานอีกกลุ่มไปด้วย
ต้องตรวจขอบ bucket ข้ามรุ่นของ instrumentation เช่นกัน หากบาง instance เปลี่ยนชุดขอบไปแล้ว ไม่ควรถือว่าการรวม label ชื่อเหมือนกันบางส่วนยังได้การกระจายเดียวที่ครบถ้วน การเปลี่ยนรูปแบบ metric จึงต้องมีแผนตรวจข้อมูลช่วงที่ระบบหลายรุ่นทำงานร่วมกัน
หน่วยก็ต้องตรงกันทั้งเส้นทาง ชื่อที่ระบุ seconds กับ panel ที่แสดง milliseconds ต้องมีการแปลงอย่างชัดเจน และไม่ควรนำ histogram ที่นับคนละขั้นของงานมารวมกันเพียงเพราะมีชุด bucket คล้ายกัน
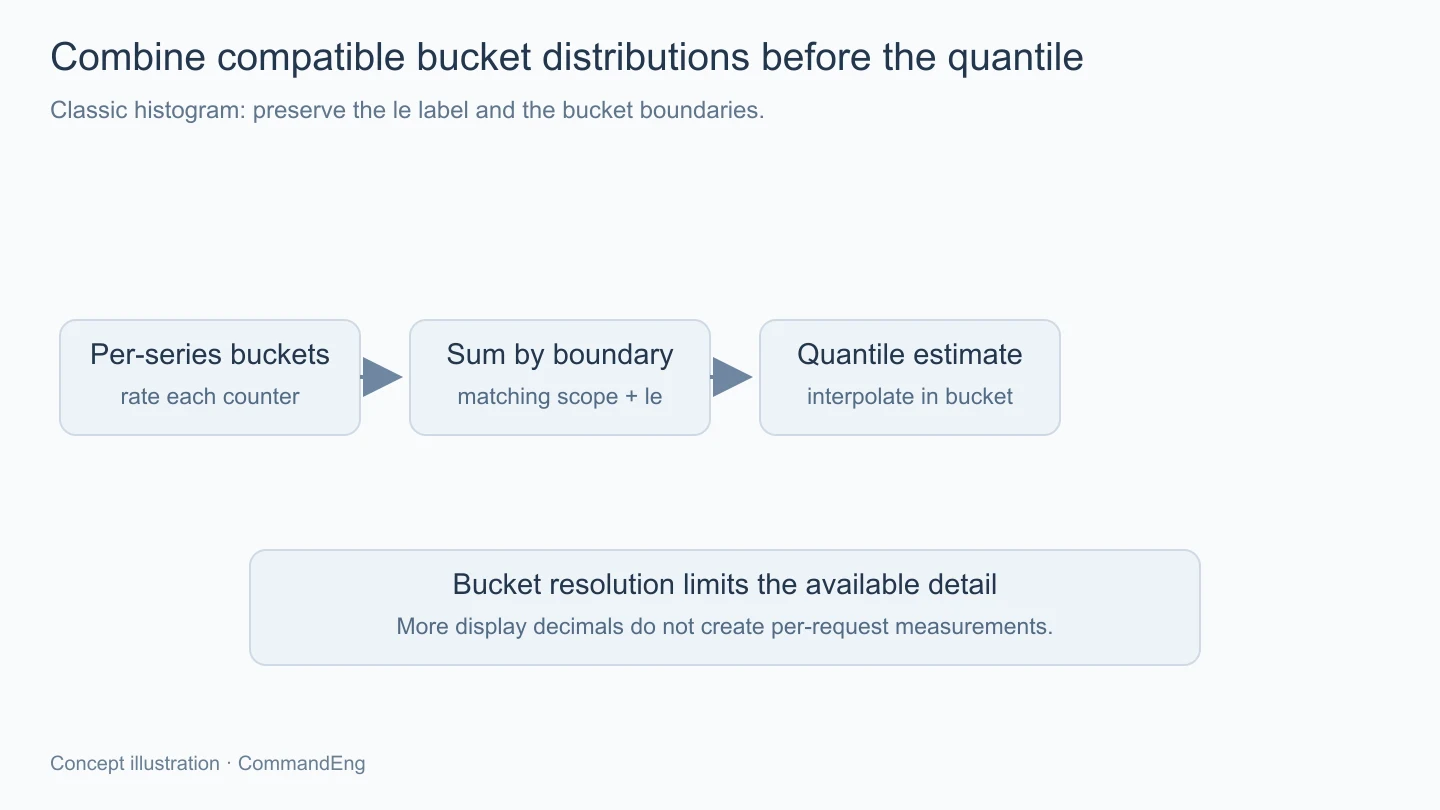
Histogram ไม่ได้เก็บเวลาของแต่ละ request ไว้ทุกตัว หากตำแหน่ง percentile อยู่ระหว่างขอบ bucket เครื่องมือต้องประมาณค่าภายในช่วงนั้น สำหรับ classic histogram วิธีที่เอกสารระบุคือการประมาณตามการกระจายสม่ำเสมอใน bucket ที่เกี่ยวข้อง
หากช่วงที่สนใจกว้างมาก ความละเอียดของคำตอบก็มีข้อจำกัดตามนั้น การแสดงทศนิยมหลายตำแหน่งไม่ได้เพิ่มรายละเอียดที่ต้นทางไม่เคยเก็บไว้ ก่อนใช้ค่าไปตัดสินเรื่องใกล้เส้นเป้าหมายจึงควรดูการจัด bucket ให้สัมพันธ์กับช่วงเวลาที่งานยอมรับได้ด้วย
กรณีไม่มี observations ก็ต้องแสดงและอ่านตามสถานะข้อมูล ไม่ตั้งชื่อค่าที่ไม่เกิดขึ้นว่าเร็วเป็นศูนย์ และเมื่อจำนวนงานน้อยมาก percentile ก็ไวต่อองค์ประกอบของชุดนั้น ควรแสดงปริมาณงานหรือจำนวน observations ควบคู่เพื่อให้คนดูรู้ว่ากำลังตัดสินจากข้อมูลหนาแน่นแค่ไหน
ถ้าต้องการดู p95 ของผู้ใช้ทั้งบริการ การรวมการกระจายที่เข้ากันได้ก่อนคำนวณมีความหมายตรงกว่า แต่หากต้องการหา instance ที่ผิดปกติ การแยกเส้นตาม instance ก็ยังมีประโยชน์ การทำให้เหลือค่าเดียวจึงไม่จำเป็นต้องเป็นเป้าหมายของทุกหน้า
ส่วนกรณีใช้ summary ที่คำนวณ quantile มาจากตัวแอปแล้ว ต้องระวังว่า quantile เหล่านั้นนำมารวมเพื่อหา p95 ทั้งบริการไม่ได้ตามหลักเดียวกัน ควรเลือกวิธีเก็บตั้งแต่ต้นตามคำถามที่ต้องการ ไม่พยายามแก้ด้วยฟังก์ชันเฉลี่ยบน dashboard ในภายหลัง
ก่อนใช้งานควรตรวจชนิด metric หน่วย ช่วงเวลา ขอบ bucket และจำนวนงานร่วมกัน รวมทั้งตรวจว่าคำขอที่ล้มเหลวหรือหมดเวลาถูกนับอย่างไร บทนี้ไม่มีผล benchmark ของระบบผู้ใช้ ภาพทั้งหมดอธิบายลำดับการตีความข้อมูล ไม่ใช่การกระจายเวลาที่วัดมาแล้ว
Percentile เป็นข้อมูลเกี่ยวกับตำแหน่งในการกระจาย จึงไม่ควรถูกเฉลี่ยข้ามเครื่องเพื่ออ้างว่าเป็น percentile ของระบบ การรวม histogram ที่มีขอบเข้ากันได้ก่อนคำนวณ ช่วยรักษาความหมายของข้อมูลได้ดีกว่า แต่ยังต้องอ่านพร้อมช่วงเวลา ปริมาณงานและข้อจำกัดของการประมาณ เพื่อให้กราฟตอบคำถามได้ตรงตามที่ตั้งใจ