เปิด autoscale แล้ว ยังต้องเตรียมอะไรให้แอปอีก
พอแอปเริ่มมีคนใช้มากขึ้น เราอาจอยากให้ระบบเพิ่มจำนวน Pod ตามภาระโดยไม่ต้องนั่งปรับเอง และเมื่อเห็นตัวอย่าง HPA ที่กำหนดค่าเป้าหมาย CPU ไว้ไม่กี่บรรทัด ก็ดูเหมือนเป็นขั้นต่อไปที่ทำได้ไม่ยาก
แต่การเพิ่ม replica จะช่วยได้เมื่อสิ่งที่เพิ่มขึ้นมารับงานร่วมกับตัวเดิมได้จริงครับ ถ้าคอขวดอยู่ที่บริการอื่น หรือแอปยังเก็บสถานะสำคัญไว้ในเครื่องของตัวเอง การมีหลาย Pod อาจทำให้ต้องดูแลปัญหาเพิ่มโดยที่เวลาตอบสนองยังไม่ได้ดีขึ้น
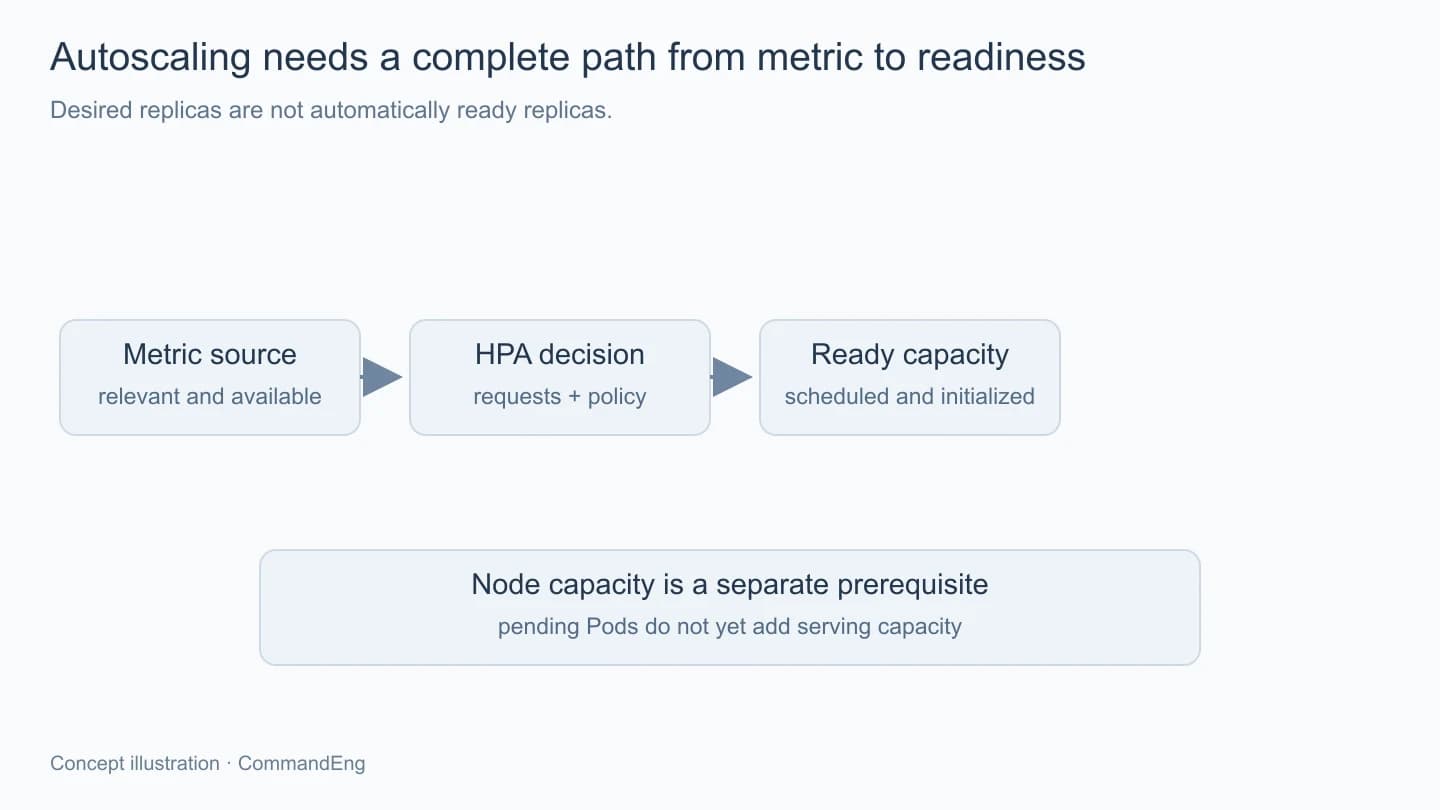
ก่อนเปิด autoscale ลองเริ่มจากเส้นทางของงานกับ metric ที่จะใช้ตัดสิน แล้วค่อยตรวจว่าคลัสเตอร์มีพื้นที่และแอปมี lifecycle รองรับการเพิ่มลดตามที่ต้องการหรือไม่
เลือก metric ที่สัมพันธ์กับภาระที่ต้องแก้
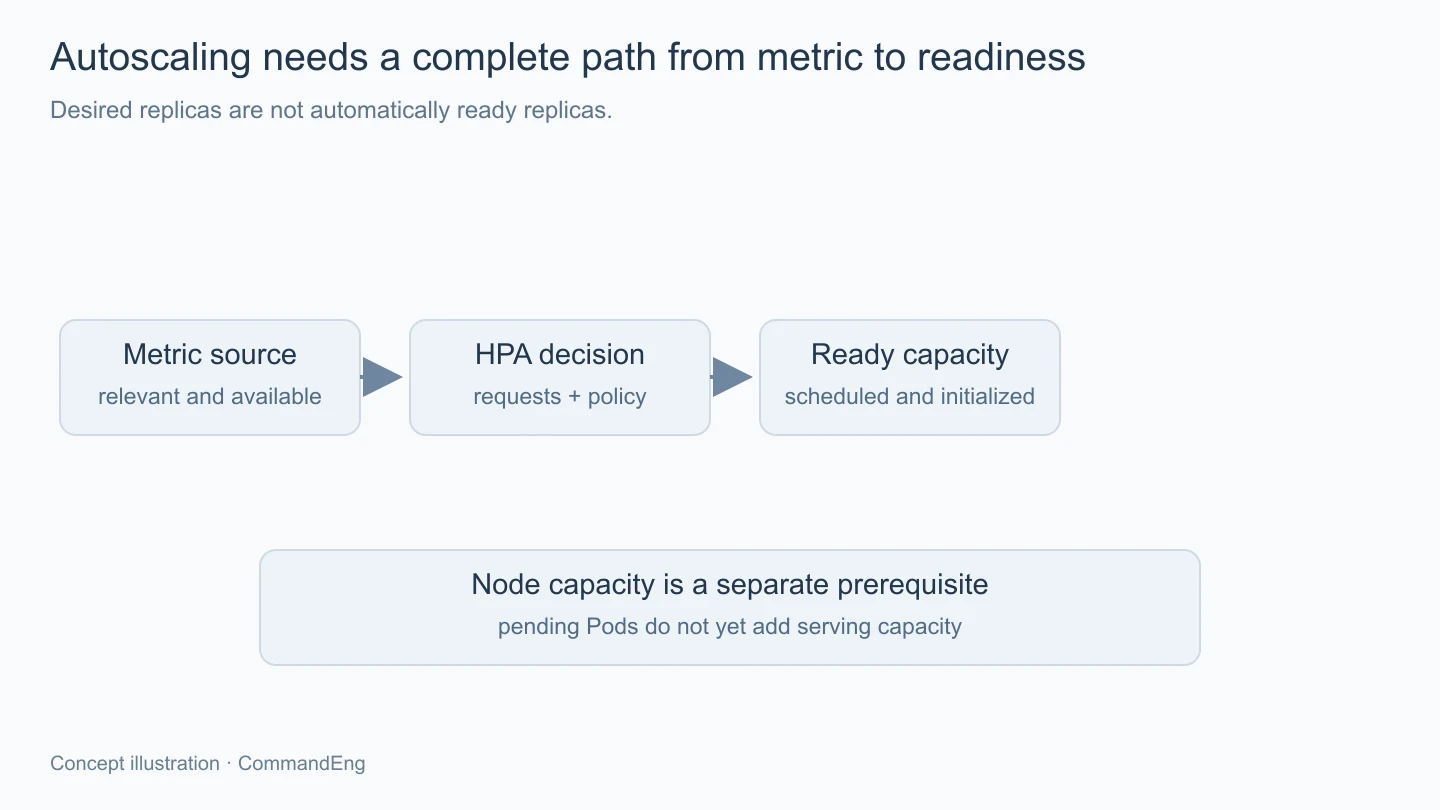
HPA ใช้ข้อมูล metric ตามรูปแบบที่ตั้งและระบบรองรับเพื่อประเมินจำนวน replica แต่ค่าที่อ่านได้ต้องมีความหมายกับงาน เช่น CPU อาจเหมาะกับบางการประมวลผล ส่วนงานรอคิวหรือรอปลายทางอาจต้องดูข้อมูลอีกแบบร่วมด้วย
ถ้าใช้ CPU utilization ค่า request เป็นฐานของการคำนวณตามการตั้งค่า จึงต้องตรวจ resource requests กับขอบเขต container ที่นำมาคิดให้ตรง ไม่ใส่เป้าหมายเป็นเปอร์เซ็นต์แล้วเข้าใจว่าเป็นสัดส่วนของเครื่องจริงทั้งหมดเสมอไป
สูตรพื้นฐานใช้ความสัมพันธ์ระหว่างจำนวนปัจจุบัน ค่าที่เห็น และค่าเป้าหมาย แต่การทำงานจริงยังมี tolerance, ความพร้อมของ Pod, ข้อมูลที่ขาด และนโยบายอื่นเข้ามา จึงไม่ควรคำนวณครั้งเดียวจากตัวเลขบนจอแล้วถือว่ารอบถัดไปต้องได้จำนวนตรงนั้นแน่นอน
ต้องมีแหล่ง metric ที่พร้อมตามชนิดที่เลือกด้วย เช่น resource metrics หรือ adapter สำหรับข้อมูลอื่น การมี object HPA อยู่ไม่ได้ยืนยันว่ามันอ่านข้อมูลสำเร็จ ควรดูสถานะกับเหตุการณ์ประกอบว่าระบบกำลังตัดสินจากข้อมูลใดจริง
เพิ่ม Pod ได้ ไม่ได้แปลว่ามี Node ให้ลงเสมอ
หาก HPA ขอจำนวนเพิ่มแต่ Node ไม่มีทรัพยากรจัดวางเพียงพอ Pod ใหม่ก็อาจยังรออยู่ ตัวควบคุมเพิ่ม replica กับกลไกเพิ่มความจุ Node เป็นงานคนละส่วน ต้องมีแผนความจุตามระบบที่เลือก ไม่ใช้ maxReplicas เป็นคำรับรองว่าคลัสเตอร์รันได้ถึงค่านั้นทันที
ข้อจำกัดอย่าง quota, การกระจาย Pod หรือทรัพยากรที่แอปต้องใช้ร่วมก็มีผลต่อการจัดวาง จึงควรตรวจทั้งจำนวนที่ต้องการ จำนวนที่สร้าง และจำนวนที่พร้อมรับงาน ไม่มองเพียงตัวเลข desired แล้วถือว่ากำลังรับโหลดด้วยทุกตัวแล้ว
ช่วงเริ่ม Pod ยังมีเวลาย้ายไฟล์ image เตรียมแอป และรอ readiness หากภาระมาเร็วกว่าเวลาที่พร้อม งานอาจค้างหรือล้มก่อนตัวใหม่เข้าช่วย จึงต้องวางค่าขั้นต่ำหรือวิธีรับช่วงตามรูปแบบโหลดจริง ไม่หวังให้การปรับจำนวนย้อนหลังทันทุกเหตุการณ์
การมี UAT ที่เล็กกว่า production ทำได้ตามโจทย์ แต่เมื่อจะทดสอบ autoscale ควรมีความจุและเส้นทางพึ่งพาที่พอจำลองสิ่งที่ต้องการตรวจ ไม่ทดสอบในระบบที่ขึ้นถึงจำนวนใหม่ไม่ได้แล้วสรุปพฤติกรรมแอปจากผลนั้นเพียงอย่างเดียว
สถานะในเครื่องต้องมีความหมายเมื่อมีหลายตัว
ถ้า session, ไฟล์อัปโหลด หรือข้อมูลที่ต้องใช้ต่ออยู่ในพื้นที่เฉพาะ Pod คำขอรอบถัดไปที่ไปอีกตัวอาจเห็นข้อมูลไม่เหมือนเดิม การเปิด HPA จึงควรเริ่มจากรู้ว่าสถานะใดเป็นของแต่ละ worker และสถานะใดต้องถูกใช้ร่วมตามการออกแบบ
cache ก็ต้องมีวิธีรับมือเมื่อบาง Pod ยังไม่มีข้อมูลหรือเก็บคนละอายุ ไม่เอาพฤติกรรมบนตัวเดียวที่ warm อยู่แล้วไปแทนตัวที่เพิ่งเริ่ม ส่วนงานเบื้องหลังต้องดูด้วยว่าการเพิ่ม instance จะทำให้หลายตัวเริ่มงานตามตารางเดียวกันซ้ำหรือไม่
ถ้ามี queue งาน ควรกำหนดวิธีรับ ยืนยัน และลองซ้ำให้ถูกตาม semantics ของระบบ การมี worker เพิ่มช่วยความจุได้ แต่ไม่ได้แทนการป้องกันผลซ้ำของงานที่อาจถูกส่งกลับมาหลัง worker หยุด
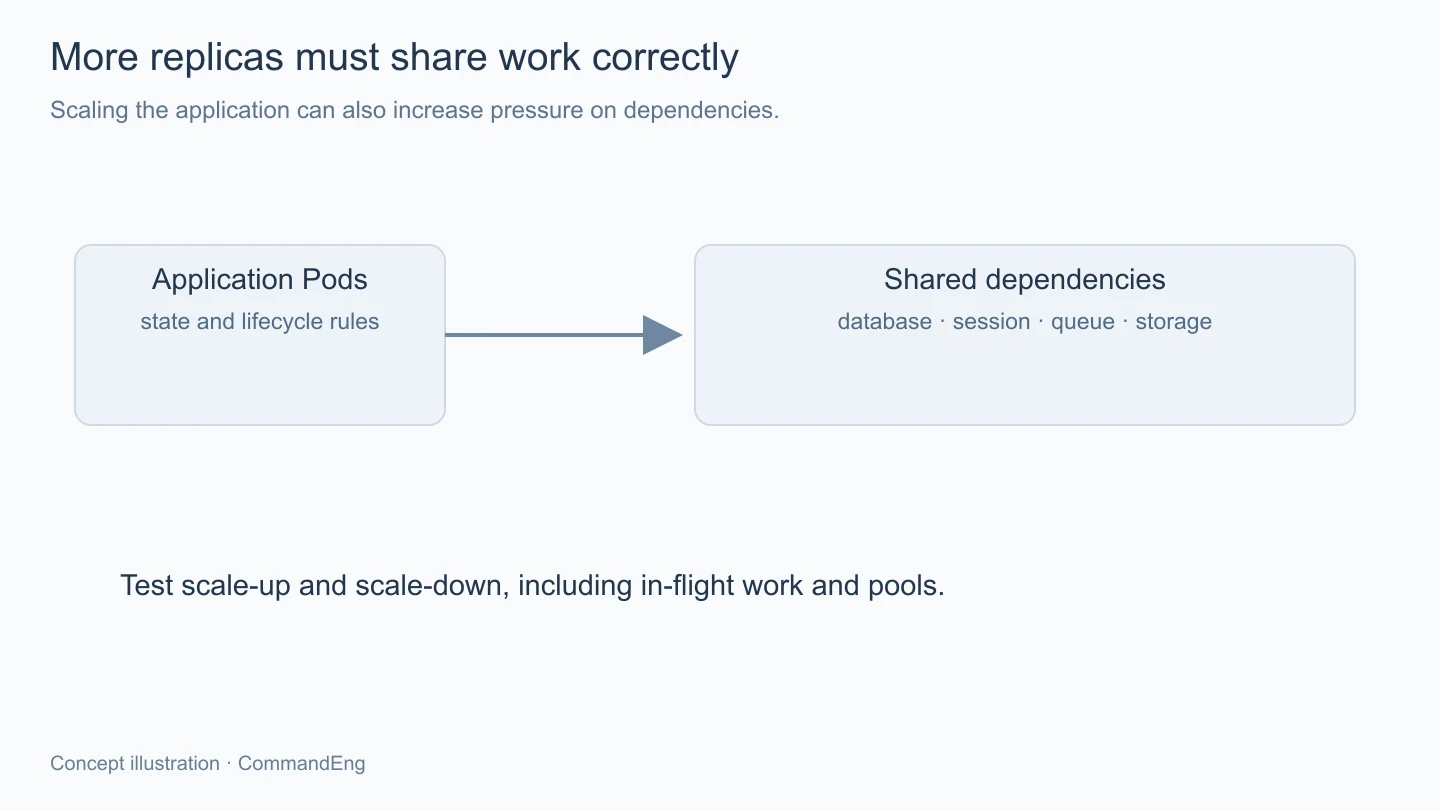
ฐานข้อมูลและบริการร่วมอาจรับภาระเพิ่มตามจำนวน
แต่ละ replica อาจเปิด connection pool ของตัวเอง เมื่อจำนวนเพิ่ม ภาระที่ฐานข้อมูลเห็นก็เพิ่มตามขอบเขต pool และงานที่ไหลเข้ามา ไม่ใช่กระจายเฉพาะ CPU ของแอปโดยไม่มีผลต่อปลายทาง
ถ้าความช้าเกิดจากฐานข้อมูลอยู่แล้ว การเพิ่มตัวแอปอาจเพิ่มคำขอค้างหรือการแย่งทรัพยากร จึงควรดูเวลารอ สถานะบริการร่วม และอัตราผิดพลาดควบคู่กับจำนวน Pod เพื่อรู้ว่าการขยายกำลังแก้คอขวดหรือย้ายภาระไปอีกจุด
เพดาน HPA จึงควรมาจากความจุครบเส้นทางและผลทดสอบ ไม่ใส่สูงมากเพื่อให้ดูว่ารับคนได้เยอะโดยไม่มีข้อมูลปลายทางรองรับ และควรมีทางจำกัดหรือรับภาระเกินตามที่งานออกแบบ ไม่ปล่อยให้ทุกชั้นสะสมงานต่อกันไม่สิ้นสุด
การลดจำนวนก็ต้องรักษางานที่กำลังทำ
เมื่อโหลดลด Pod บางตัวจะหยุดตามกลไกที่เกี่ยวข้อง แอปควรหยุดรับงานใหม่และจัดการคำขอหรือคิวที่อยู่ระหว่างทำในเวลาที่เหมาะสม ไม่สมมติว่าการเพิ่มจำนวนทำงานได้แล้วการลดจะไม่มีผลอะไร
นโยบาย stabilization และอัตราเปลี่ยนจำนวนช่วยจัดพฤติกรรมการแกว่งตามที่รองรับ แต่ควรเลือกจากความเร็วเริ่มแอปกับรูปแบบโหลดจริง ไม่เพิ่มช่วงรอแบบเดียวกับทุกงานและไม่ปิดการลดตลอดเพียงเพราะยังไม่เคยทดสอบ lifecycle ให้ครบ
ทดสอบจากน้อยไปมากแล้วดูผลต่อผู้ใช้
เริ่มจากภาระที่รู้รูปแบบ เพิ่มตามขอบเขตในชุดทดสอบ แล้วเก็บ metric ที่ HPA ใช้ จำนวนที่ขอ จำนวนพร้อม และผลที่ผู้ใช้ได้รับตามเวลาเดียวกัน หลังจากนั้นค่อยทดสอบตอนลดโหลดกับตอน dependency ช้าเพื่อดูพฤติกรรมที่ต่างกัน
แผนภาพในบทใช้จัดเส้นทางตัดสินใจ ส่วนการรายงานผล load test ต้องเก็บ configuration รุ่นแอป รูปแบบโหลด และสภาพปลายทางไว้ให้ทำซ้ำได้ ค่าความจุที่นำไปใช้ต่อจึงควรอ้างถึงผลกับเงื่อนไขชุดนั้น ไม่แปลงจากจำนวนที่ตั้งไว้เป็นความสามารถของระบบโดยตรง
ควรกำหนดด้วยว่าใครเป็นเจ้าของจำนวน replica เมื่อมี HPA ทำงาน หาก pipeline หรือเครื่องมืออื่นเขียนค่ากลับทุกครั้งโดยไม่สอดคล้องกัน ผลที่เห็นอาจมาจากตัวควบคุมหลายตัวสลับแก้ ไม่ใช่การตอบสนองต่อโหลดของ HPA อย่างเดียว
สรุป
HPA ต้องมีทั้ง metric ที่ตรงปัญหา ความจุให้ Pod พร้อม และแอปที่รับงานหลายตัวร่วมกันได้ เมื่อทดสอบทั้งการเพิ่ม ลด และผลต่อบริการที่พึ่งอยู่ เราจะรู้ว่า autoscale ช่วยตรงไหนจริง และตั้งขอบเขตของ production ได้จากหลักฐานมากกว่าจำนวน replica สูงสุดที่ใส่ไว้ในไฟล์ครับ

