


เว็บที่มีบทความมากขึ้นมักมีลิงก์ระหว่างเรื่องตามไปด้วย ทั้งลิงก์แนะนำเนื้อหาที่เกี่ยวข้อง เมนูแท็ก และภาพที่เก็บแยกจากตัวบท เวลาเปลี่ยนชื่อ ย้ายหน้า หรือจัดไฟล์ใหม่ หน้าที่กำลังแก้อาจยังเปิดได้ แต่ลิงก์จากอีกหน้าที่ชี้มาหาอาจค้างอยู่ที่เดิม
การเปิดบทความทีละหน้าแล้วเห็นว่าเนื้อหาขึ้นจึงยังไม่ตอบว่าทุกทางที่คนอ่านกดต่อใช้งานได้ครบ ยิ่งหน้าเดียวมีหลายลิงก์ โอกาสที่จะตรวจข้ามบางจุดก็ยิ่งเพิ่ม และพอพบ URL ที่เสียแล้วก็ยังต้องรู้ว่าถูกอ้างอยู่จากที่ไหนบ้าง
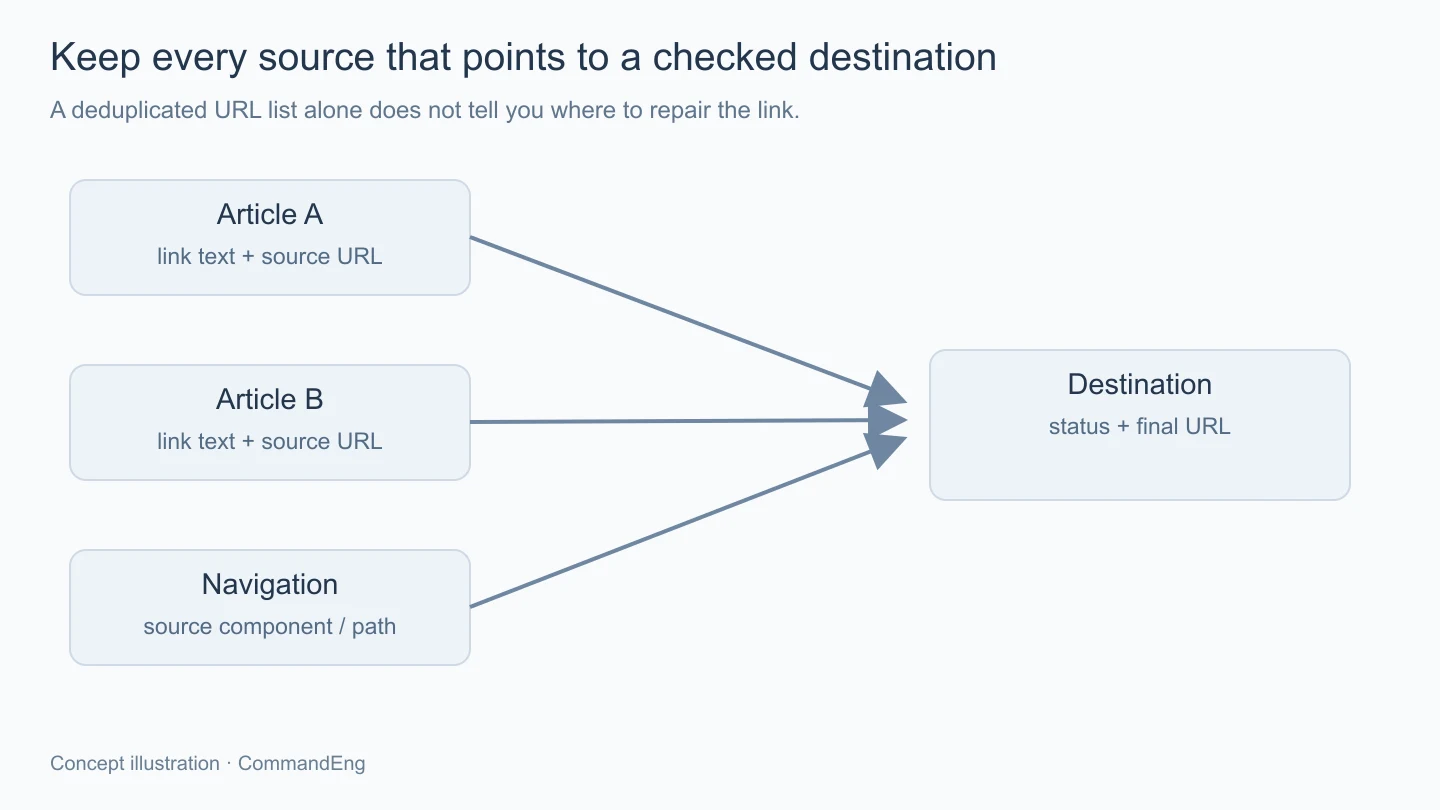
สิ่งที่ควรเก็บจึงเป็นความสัมพันธ์ระหว่างหน้าต้นทางกับลิงก์ปลายทางครับ จากนั้นค่อยตรวจผลของปลายทาง พร้อมแยกสาเหตุให้พอเลือกแก้ได้ ไม่รวมทุกอย่างที่ตอบไม่เหมือน 200 ว่าเป็นลิงก์เสียชนิดเดียวกัน
สมมติบทความสามเรื่องต่างชี้ไปยังคู่มือเดียวกัน ถ้าคู่มือนั้นถูกย้าย การตรวจที่เก็บเพียง URL ปลายทางจะบอกว่ามีปัญหาหนึ่งรายการ แต่ยังไม่บอกว่าต้องกลับไปแก้บทความใด การเก็บหน้าต้นทาง ข้อความลิงก์ และตำแหน่งที่เกี่ยวข้องช่วยให้ตามแก้ได้ครบ
สำหรับภาพก็คล้ายกัน ไฟล์หนึ่งอาจเป็นปกของบทความและถูกใช้ในหน้ารายการอีกหลายแห่ง หากลิงก์ภาพหาย ควรรู้ว่ามีหน้าสาธารณะใดอ้างไฟล์นั้น ไม่ตรวจเพียงว่าตัวบท Markdown ยังอ่านได้อยู่
ถ้าข้อมูลเริ่มจากฐานเนื้อหา สามารถดึงลิงก์จากต้นฉบับเป็นรายการตั้งต้นได้ แต่ยังควรตรวจหน้าที่ render แล้วด้วย เพราะเมนู layout และ component อาจเพิ่มลิงก์ที่ไม่มีในต้นฉบับ ส่วนลิงก์ที่ถูกสร้างหลัง JavaScript ทำงานก็ต้องใช้วิธีตรวจที่มองเห็นขั้นนั้นได้หากอยู่ในขอบเขตงาน
ฝั่งการค้นพบลิงก์ Google แนะนำรูปแบบ anchor ที่มี href เป็น URL ให้ตามได้ การมีข้อความที่คลิกด้วยโค้ดอย่างเดียวอาจใช้กับคนได้บางบริบท แต่ไม่ใช่สิ่งเดียวกับลิงก์ HTML ที่เครื่องมือตรวจรวบรวมได้โดยตรง จึงควรอ่านทั้งพฤติกรรมหน้าจอกับ markup ที่ส่งออก
ลิงก์แบบ relative ต้อง resolve เทียบกับ URL ของหน้าต้นทางอย่างถูกต้อง เช่น path ที่เริ่มด้วยเครื่องหมายทับกับ path ที่อ้างจาก directory ปัจจุบันให้ความหมายต่างกัน การนำข้อความ href มาต่อ string เองจึงเสี่ยงทำให้เครื่องมือตรวจไปขอคนละหน้ากับที่ browser จะเปิด
ควรใช้ตัวอ่าน URL ที่รองรับมาตรฐานของภาษาหรือ runtime ที่เลือก และเก็บทั้งค่าต้นฉบับกับ URL ที่ resolve แล้วไว้ตรวจย้อนกลับ ส่วน scheme อย่าง mailto หรือ tel ต้องแยกจาก HTTP เพราะไม่ใช่หน้าที่เครื่องมือตรวจควรส่ง GET ไปหา
Fragment หลังเครื่องหมาย # ก็ต้องตรวจอีกแบบ เพราะไม่ได้ถูกส่งเป็นส่วนของ request HTTP ไปที่ server การได้ 200 จากหน้าหลักจึงยังไม่ยืนยันว่า anchor ที่ลิงก์ชี้ถึงมีอยู่ในเอกสารจริง และบางแอปอาจใช้ fragment กับการนำทางของตัวเอง จึงต้องรู้รูปแบบเว็บก่อนเลือกกติกา
ส่วน query string ไม่ควรถูกตัดทิ้งทั้งหมดเพียงเพื่อรวมรายการซ้ำ เพราะบางหน้าจำเป็นต้องใช้มันเลือกเนื้อหา ขณะเดียวกันค่าติดตามบางชนิดอาจไม่เปลี่ยนหน้าที่ต้องตรวจ การจัดกลุ่มควรใช้กติกาที่อธิบายได้และเก็บ URL ต้นฉบับไว้ ไม่ทำให้หลักฐานหายไปจากการ normalize
404 บอกว่าไม่พบ representation ปัจจุบันหรือ server ไม่ยอมเปิดเผยว่ามีอยู่ ไม่ได้บอกในตัวเองว่าหายถาวร ส่วน 410 มีความหมายว่าทรัพยากรไม่พร้อมใช้และมีแนวโน้มเป็นถาวรตามที่ server ทราบ จึงควรเก็บสถานะตามที่ได้รับไว้ก่อนตัดสินสาเหตุ
Redirect อาจเป็นเส้นทางที่ตั้งใจรองรับ URL เก่าได้ แต่ต้องตามดูว่าจบที่หน้าใด มี loop หรือหลายทอดผิดปกติหรือไม่ หากลิงก์ภายในยังชี้ทางเก่าอยู่ตลอด การเปลี่ยนให้ชี้หน้าที่ตั้งใจโดยตรงอาจช่วยลดการอ้อม และทำให้คนดูแลรู้ว่าเนื้อหาอ้างถึงอะไรจริง
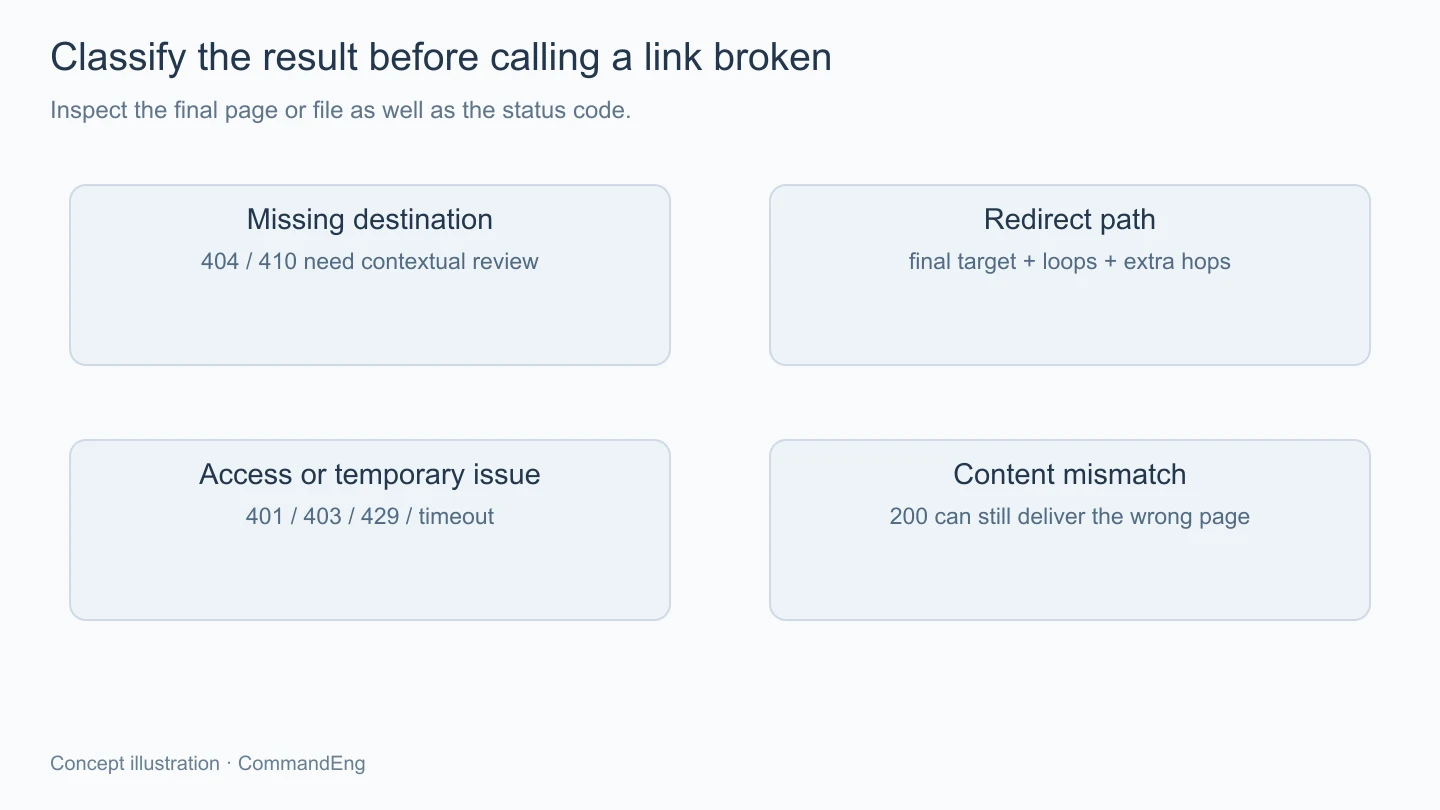
401 หรือ 403 ต้องดูเรื่องสิทธิ์กับระบบป้องกันการเข้าถึง ส่วน 429 และ timeout อาจเกิดจากเครื่องมือตรวจส่งถี่เกินไปหรือปลายทางติดขัด จึงควรพักและตรวจซ้ำตามเงื่อนไข ไม่รายงานว่าเนื้อหาหายถาวรจากผลครั้งเดียว
ในทางกลับกัน 200 ก็ยังอาจเป็นหน้าแจ้งว่าไม่พบเนื้อหา หรือหน้าเข้าสู่ระบบที่ระบบตอบแบบปกติ การตรวจเนื้อหาสำคัญของหน้ากับชนิดไฟล์จึงช่วยแยกผลที่สถานะอย่างเดียวมองไม่เห็น โดยเฉพาะภาพที่ควรได้รับข้อมูลภาพจริง ไม่ใช่ HTML ของหน้า error
หากทำ crawler ภายใน ควรกำหนด host กับ path ที่อนุญาต จำนวนหน้าสูงสุด และจำนวนคำขอพร้อมกันก่อน ไม่เปิดให้ตามทุกลิงก์ออกไปทั่วอินเทอร์เน็ต เพราะนอกจากจำนวนงานบานแล้ว ยังไปสร้างคำขอกับบริการที่ไม่เกี่ยวข้องกับการตรวจเว็บของเราได้
ควรหลีกเลี่ยงลิงก์ที่ทำให้เกิดการเปลี่ยนข้อมูล เช่น ทางออกจากระบบหรือคำสั่งที่ออกแบบไม่เหมาะกับ GET และไม่ใส่ credential ของผู้ดูแลให้ crawler ตามลิงก์ทั่วไปโดยไม่กำหนดขอบเขต การตรวจลิงก์สาธารณะควรเริ่มจากทางสาธารณะตามที่คนอ่านใช้จริง
ถ้าใช้ HEAD เพื่อประหยัดข้อมูล ต้องรู้ว่าบางปลายทางอาจจัดการต่างจาก GET จึงไม่ควรตัดสินลิงก์เสียจาก HEAD ที่ไม่รองรับอย่างเดียว อาจมีขั้นยืนยันด้วย GET แบบควบคุมปริมาณ แล้วเก็บว่าวิธีใดให้ผลที่นำมารายงาน
การทดสอบกับหน้าเล็กๆ ที่รู้รายการลิงก์ก่อนช่วยตรวจเครื่องมือได้ เช่น มีลิงก์ถูก ลิงก์หาย redirect และ fragment ที่ไม่มี จากนั้นดูว่าผลแยกชนิดได้ตามที่ตั้งใจ จึงค่อยขยายไปชุดใหญ่ ไม่เริ่มจากสแกนเว็บทั้งหมดโดยยังไม่รู้ว่ารายงานตีความสถานะแบบใด
เมื่อพบปัญหา ควรจัดลำดับจากลิงก์ที่คนเจอได้ง่ายและปลายทางสำคัญก่อน เช่น เมนูหลัก หน้าที่มีหลายบทอ้างถึง หรือภาพที่ใช้เป็นปกหลายจุด แล้วเลือกว่าจะเปลี่ยน href คืนไฟล์ หรือทำ redirect ตามความหมายของเนื้อหา
อย่า redirect ทุกหน้าที่หายไปหน้าแรกเพียงเพื่อให้เครื่องมือตรวจเห็น 200 เพราะคนที่กดลิงก์ยังไม่ได้ข้อมูลที่ข้อความลิงก์สัญญาไว้ หากไม่มีเนื้อหาทดแทนที่ตรง ก็ควรแก้ต้นทางหรือแสดงสถานะที่ซื่อตรงตามกรณี
หลังแก้ให้กลับไปตรวจจาก URL ต้นทางเดิม และดูว่าฉบับสาธารณะเปลี่ยนแล้วด้วย เพราะการแก้ฐานเนื้อหาอาจยังค้างอยู่ใน cache รายงานจึงควรมีเวลาตรวจและผลรอบล่าสุดไว้ ส่วนบทนี้เป็นแนวทางจัดการหลักฐาน ยังไม่มีจำนวนลิงก์เสียของ CommandEng ที่นำมาอ้างเป็นผลสแกนจริง
การตรวจลิงก์ให้ตามแก้ได้ครบต้องรู้ทั้งจุดที่อ้าง URL และผลของหน้าหรือไฟล์ปลายทาง เมื่อ resolve ลิงก์ถูก แยก status กับสาเหตุ และจำกัดขอบเขตการตรวจไว้ชัด เราจะกลับไปแก้จากจุดที่คนอ่านพบปัญหาได้ตรงขึ้น แล้วตรวจซ้ำให้แน่ใจว่าทางเดินเดิมใช้งานได้ตามความหมายของลิงก์นั้นจริง