Readiness กับ Liveness ควรตรวจเหมือนกันไหม
เวลาเอาแอปขึ้น Kubernetes เรามักเริ่มจากดูว่า Pod รันแล้วหรือยัง หาก process ยังอยู่และพอร์ตเปิด ก็ดูเหมือนพร้อมรับงาน แต่แอปอาจยังโหลดค่าตั้งต้นอยู่ ติดต่อส่วนที่จำเป็นไม่ได้ หรือค้างอยู่ในสภาพที่ยังไม่ยอมจบ process ก็ได้
probe ช่วยให้ระบบมีข้อมูลตัดสินใจมากขึ้นครับ แต่ก่อนสร้าง endpoint เดียวตอบทุกการตรวจ ควรแยกก่อนว่าอยากให้ Kubernetes ทำอะไรเมื่อพบปัญหา เพราะการพักไม่รับงานกับการเริ่ม container ใหม่ให้ผลต่างกันมาก
readiness, liveness และ startup จึงควรถูกออกแบบจากหน้าที่ของแอปและการกู้ที่ต้องการ ไม่ใช่ใส่ path เดียวกันทุกช่องเพื่อให้ manifest ดูครบแล้วจบ
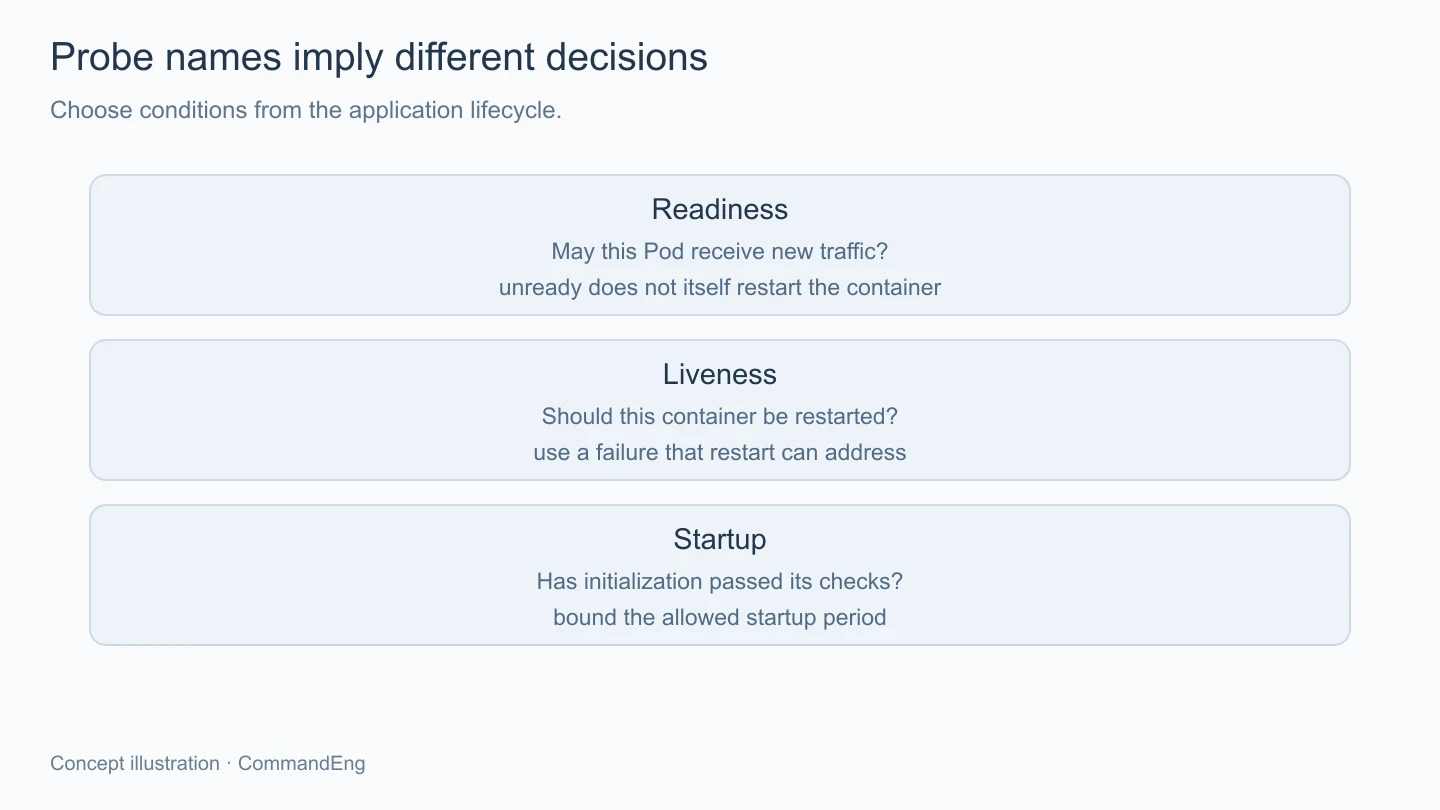
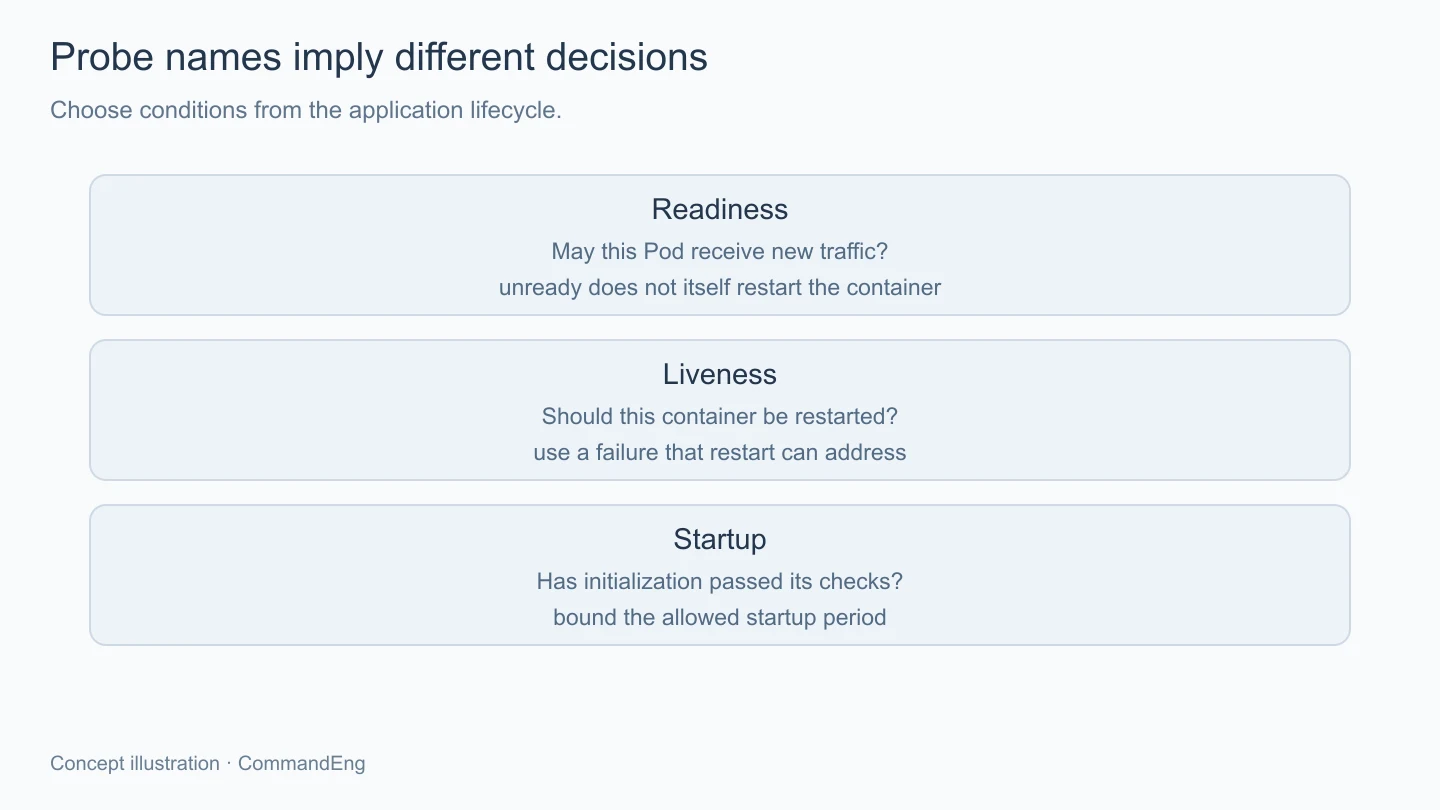
readiness ถามว่าควรส่งงานเข้ามาตอนนี้ไหม
readiness ใช้ประกอบความพร้อมรับ traffic ของ Pod ตามกลไกบริการที่เกี่ยวข้อง เมื่อไม่พร้อม ระบบไม่ได้แปลว่าต้องฆ่า container นั้นทันที แต่ต้องเปลี่ยนสถานะเพื่อไม่ให้ถูกเลือกส่งงานใหม่ตามเงื่อนไขของเส้นทางนั้น
ตัวอย่างอาจเป็นแอปที่ยังโหลดข้อมูลจำเป็นไม่ครบ หรืออยู่ระหว่างเตรียมหยุดรับงาน แต่เกณฑ์ต้องสัมพันธ์กับงานที่ให้บริการ หากมีความสามารถบางส่วนที่ยังทำได้ ก็ควรคิดว่าจะรายงานความพร้อมแบบใด ไม่ผูกทุกกรณีกับบริการภายนอกทั้งหมดโดยอัตโนมัติ
การเป็นไม่พร้อมยังไม่ได้รับรองว่าไม่มีคำขอค้างอยู่หรือไม่มีทางอื่นเรียกถึงแอป เพราะมีทั้ง connection เดิมและเวลาที่ส่วนเครือข่ายปรับสถานะ แอปจึงยังต้องจัดการงานระหว่างเปลี่ยนสถานะตาม lifecycle ของมัน ไม่ฝากทุกอย่างไว้กับผล probe เพียงอย่างเดียว
หาก Pod มีหลาย container หรือเงื่อนไขความพร้อมเพิ่มเติม ก็ควรดูสถานะรวมให้ตรง ไม่เห็น endpoint ของแอปตอบแล้วถือว่าทุกส่วนที่ Kubernetes ใช้ตัดสินพร้อมเหมือนกันทั้งหมด
liveness ถามว่าการเริ่มใหม่เป็นทางกู้ที่เหมาะหรือไม่
liveness ตรวจสภาพที่เมื่อไม่ผ่านตามเงื่อนไข ระบบจะเข้าสู่เส้นทางเริ่ม container ใหม่ตามการตั้งค่า การกำหนดเกณฑ์จึงควรมีเหตุผลว่าการเริ่มใหม่ช่วยแก้อาการนั้นได้ ไม่ใช้ตรวจทุกความผิดพลาดของทั้งระบบเพียงเพราะอยากให้กลับมาสีเขียว
ถ้าเอาการต่อฐานข้อมูลภายนอกไว้ใน liveness โดยไม่ดูผล เมื่อฐานข้อมูลมีปัญหา แอปหลายตัวก็อาจถูกเริ่มใหม่พร้อมกัน ทั้งที่การ restart แอปไม่ได้ทำให้ฐานข้อมูลกลับมา และยังเพิ่มงานเริ่มต้นหรือการเชื่อมต่อเข้าไปอีก
จึงควรแยกอาการที่ตัวแอปไม่สามารถเดินต่อได้จากการรอ dependency ที่อาจกลับมาเอง แล้วกำหนดเส้นทางรายงานกับการกู้ตามขอบเขต การตัด dependency ออกทุกแบบก็ไม่ใช่คำตอบเหมือนกัน ต้องดูว่าการไม่มีสิ่งนั้นทำให้ process อยู่ในสภาพใดจริง
endpoint ที่ตอบ 200 ตลอดโดยไม่ตรวจสิ่งที่ต้องเฝ้าก็ไม่ได้ให้หลักฐานเพิ่ม แต่การตรวจหนักจนสร้างภาระใหม่ก็อาจทำให้ probe เป็นตัวกระตุ้นปัญหาเอง จึงควรทำให้เบา มีขอบเขต และเชื่อมกับความหมายที่ต้องการ
startup ให้ช่วงเริ่มต้นมีเงื่อนไขของมัน
แอปที่ใช้เวลาตั้งต้นนานอาจยังไม่พร้อมตามเกณฑ์ liveness ทันทีหลังเปิด หากเราขยายความอดทนของ liveness มากเพื่อให้เริ่มผ่าน ก็อาจทำให้การตรวจค้างหลังเริ่มเสร็จช้าไปตามนั้นด้วย
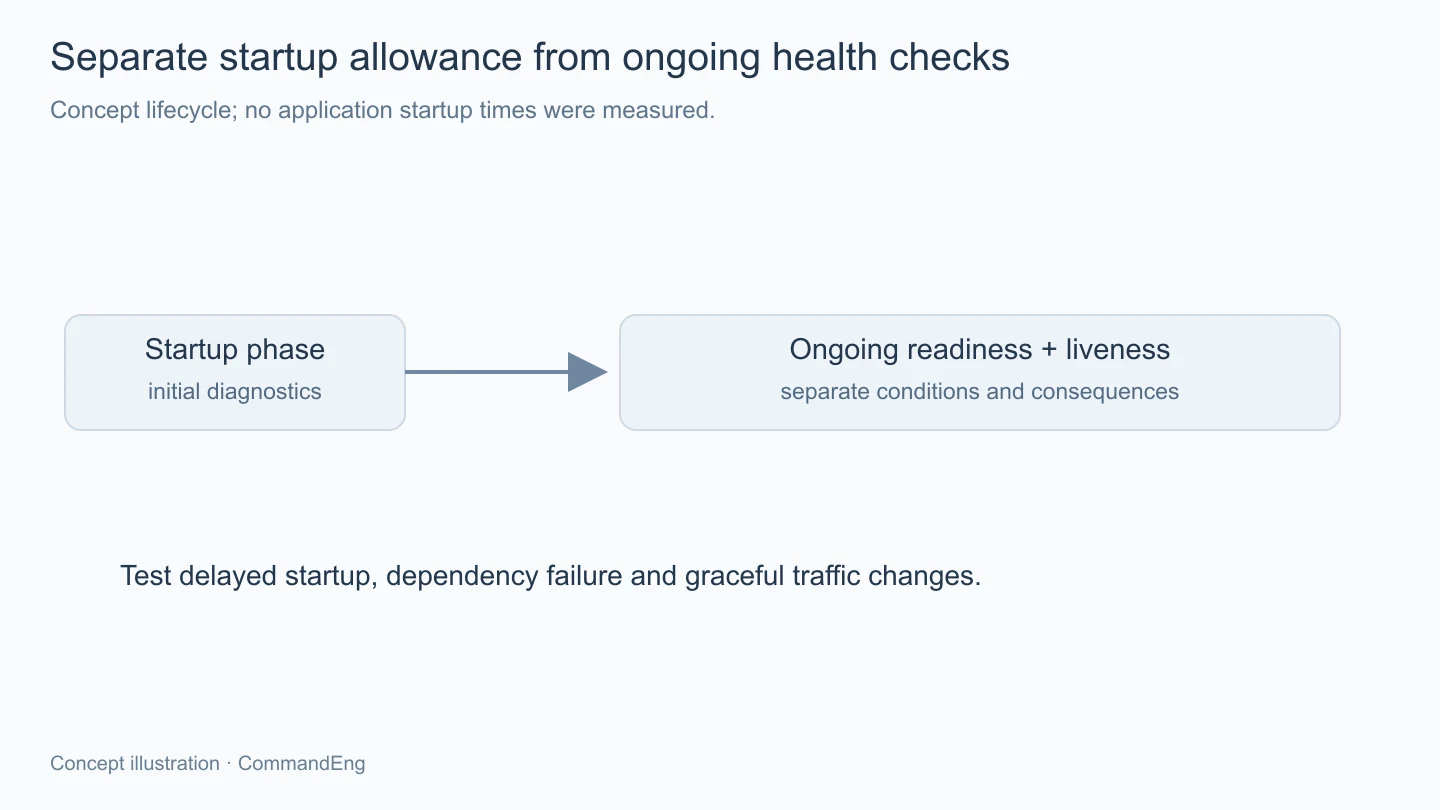
startup probe ช่วยแยกการให้เวลาช่วงเริ่มตามกลไกที่ Kubernetes รองรับ เมื่อผ่านแล้วจึงไปสู่การตรวจอื่นตามการตั้งค่า แต่ถ้าไม่ผ่านภายในขอบเขตที่กำหนดก็ยังมีผลต่อการเริ่ม container ใหม่ ไม่ใช่การรอได้ตลอดไปโดยไม่มีข้อสรุป
ขอบเขตเวลาควรมาจากผลเริ่มแอปในสภาพที่ใกล้การใช้งาน ทั้งกรณี cache ว่างและ dependency พร้อมตามที่ออกแบบ ไม่ใช้เวลาบนเครื่องพัฒนาที่มีทุกอย่างเตรียมแล้วเป็นตัวแทนทุก Pod ใหม่
ถ้าระยะเริ่มแปรปรวนมาก ควรแยกขั้นที่ใช้เวลาจริงด้วย บางครั้งการย้ายงานบางอย่างไปเตรียมก่อนหรือจัดการ dependency ชัดขึ้นอาจช่วยได้ตรงกว่าเพิ่มเวลารอของ probe ไปเรื่อยๆ
timeout กับรอบตรวจมีผลกับพฤติกรรมทั้งระบบ
ค่า timeout, period และ threshold ต้องอ่านร่วมกันว่าใช้เวลาประมาณใดก่อนตัดสินตามผลต่อเนื่อง ไม่คัดค่าเดียวจากตัวอย่างแล้วคิดว่าทุกแอปจะถูกตรวจด้วยจังหวะเหมือนกันทั้งหมด โดยรายละเอียดต้องดูตามเวอร์ชันที่คลัสเตอร์ใช้
ถ้าแอปถูกจำกัด CPU จนตอบช้าหรือเครื่องมีภาระสูง ผล probe ก็อาจได้รับผลด้วย จึงควรดูเหตุการณ์ restart กับการใช้ทรัพยากรในช่วงเดียวกัน ไม่สรุปว่าพบ deadlock ทุกครั้งที่ endpoint หมดเวลา
ในทางกลับกัน การผ่อนทุกค่าเพื่อให้ไม่มี restart อาจทำให้ระบบไม่ตรวจสภาพค้างที่ตั้งใจจะกู้ ต้องเลือกความไวที่สัมพันธ์กับงานและตรวจทั้งโอกาสพลาดกับผลของการเริ่มใหม่ ไม่ให้จำนวน restart ที่ลดลงเป็นตัวชี้ว่าคุณภาพดีขึ้นเพียงอย่างเดียว
ทดลองผลที่คาดให้เกิดกับแต่ละ probe
เริ่มจากกำหนดสถานการณ์ที่ปลอดภัยในชุดทดสอบ เช่น แอปยังเริ่มไม่เสร็จ งานที่จำเป็นยังไม่พร้อม หรือส่วนทำงานจำลองไม่คืบหน้า แล้วดูว่า readiness เปลี่ยน การส่ง traffic ปรับ และ liveness เริ่มใหม่ตรงตามที่วางไว้หรือไม่
ควรเก็บเหตุการณ์ของ Pod กับ log แอปไว้พร้อมรุ่น manifest จะได้เห็นว่าใครเป็นคนเริ่มการเปลี่ยนสถานะ ไม่เดาจากชื่อสถานะสุดท้ายอย่างเดียว และหลังเริ่มใหม่ต้องตรวจว่างานหลักกับเส้นทางจัดการกลับมาจริงด้วย
การทดสอบช่วง rolling update ก็ควรรวมผลของ readiness กับการหยุดงานเก่า เพราะเป็นจังหวะที่มีทั้งการเริ่มและการส่งงานใหม่พร้อมกัน หาก probe ผ่านแต่คำขอจริงยังล้ม เราก็ต้องปรับความหมายหรือ lifecycle ต่อ ไม่ใช้ผล probe มาหักล้างประสบการณ์ที่ตรวจได้
เนื้อหาที่ endpoint ตรวจสุขภาพส่งกลับควรมีเท่าที่จำเป็น ไม่รวมค่าลับหรือรายละเอียดการเชื่อมต่อเพื่อให้ probe อ่านง่ายขึ้น หากต้องมีข้อมูลวินิจฉัยที่มากกว่า ควรแยกทางเข้ากับสิทธิ์ให้เหมาะ ไม่ใช้ปลายทางเดียวเปิดเผยข้อมูลทุกอย่างกับทุกคนที่เรียกถึงได้
สรุป
readiness ใช้ตัดสินความพร้อมรับงาน liveness เกี่ยวกับการกู้ด้วยการเริ่มใหม่ และ startup ดูแลขอบเขตช่วงเริ่ม เมื่อแยกหน้าที่และทดสอบผลของแต่ละแบบตามแอปจริง เราจะให้ Kubernetes ตอบสนองกับปัญหาได้ตรงขึ้น โดยไม่ใช้ endpoint สีเขียวเดียวแทนสุขภาพทุกมุมของระบบครับ

