กราฟบอกว่ามี error แต่จะรู้สาเหตุจากตรงไหน
กราฟที่แสดงจำนวน error เพิ่มขึ้นช่วยบอกได้ว่าควรเริ่มดูช่วงไหน แต่พออยากรู้ว่าคำขอใดมีปัญหาและไปติดที่ส่วนใด ตัวเลขรวมก็อาจให้รายละเอียดต่อไม่ได้มากกว่านั้น
ถ้าแต่ละบริการเก็บ log อยู่ในเครื่องของตัวเอง เราก็ต้องตามไปเปิดหลายที่ แล้วค่อยเทียบชื่อกับเวลาอีกครั้ง งานนี้เริ่มยุ่งขึ้นเมื่อ container ถูกสร้างใหม่หรือคำขอหนึ่งเดินผ่านหลายบริการก่อนกลับไปหาผู้ใช้
metric กับ log จึงช่วยคนละด้านของคำถามครับ ลองวางสิ่งที่ต้องเก็บให้เชื่อมกันได้ก่อน แล้วค่อยใช้ Loki เป็นจุดรวมรายละเอียด เพื่อให้จากอาการบนกราฟตามลงไปถึงหลักฐานที่เกี่ยวข้องได้โดยไม่ค้นทั้งระบบแบบไม่มีขอบเขต
ให้ข้อมูลรวมพาไปถึงช่วงที่ต้องอ่านรายละเอียด
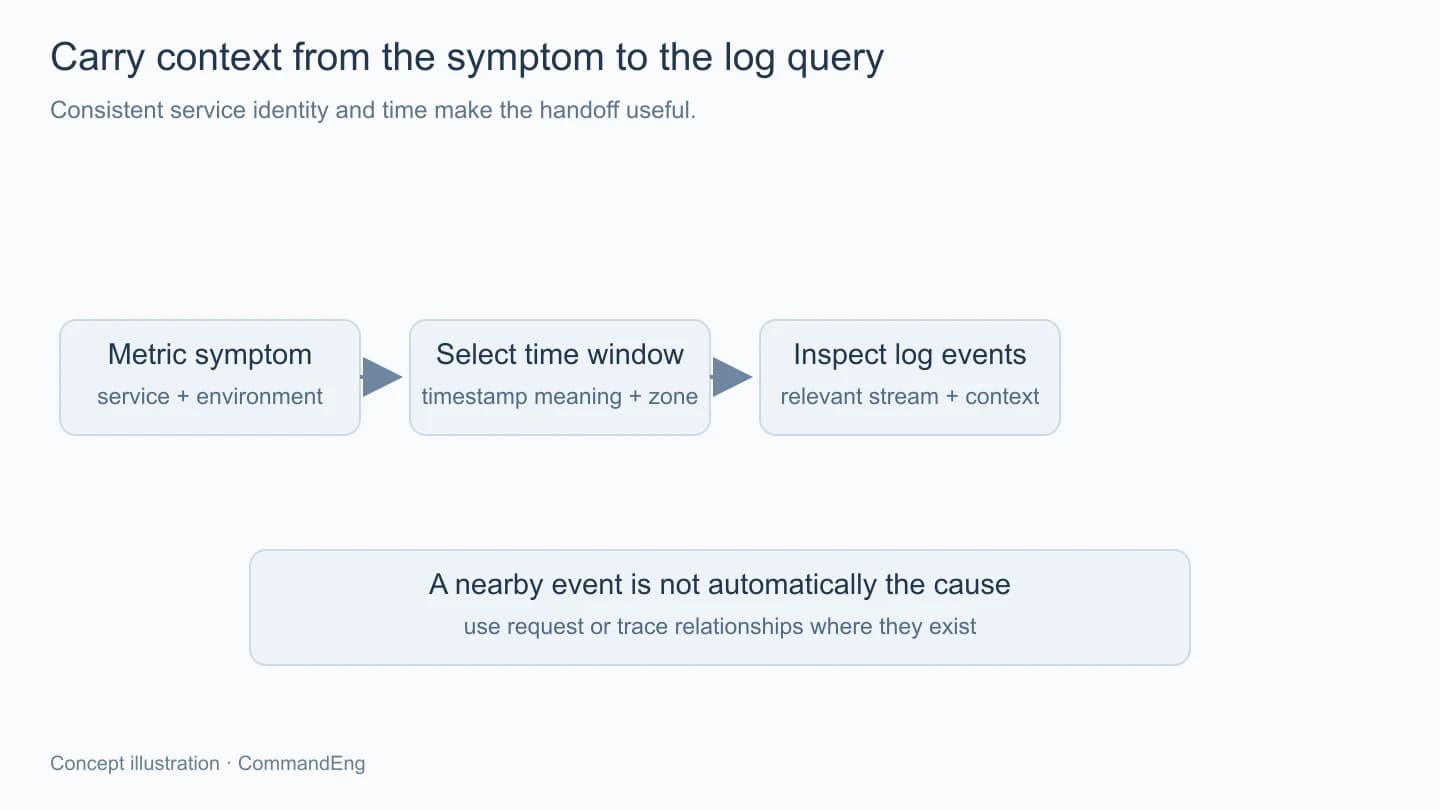
metric เหมาะกับการติดตามค่ารวมและแนวโน้ม ส่วน log มีรายละเอียดเหตุการณ์ตามที่แอปบันทึกไว้ ถ้ากราฟบอกว่า service หนึ่งเริ่มผิดปกติ เราควรพาชื่อ environment, service และช่วงเวลานั้นตามไปตอนเปิด log ด้วย
การใช้ชื่อเดียวกันในสองระบบช่วยให้จับคู่ได้ แต่ต้องตรวจว่ามันหมายถึงสิ่งเดียวกันจริง เช่น ชื่อ service ที่ exporter ตั้งกับชื่อแอปใน log อาจไม่ตรงโดยอัตโนมัติ จึงควรกำหนดข้อตกลงให้ชัดแทนการให้คนเปิด Dashboard จำคำแปลของแต่ละตัวเอง
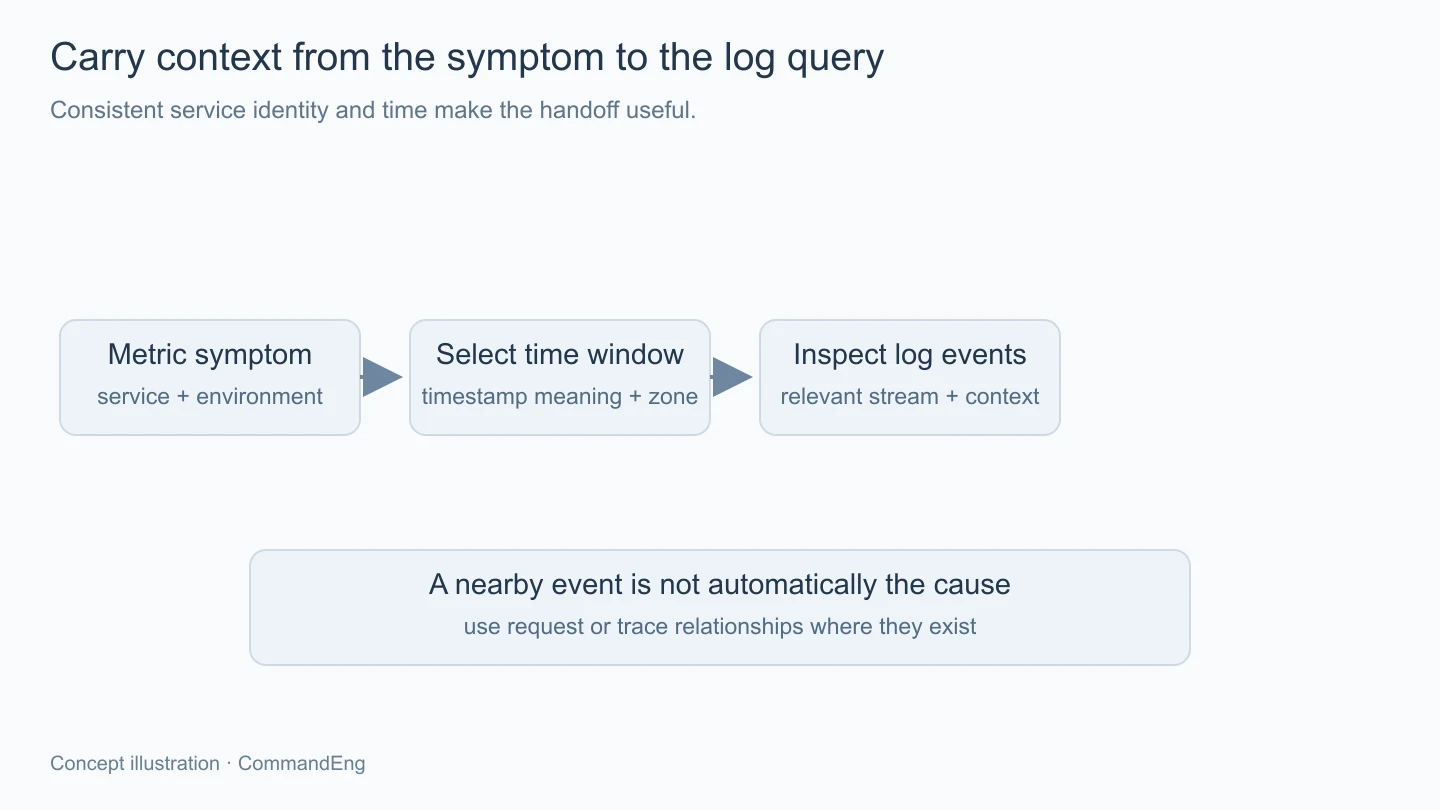
เวลาเป็นอีกส่วนสำคัญ ทั้งเขตเวลา เวลาที่แอปสร้างเหตุการณ์ และเวลาที่ collector รับเข้าระบบอาจต่างกัน หากแปลเวลาไม่ตรง เราก็อาจค้นช่วงที่กราฟชี้แต่ไม่เห็น log แล้วรีบสรุปว่าไม่มีเหตุเกิดขึ้น
ควรมีขอบเขตเผื่อการส่งล่าช้าตามที่ระบบพบจริง และรู้ว่า field เวลาที่ใช้ค้นคืออะไร ไม่เติมเวลารับใหม่ให้เหตุการณ์เก่าโดยไม่แยกความหมาย เพราะจะทำให้การตามลำดับเหตุการณ์ข้ามบริการยิ่งยากขึ้น
Loki เลือก stream จาก labels ก่อนอ่านรายละเอียด
Loki ใช้ labels ช่วยจัดกลุ่มและค้นหา log stream โดยไม่ได้ทำดัชนีเนื้อหาทุกคำแบบเดียวกับระบบค้นข้อความบางชนิด การเลือก labels จึงมีผลกับวิธีจำกัดข้อมูลที่จะอ่านตอน query
ข้อมูลอย่าง service กับ environment ที่มีขอบเขตชัดอาจช่วยเริ่มค้นได้ตรง ส่วนรหัสคำขอหรือข้อมูลที่เปลี่ยนเกือบทุกรายการควรถูกพิจารณาเป็นรายละเอียดในข้อความหรือโครงสร้าง metadata ตามการรองรับของรุ่น แทนการใช้เป็น label หลักทุกครั้งโดยไม่ดู cardinality
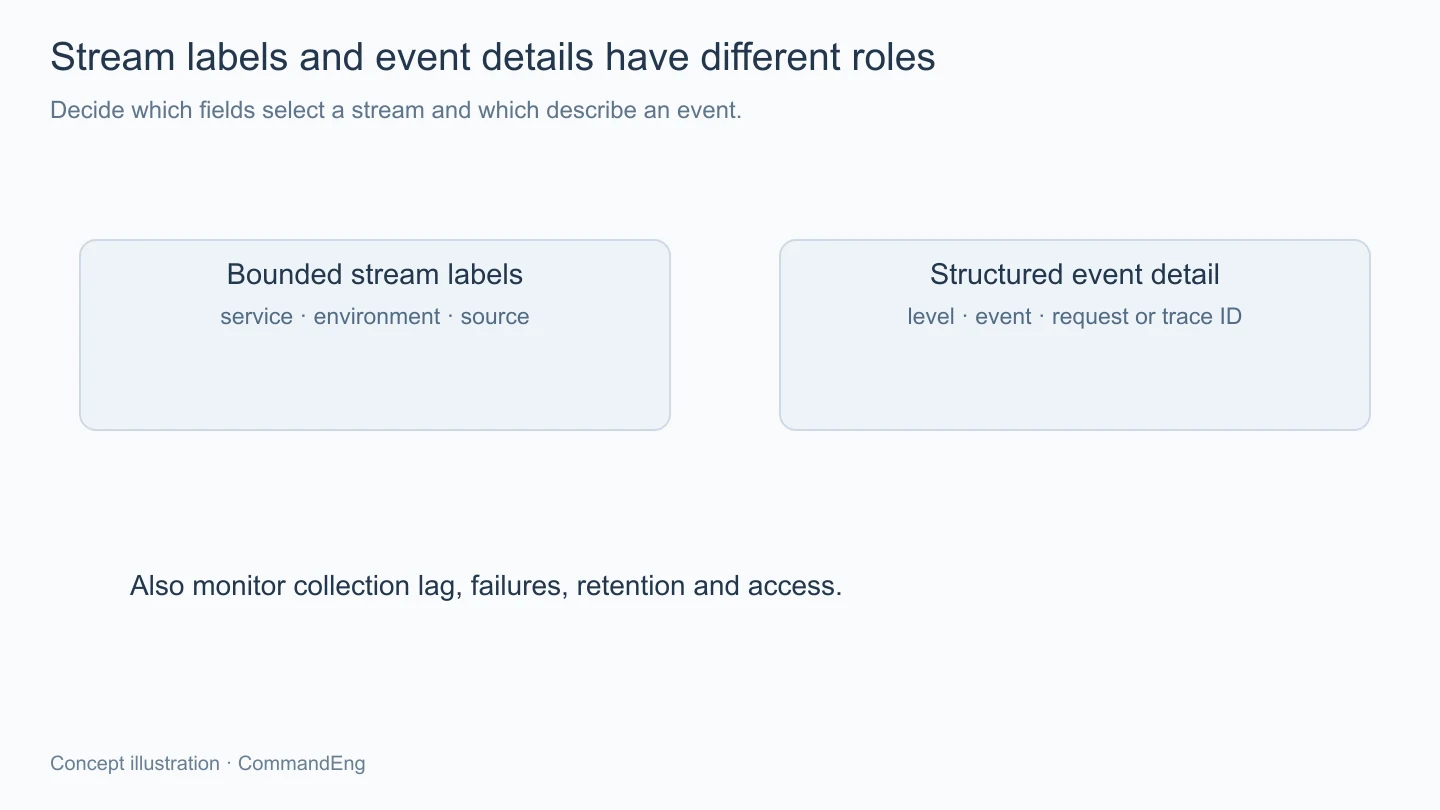
การมีรายละเอียดใน log ไม่ได้หมายความว่าต้องทำทุก field เป็น label และการย้ายออกจาก label ก็ยังต้องมีรูปแบบที่ query อ่านได้สะดวก ควรเลือกจากคำถามที่ใช้จริง ไม่เก็บข้อมูลเป็นข้อความยาวที่แต่ละบริการสะกดชื่อ field ไม่เหมือนกันทั้งหมด
การตั้งค่าฝั่ง collector ต้องดูด้วยว่ามันเติม labels จากแหล่งใด หากชื่อ path มีรหัสที่เปลี่ยนตลอดแล้วถูกนำขึ้นมาเป็น label โดยไม่ตั้งใจ ระบบก็อาจมีจำนวน stream สูงขึ้นแม้แอปส่งข้อความรูปแบบเดิมอยู่
เขียน log ให้รู้ว่าเกิดอะไร โดยไม่เก็บเกินหน้าที่
โครงสร้างที่มีชื่อ field คงที่ช่วยลดการแยกข้อความด้วยสายตา เช่น แยกระดับเหตุการณ์ ชื่อบริการ รหัสคำขอ และชนิดเหตุ แต่ข้อมูลควรมาจากสิ่งที่แอปรู้จริง ไม่สร้างคำอธิบายสาเหตุแน่นอนในจุดที่รู้เพียงว่าปลายทางไม่ตอบทันเวลา
ตัวอย่างรูปแบบสมมติอาจมี level, service, environment, request_id และ event เพื่อให้ตามเหตุการณ์ได้ โดยไม่ต้องพิมพ์ payload ของผู้ใช้หรือข้อมูลลับทั้งหมดลงไป การเลือก field ควรมีเหตุผลว่าช่วยตรวจอะไรและใครควรอ่านได้
ข้อมูลที่ใช้ยืนยันตัวตนอย่าง token หรือรหัสผ่านไม่ควรติดไปกับข้อความเพียงเพราะกำลังเปิด debug ส่วนข้อมูลส่วนบุคคลที่งานจำเป็นต้องเก็บก็ต้องมีขอบเขตสิทธิ์กับ retention ที่สอดคล้องกัน ไม่ให้ระบบ log กลายเป็นสำเนาข้อมูลที่กว้างกว่าแอปหลักโดยไม่ได้ตั้งใจ
ระดับ log ก็ควรมีความหมายร่วมกัน หากเหตุการณ์ปกติถูกเขียนเป็น error ตลอด กราฟที่สรุปจาก log จะดูมีปัญหาตลอดเหมือนกัน และถ้าทุกข้อผิดพลาดถูกลดเป็น debug เพื่อให้หน้าสงบ เราก็จะขาดข้อมูลในวันที่ต้องใช้จริง
รหัสอ้างอิงช่วยตามเส้นทาง แต่ไม่ได้อธิบายสาเหตุเอง
เมื่อมี request ID หรือ trace ID ที่ส่งต่ออย่างถูกต้อง เราสามารถใช้ตามรายการที่เกี่ยวข้องข้ามบริการได้ แต่ต้องรู้ว่าต้นทางสร้างและส่งต่ออย่างไร ไม่ให้แต่ละ service สร้างรหัสใหม่โดยไม่มีความสัมพันธ์จนดูเหมือนคนละงานทั้งหมด
ถ้าคำขอถูกลองซ้ำหรือมีงานเบื้องหลัง ควรแยกความหมายของรหัสงานกับรหัสความพยายามตามการออกแบบ มิฉะนั้นอาจเอา log ของหลายรอบมารวมแล้วอ่านว่ารอบเดียวทำขั้นตอนซ้ำโดยไม่มีเหตุ
การพบเหตุการณ์อยู่เวลาใกล้กันยังไม่ยืนยันว่าเป็นสาเหตุเดียวกัน ควรดูความสัมพันธ์ของรหัส สถานะตอบกลับ และข้อมูลที่เกี่ยวข้องก่อนสรุป ไม่ใช้เพียงกราฟพุ่งกับข้อความที่ดูผิดปกติในช่วงนั้นมาจับเป็นคำตอบทันที
เส้นทางเก็บ log เองก็ต้องถูกตรวจ
จากแอปไป collector แล้วถึง Loki ยังมีช่วงที่ข้อมูลอาจค้าง ถูกจำกัด หรือไม่ถูกส่งตามการตั้งค่า จึงควรดูสถานะการเก็บกับความล่าช้าด้วย การไม่มี log ในผลค้นไม่ควรถูกแปลว่าแอปไม่เคยเกิดเหตุเสมอไป
ถ้ามีการหมุนไฟล์หรือสร้าง container ใหม่ ต้องตรวจว่าตัวเก็บตามไฟล์และตำแหน่งอ่านอย่างไร รวมถึงมีขอบเขต buffer และพื้นที่รองรับเมื่อปลายทางไม่พร้อมหรือไม่ เพราะความพร้อมของแอปกับความพร้อมของระบบเก็บหลักฐานอาจแยกจากกันได้
retention ของ log ควรสัมพันธ์กับระยะที่ทีมต้องใช้ไล่เหตุและสิทธิ์ข้อมูลที่เก็บ ไม่เปิดเก็บทุกอย่างไม่จำกัดเพียงเพราะยังมีพื้นที่ในวันแรก และถ้าทำให้ query กว้างมากก็ควรประเมินภาระจากข้อมูลจริง ไม่อาศัยความรู้สึกว่ามีแค่ไฟล์ข้อความจึงเบาเสมอ
สรุป
metric ช่วยบอกอาการและช่วงเวลา ส่วน log ช่วยลงรายละเอียดเมื่อมีชื่อ เวลา และรหัสที่เชื่อมกันได้ การใช้ Loki ควรเริ่มจาก labels ที่มีขอบเขต รูปแบบ log ที่อ่านต่อได้ และเส้นทางเก็บที่ตรวจสอบได้ เมื่อจัดสามส่วนนี้ร่วมกัน เราจะตามจากกราฟไปหาหลักฐานได้ตรงขึ้น โดยไม่ต้องเก็บทุกอย่างเป็น label หรือค้นทั้งระบบทุกครั้งครับ

