


ตอนลองต่อ workflow งานมักเริ่มจากข้อมูลตัวอย่างหนึ่งชุด แล้วดูว่าข้อมูลเดินไปถึงปลายทางหรือยัง อย่างรับแบบฟอร์มเข้ามา ดึงข้อมูลเพิ่มเติมจาก API แล้วสร้างรายการให้คนทำงานต่อ ถ้าทุกขั้นขึ้นสถานะสำเร็จและเห็นรายการใหม่ ก็พอรู้ว่าเส้นทางหลักเชื่อมกันได้แล้ว
แต่เมื่อเปิดให้รับงานจริง ข้อมูลที่เข้ามาจะไม่ได้เหมือนตัวอย่างเสมอไป และบริการที่เรียกใช้อยู่ก็อาจตอบช้า หยุดให้บริการ หรือเปลี่ยนเงื่อนไขบางอย่างได้ด้วย งานจึงมีโอกาสหยุดอยู่ระหว่างทาง ทั้งที่ก่อนหน้านั้นสร้างข้อมูลบางส่วนไปแล้ว
สิ่งที่ต้องออกแบบเพิ่มจึงเป็นวิธีตามให้รู้ว่างานไหนหยุดอยู่ตรงไหน และสิ่งที่ทำไปก่อนหยุดนั้นมีอะไรบ้างครับ ถ้ามองเรื่องนี้ตั้งแต่ workflow ยังเล็ก การกลับมาจัดการงานค้างจะง่ายกว่ารอให้มีหลายเส้นทางแล้วค่อยไล่แกะจากผลปลายทาง
ลองใช้ตัวอย่างสมมติว่า workflow รับคำขอบริการ ตรวจข้อมูล แล้วสร้างใบงานในระบบหลังบ้าน หากขั้นส่งข้อความแจ้งเจ้าหน้าที่ไม่สำเร็จ ใบงานอาจถูกสร้างเรียบร้อยแล้ว แต่เจ้าหน้าที่กลับไม่รู้ว่ามีงานใหม่เข้ามา ถ้ามองแค่ execution ที่ขึ้น failed ก็ยังตอบไม่ได้ว่าต้องสร้างใบงานใหม่ด้วยหรือเปล่า
จึงควรแยกสถานะของคำขอบริการออกจากสถานะการรันแต่ละครั้ง คำขอหนึ่งรายการมีรหัสงานของตัวเอง ส่วน execution ID ใช้บอกว่ากำลังตรวจรอบไหนของ workflow งานเดียวกันอาจมีหลาย execution เพราะมีการลองใหม่ ซึ่งความสัมพันธ์นี้ควรตามย้อนกลับมาได้
จากนั้นค่อยกำหนดจุดที่ถือว่ายืนยันผลแล้ว เช่น ตรวจข้อมูลผ่าน สร้างใบงานสำเร็จพร้อมรหัสจากปลายทาง และแจ้งเจ้าหน้าที่สำเร็จ การเก็บจุดยืนยันเหล่านี้ช่วยให้เห็นความต่างระหว่างงานที่ยังไม่เริ่ม งานที่ทำไปบางส่วน และงานที่จบครบตามที่ผู้ใช้ต้องการ
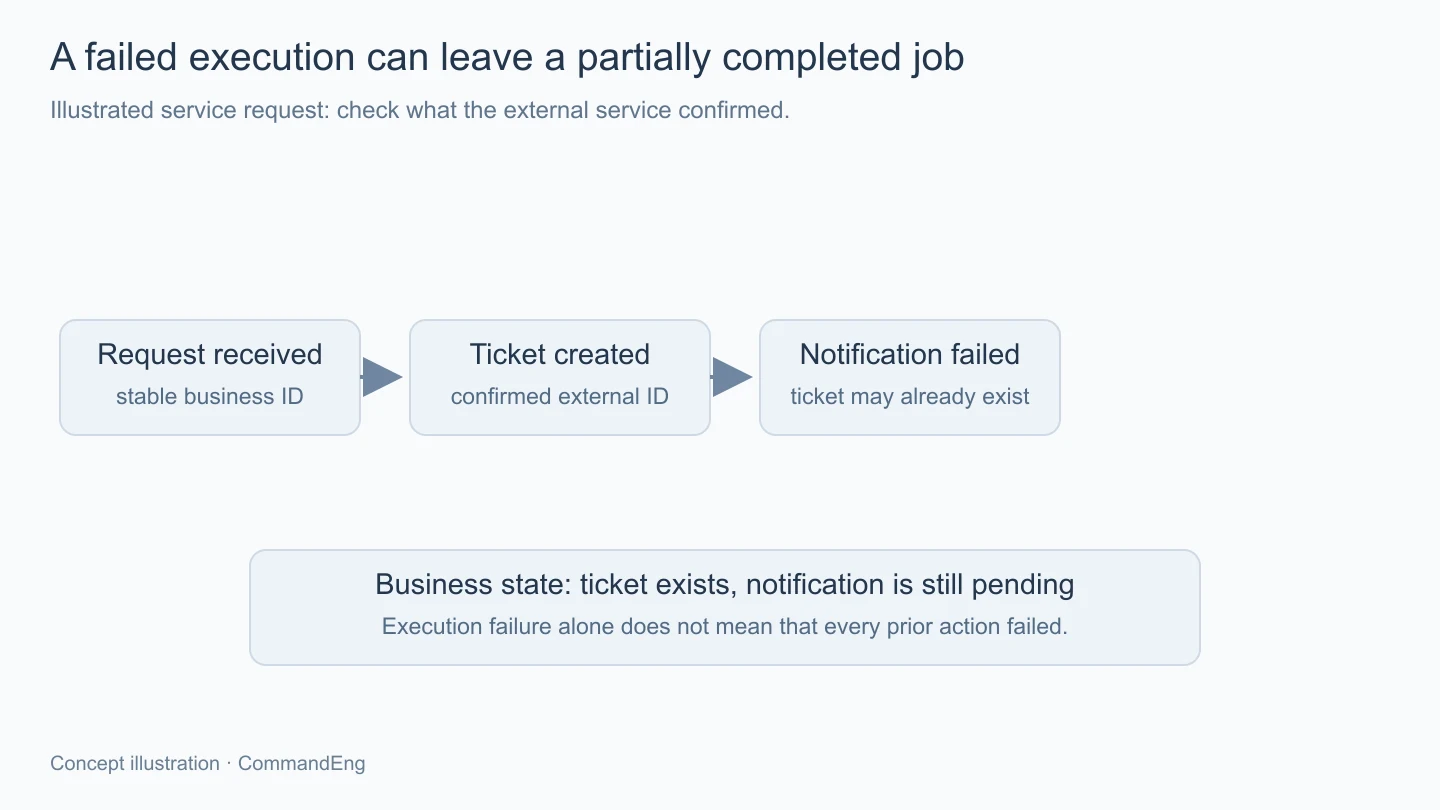
การบันทึกว่าเรียก API ไปแล้วอย่างเดียวอาจยังไม่ใช่หลักฐานว่าปลายทางทำเสร็จ ต้องดูด้วยว่าได้รับผลตอบรับแบบไหน ถ้าการเชื่อมต่อขาดก่อนรับคำตอบ สถานะที่ซื่อตรงกว่าคือยังยืนยันผลไม่ได้ แล้วค่อยมีขั้นตรวจสอบต่อ แทนการตีความทันทีว่าปลายทางไม่ได้รับอะไรเลย
ใน n8n สามารถกำหนด error workflow ให้ workflow หลักใช้เมื่อ execution ล้มเหลวได้ โดยเส้นทางจัดการข้อผิดพลาดเริ่มด้วย Error Trigger และสามารถใช้เส้นทางเดียวรับข้อผิดพลาดจากหลาย workflow ได้ด้วย วิธีนี้ช่วยรวบการรายงานไว้ในที่ที่ดูแลร่วมกันได้
ข้อมูลที่ส่งมามีรายละเอียดเกี่ยวกับ workflow และข้อผิดพลาด รวมถึงข้อมูล execution บางส่วนตามกรณีที่เกิด จึงนำมาเชื่อมกับรหัสงานเพื่อชี้ไปยังรอบที่ต้องตรวจได้ แต่ไม่ควรสมมติว่าทุก field จะมีเสมอ โดยเฉพาะข้อผิดพลาดที่เกิดตั้งแต่ trigger เพราะยังอาจไม่มี execution ที่บันทึกไว้เหมือนการทำงานปกติ
อีกจุดที่ต้องแยกให้ชัดคือการกดรันด้วยมือกับการรันอัตโนมัติ เอกสาร Error Trigger ระบุว่าไม่ได้ใช้ทดสอบ error workflow จากการรันแบบ manual ดังนั้นเห็นเส้นทางหลักล้มเหลวตอนกดลองแล้วไม่มีการแจ้ง จึงยังสรุปไม่ได้ว่าเส้นทาง error ที่ตั้งไว้เสีย ต้องจัดการทดสอบให้ตรงรูปแบบการเรียกจริงด้วย
ส่วนกรณีที่ตั้ง node ให้จัดการ error แล้วทำงานต่อ ก็ต้องดูผลสุดท้ายของ workflow อีกที เพราะการพบข้อผิดพลาดใน node ไม่ได้แปลว่า execution ทั้งชุดจะจบแบบ failed เสมอไป ถ้างานจำเป็นต้องหยุดเมื่อเงื่อนไขทางธุรกิจไม่ผ่าน ควรกำหนดทางออกนั้นให้ชัด แทนการปล่อยค่าที่ขาดให้ไหลต่อจนดูเหมือนทำงานสำเร็จ
ข้อความว่า workflow พังช่วยบอกให้รู้ว่ามีเหตุการณ์เกิดขึ้น แต่คนที่รับเรื่องยังต้องรู้ว่ากระทบงานไหน ถ้ามีชื่อ workflow รหัสงาน ขั้นที่หยุด เวลาที่เกิด และจุดเปิดดู execution ก็จะเริ่มตรวจได้โดยไม่ต้องค้นจากข้อความ error หลายหน้าจอ
ในตัวอย่างใบงาน สิ่งที่มีประโยชน์มากคือรหัสใบงานที่สร้างสำเร็จแล้วกับสถานะการแจ้งเจ้าหน้าที่ ข้อมูลสองอย่างนี้ช่วยให้ผู้ดูแลเลือกทำเฉพาะขั้นที่ขาดได้ ส่วน payload เต็มที่มีข้อมูลลูกค้า รหัสผ่าน หรือ token ไม่จำเป็นต้องถูกส่งไปกับทุกการแจ้งเตือน เพียงเพราะมีอยู่ใน execution
ควรกำหนดด้วยว่าใครเปิดดูรายละเอียดได้ และข้อมูล execution จะถูกเก็บไว้นานแค่ไหน เพราะการตรวจปัญหาต้องอาศัยข้อมูลเพียงพอ ขณะที่การคัดลอกข้อมูลละเอียดไปไว้หลายที่ก็เพิ่มภาระดูแลตามมาได้ ทางที่เหมาะจึงเป็นการเก็บจุดอ้างอิงกับข้อมูลวินิจฉัยที่จำเป็น แล้วเปิดรายละเอียดผ่านช่องทางที่ควบคุมสิทธิ์ไว้
หากระบบปลายทางล่มจนหลายงานผิดพลาดพร้อมกัน การแจ้งทุก execution เป็นข้อความแยกอาจกลบเหตุการณ์อื่น จึงควรคิดเรื่องการรวมเหตุการณ์ตามบริการหรือชนิดปัญหาด้วย โดยยังเก็บรายชื่องานที่ได้รับผลกระทบไว้ให้ตามคืนได้ การลดจำนวนข้อความไม่ควรทำให้รายการงานค้างหายไปจากการตรวจ
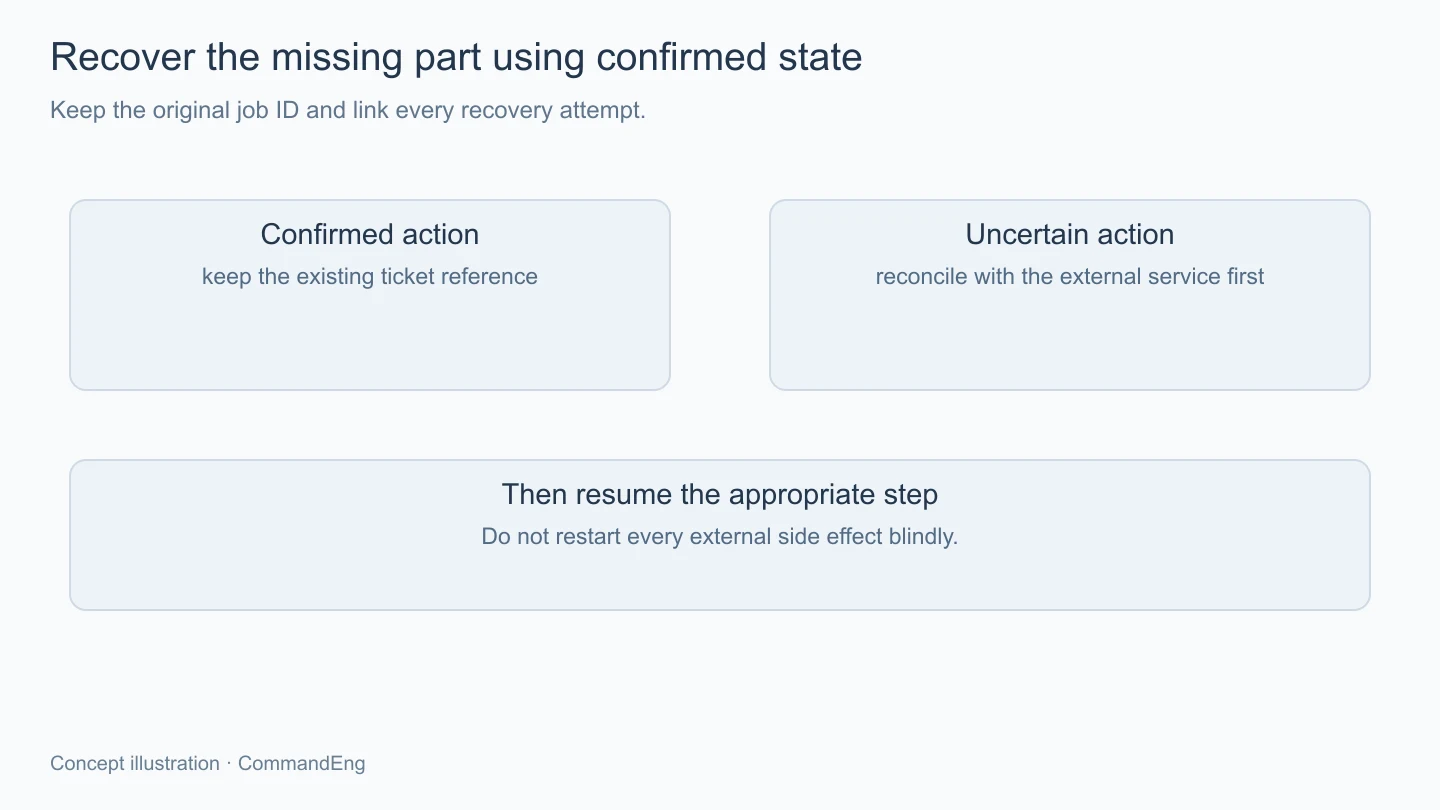
ก่อนสั่งรันซ้ำ ควรตรวจว่าขั้นที่กำลังจะทำมีผลต่อระบบภายนอกหรือไม่ การอ่านข้อมูลซ้ำกับการสร้างใบงานซ้ำมีผลต่างกัน ถ้าใบงานเดิมถูกสร้างไปแล้ว การเริ่มจากต้นโดยไม่ตรวจสถานะอาจสร้างรายการเพิ่ม ทั้งที่สิ่งที่ขาดมีเพียงการแจ้งให้คนรับรู้
วิธีจัดการจึงอาจเป็นการมีขั้นกู้คืนที่รับรหัสงาน ตรวจใบงานเดิม แล้วทำเฉพาะส่วนที่ยังไม่ครบ หรือให้ขั้นสร้างรายการรองรับรหัสอ้างอิงเดิมเพื่อป้องกันผลซ้ำ ทั้งสองแบบต้องออกแบบร่วมกับระบบปลายทาง และต้องตรวจด้วยว่ารองรับการตรวจซ้ำแบบใดจริง
ถ้ายังยืนยันไม่ได้ว่าปลายทางทำสำเร็จหรือยัง ก็ควรพักงานไว้ให้ตรวจสอบแทนการวนลองทันที การมีสถานะรอข้อมูลยืนยันช่วยรักษาความหมายของงานได้ดีกว่าบังคับให้ทุกเหตุการณ์ลงเอยเป็นสำเร็จหรือล้มเหลวในทันที โดยเฉพาะขั้นที่สร้างผลซึ่งย้อนกลับได้ยาก
เมื่อแก้แล้วก็ควรบันทึกว่าใช้วิธีใด ใครเป็นผู้ดำเนินการ และผูก execution รอบใหม่กับงานเดิมไว้ เพื่อให้คนที่มาดูภายหลังเข้าใจว่ารอบที่ล้มเหลวถูกจัดการไปอย่างไร ไม่ต้องเดาจากการที่เห็น execution ใหม่ขึ้นสีเขียว
การตรวจเส้นทาง error ควรใช้ข้อมูลทดสอบกับปลายทางที่แยกจากงานจริง แล้วเลือกจุดหยุดทีละขั้น เช่น ก่อนสร้างใบงาน หลังสร้างใบงาน และระหว่างรอคำตอบ API แต่ละจุดควรได้สถานะงานกับข้อมูลแจ้งที่ต่างกันตามสิ่งที่เกิดขึ้น ไม่ใช่แค่ตรวจว่ามีข้อความ error ออกมาสักอัน
อย่าลืมตรวจกรณีที่เส้นทางแจ้ง error เองทำงานไม่ได้ด้วย เช่น ช่องทางแจ้งเตือนมีปัญหา หรือข้อมูลที่ใช้จัดข้อความขาดบาง field จึงต้องมีจุดตรวจสุขภาพของงานค้างที่ไม่พึ่งช่องทางเดียวกันทั้งหมด แนวทางนี้เป็นแผนตรวจที่นำไปใช้ได้ ยังไม่ได้หมายความว่ามีผลทดสอบ workflow ของเว็บนี้แล้ว
Workflow ที่ดูแลต่อได้ต้องบอกทั้งสิ่งที่ทำสำเร็จแล้วและสิ่งที่ยังค้างอยู่ การใช้ error workflow ช่วยรวบเหตุการณ์ได้ แต่ต้องผูกกับสถานะของงานจริงและมีวิธีกู้คืนที่ไม่สร้างผลซ้ำ เมื่อออกแบบส่วนนี้ไปพร้อมเส้นทางปกติ เราก็จะตามงานจากหลักฐานที่มี แล้วเลือกจัดการเฉพาะส่วนที่ขาดได้ชัดเจนขึ้น