


พอ query ช้าแล้วเปิด EXPLAIN ขึ้นมา เราจะเห็นทั้งชื่อขั้นตอน ตัวเลข cost และจำนวนแถวที่ฐานข้อมูลคาดไว้ หลายอย่างดูเหมือนผลวัดจนชวนให้เลือกบรรทัดที่เลขสูงสุดแล้วเริ่มแก้ แต่ค่าบางส่วนยังเป็นเพียงการประเมินของ planner ไม่ใช่เวลาที่คำสั่งรันจริง
การอ่าน plan จึงควรเริ่มจากรู้ว่าข้อมูลชุดนี้ถูกสร้างด้วยคำสั่งแบบใด แล้วตามว่าข้อมูลเดินผ่านขั้นตอนไหนบ้าง หากข้ามความต่างระหว่าง estimate กับ actual เราอาจกำลังปรับจากตัวเลขที่ถูกอ่านผิดหน่วยหรือผิดขอบเขต
แอดมองว่าเป้าหมายแรกคือหาเหตุผลที่ตรวจต่อได้ครับ ว่างานส่วนใดอ่านแถวมากกว่าคาด ต้องเรียงข้อมูลส่วนไหน หรือทำซ้ำกี่รอบ แล้วค่อยวางการทดลองที่อธิบายผลได้ ไม่ใช้ภาพ plan เพียงภาพเดียวเป็นคำตอบว่าต้องเพิ่ม index ตัวใดทันที
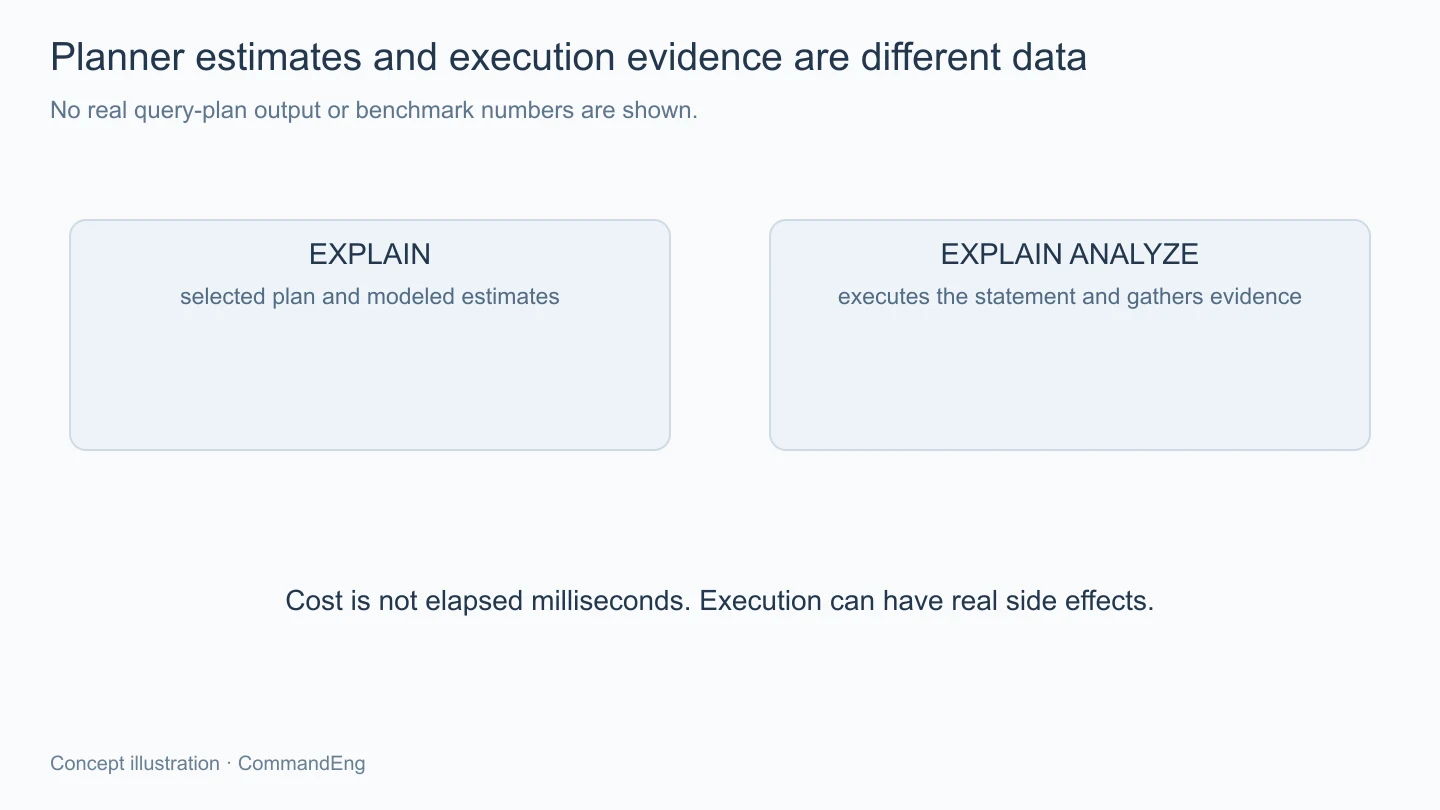
EXPLAIN ใช้แสดงแผนที่ planner เลือกกับค่าประมาณที่เกี่ยวข้อง ส่วนการใส่ ANALYZE จะเรียกคำสั่งจริงเพื่อเก็บข้อมูลการทำงาน และเพิ่ม overhead ของการตรวจตามตัวเลือกที่ใช้ จึงต้องเลือกวิธีให้ตรงสิ่งที่ต้องการรู้
ตัวอย่างด้านล่างใช้ตาราง sensor_events สมมติที่มี device_id กับ measured_at เพื่อแสดงรูปคำสั่งดู plan แบบ JSON ยังไม่มี output ที่วัดจากฐานข้อมูลจริงประกอบบทนี้
EXPLAIN (FORMAT JSON)
SELECT measured_at, value
FROM sensor_events
WHERE device_id = 'device-example'
ORDER BY measured_at DESC
LIMIT 100;
เมื่อจะใช้ ANALYZE ต้องรู้ว่าคำสั่งข้างในทำอะไร เพราะ INSERT, UPDATE หรือการเรียกที่มี side effect ยังสร้างผลตามปกติ ไม่ใช่เครื่องมือดูข้อมูลแบบไม่ลงมือเสมอไป ควรเริ่มจากชุดทดลองที่แยกและมีขอบเขตผลกระทบเหมาะสม
แม้เป็น query อ่าน ก็ยังใช้ทรัพยากรจริง และอาจอ่านข้อมูลที่ไม่ควรถูกย้ายไปไว้ในรายงาน การเลือกคำสั่งกับ parameter จึงควรดูทั้งภาระและขอบเขตข้อมูล ไม่คัดลอกคำสั่งจาก log ที่มีข้อมูลส่วนตัวแล้วเผยแพร่ตามไป
Plan มีโครงเป็นต้นไม้ที่แสดงส่วนอ่านข้อมูลและขั้นที่นำผลมาประมวลต่อ เช่น กรอง join เรียง หรือรวมค่า การตามจากแหล่งแถวเข้ามาช่วยให้เห็นว่างานจำนวนมากเกิดขึ้นก่อนหรือหลังเงื่อนไขที่ต้องการ
Sequential scan ไม่ได้แปลว่าผิดเสมอ และ index scan ก็ไม่ได้รับรองว่าถูกกว่าสำหรับทุกชุดข้อมูล ต้องดูว่า query ต้องใช้ข้อมูลสัดส่วนใดและมีขั้นตอนต่อจากการอ่านอย่างไร การสลับชื่อ node ให้เหมือนที่อยากเห็นจึงยังไม่ใช่เป้าหมายของการปรับ
ถ้ามี join ควรอ่านว่าผลจากด้านหนึ่งทำให้อีกด้านถูกเรียกซ้ำอย่างไร และจำนวนแถวที่ส่งต่อเปลี่ยนไปตรงไหน การคืนข้อมูลสุดท้ายไม่กี่แถวอาจยังผ่านงานกลางทางจำนวนมากได้ จึงต้องดูเส้นทางทั้งหมดก่อนสรุปจาก LIMIT ของผลลัพธ์
ส่วน sort หรือ aggregate ก็ต้องอาศัยข้อมูลที่ป้อนเข้ามา หากอ่านแถวเกินความต้องการตั้งแต่ต้น การแก้ปลายทางเพียงอย่างเดียวอาจยังเหลือภาระส่วนเดิมอยู่ ควรตั้งคำถามจากจำนวนและความกว้างข้อมูลที่เดินผ่านแต่ละช่วง
Cost ของ planner เป็นหน่วยประเมินตามแบบจำลอง ไม่ควรถูกอ่านเป็นเวลาจริงของ query ตัวเลขสองจุดใช้เทียบทางเลือกในบริบทที่เกี่ยวข้องได้ แต่ไม่ได้บอกว่าคนใช้จะรอกี่วินาทีตรงๆ
ค่าประมาณจำนวนแถวก็มีผลต่อการเลือกแผน ถ้าเมื่อนำไปทดลองแล้ว actual ต่างจาก estimate มาก ควรตรวจ parameter การกระจายข้อมูลและ statistics ที่ planner ใช้ร่วมกัน ไม่เริ่มจากสมมติว่าขาด index เสมอ
ในแผนที่มี loops ต้องดูนิยามของตัวเลขที่รายงานต่อรอบด้วย ค่าบางส่วนเป็นค่าเฉลี่ยของการเรียกซ้ำ ไม่ใช่ผลรวมของทุกครั้ง และเวลาของ node อาจครอบงานลูกอยู่ด้วย การเอาเวลาทุกบรรทัดมาบวกกันจึงเสี่ยงนับงานซ้ำ
ถ้ายังไม่แน่ใจว่าค่าที่กำลังอ่านมีขอบเขตใด ให้เทียบคู่มือ PostgreSQL รุ่นเดียวกับฐานที่ใช้ก่อน โดยเฉพาะเมื่อเครื่องมือแสดงผลนำ raw plan ไปจัดรูปแบบใหม่ เพราะชื่อและตำแหน่งที่แสดงอาจทำให้มองไม่เห็นสิ่งที่ถูกรวมไว้
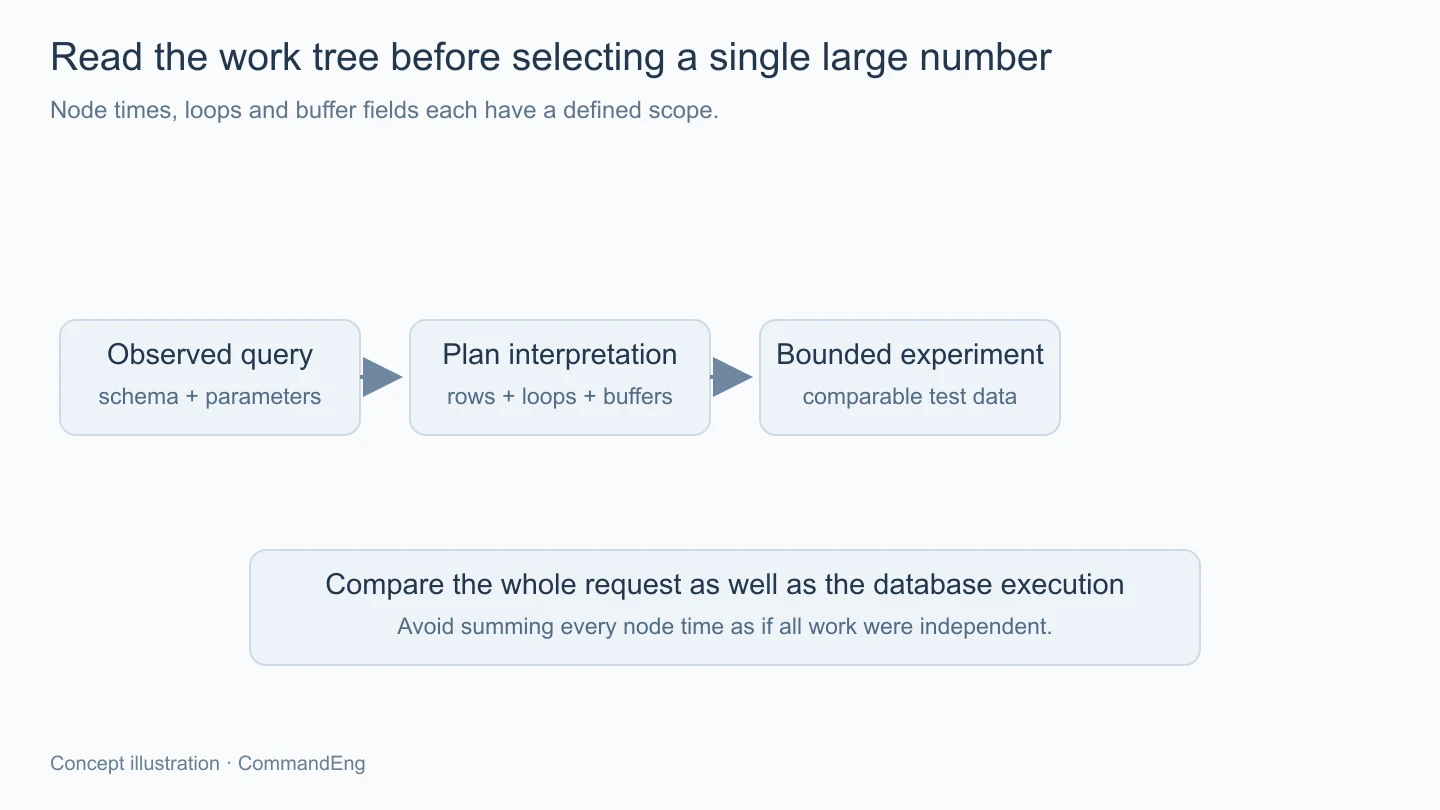
ตัวเลือก BUFFERS สามารถเพิ่มข้อมูลเกี่ยวกับการเข้าถึง buffer ตามการทำงานที่ตรวจได้ ช่วยดูว่าขั้นใดแตะข้อมูลมากและมีการ hit หรือ read ตามที่รายงาน แต่ไม่ควรแปลทุก read เป็นการอ่านดิสก์จริงด้วยเวลาคงที่ เพราะยังมีชั้นของระบบจัดเก็บกับ cache ที่เกี่ยวข้อง
ผลรอบแรกกับรอบหลังอาจต่างกันจากข้อมูลที่อยู่ใน cache แล้ว หรือจากโหลดอื่นที่เกิดร่วมกัน จึงต้องเก็บเงื่อนไขของการทดสอบ ไม่เลือกเฉพาะรอบหลังที่เร็วขึ้นแล้วอ้างว่าเกิดจากการเปลี่ยน query เพียงอย่างเดียว
เช่นเดียวกับ planning time และ execution time ต้องแยกจากเวลาผู้ใช้รอทั้ง request ซึ่งยังมีเครือข่าย pool การแปลงข้อมูล และงานในแอป ถ้า query ใช้เวลาเพียงส่วนหนึ่งของอาการ ต้องตามชั้นอื่นร่วมด้วยก่อนสรุปว่าการปรับ plan จะจบปัญหาหน้าเว็บ
ข้อมูลใน plan ยังอาจมีชื่อ relation เงื่อนไข และค่าที่ละเอียดอ่อน ก่อนแนบรายงานควรตัดสิ่งที่ไม่จำเป็นโดยรักษาโครงกับความหมายที่ใช้วินิจฉัยไว้ ไม่ส่งข้อมูลจริงทั้งหมดเพียงเพราะเครื่องมือสร้างเป็น JSON ให้พร้อมแล้ว
เริ่มจากกำหนด query กับ parameter ที่เป็นตัวแทนของงาน แล้วเก็บ schema, index และสภาพ statistics ที่ใช้ จากนั้นเลือกเปลี่ยนทีละสมมติฐาน เช่น ลดแถวที่อ่านหรือแก้การเรียงที่ไม่จำเป็น เพื่อดูว่าขั้นที่สงสัยเปลี่ยนอย่างไร
ใช้ข้อมูลขนาดและการกระจายที่ใกล้กับงานเป้าหมายภายในขอบเขตทดสอบที่เหมาะสม ตารางเล็กที่มีข้อมูลไม่กี่แถวอาจไม่เปิดเผยต้นทุนแบบเดียวกับตารางจริง แต่ก็ไม่ควรย้ายข้อมูลส่วนตัวมาทั้งหมดโดยไม่มีเหตุผลเพียงเพื่อให้จำนวนเท่ากัน
ผลที่ควรเปรียบเทียบคือแผน แถว loops buffer และเวลาที่เก็บจริง พร้อม workload อื่นที่อาจได้รับผล ไม่ใช่เฉพาะ cost ลดลงหรือรูป plan ดูสั้นลง หากยังไม่ได้รันทดลองก็ระบุเพียงข้อสังเกตกับสิ่งที่จะตรวจต่อได้
EXPLAIN ช่วยตั้งคำถามจากแผนและค่าประมาณ ส่วน ANALYZE เพิ่มหลักฐานจากการรันจริงที่ต้องจัดขอบเขตให้เหมาะ เมื่ออ่านต้นไม้ของงาน จำนวนแถว loops และ buffer ตามความหมายของมัน เราจะเลือกทดลองแก้ได้ตรงเหตุ และไม่เปลี่ยนเลข cost หรือรูปแผนให้กลายเป็นผลวัดที่ยังไม่ได้เกิดขึ้น