


เวลาหน้ารายการเริ่มโหลดช้า เราอาจเห็นคอลัมน์ที่ถูกค้นบ่อยแล้วคิดว่าจะเพิ่ม index ให้คอลัมน์นั้น แต่ query จริงมักไม่ได้มีเพียงเงื่อนไขเดียว ยังมีการกรองตามเจ้าของ ช่วงเวลา การเรียง และจำนวนรายการที่ต้องส่งกลับร่วมกันด้วย
Index ที่ตอบการค้นแบบหนึ่งอาจช่วยอีกแบบได้ไม่เท่ากัน ขณะเดียวกันแต่ละ index ก็ใช้พื้นที่กับการดูแลเมื่อข้อมูลถูกเขียน การเพิ่มตามรายชื่อ field ทุกอันจึงอาจทำให้มีของเพิ่มโดยยังไม่รู้ว่าแก้งานที่ช้าตรงไหน
จุดเริ่มที่เหมาะกว่าคือดูรูป query ที่ต้องให้บริการครับ พร้อมขนาดและการกระจายข้อมูล แล้วตั้งสมมติฐานว่า index แบบใดช่วยลดงานส่วนไหน ก่อนตรวจจาก plan กับผลทดลองจริง ไม่เริ่มจากรับรองว่ามี index แล้วจะเร็วเสมอ
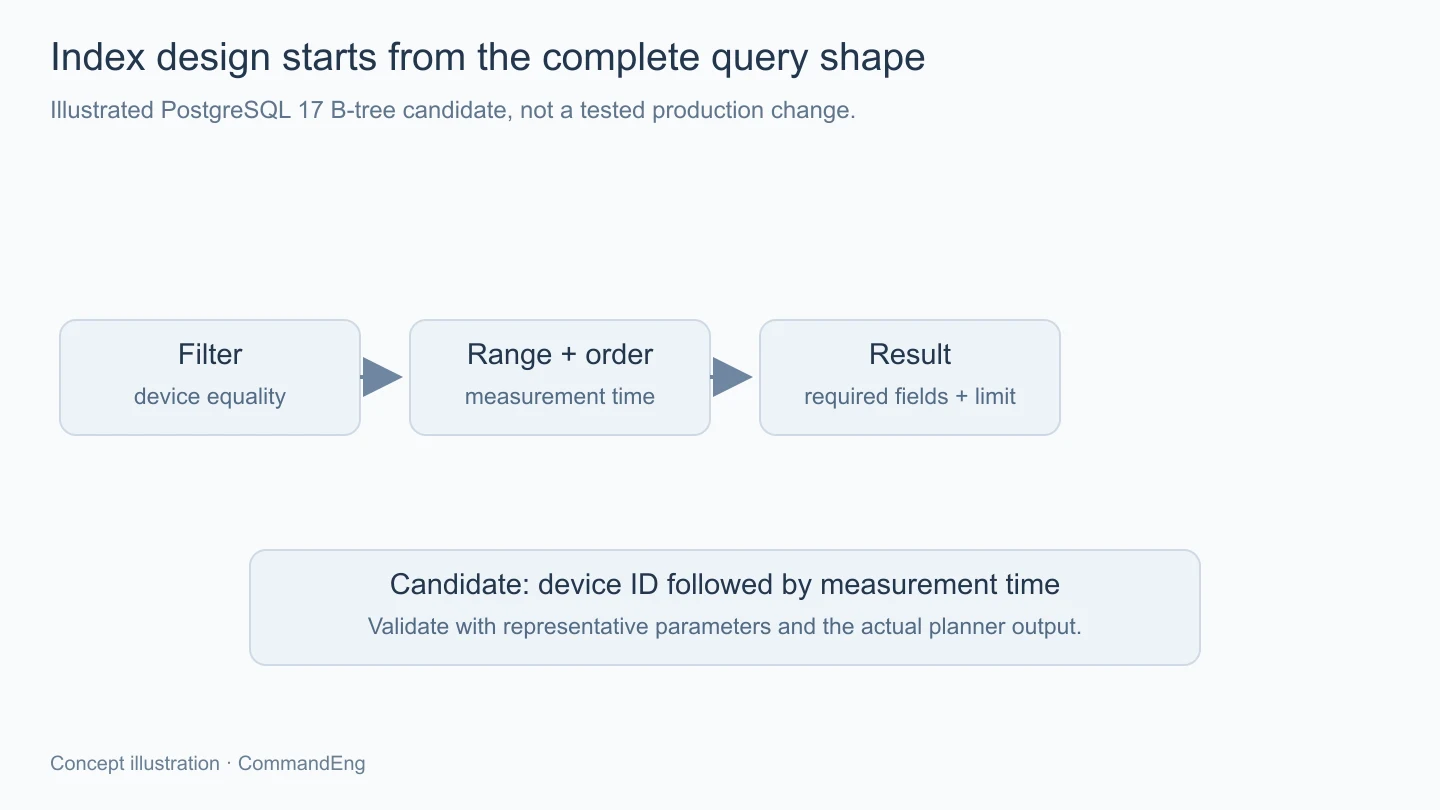
ลองใช้ตารางสมมติ sensor_events ที่มี device_id, measured_at และ value หากหน้ารายการต้องการข้อมูลของอุปกรณ์หนึ่งตัวตั้งแต่เวลาที่กำหนด และแสดงล่าสุดก่อน เงื่อนไขกับการเรียงเป็นส่วนเดียวของคำถามที่ควรนำมาคิดร่วมกัน
ตัวอย่าง SQL นี้ใช้ parameter placeholders สำหรับส่งค่าตามวิธีของไลบรารี และไม่ได้เป็นคำสั่งที่นำไปตรวจฐานข้อมูลของเว็บจริง
SELECT measured_at, value
FROM sensor_events
WHERE device_id = $1
  AND measured_at >= $2
ORDER BY measured_at DESC
LIMIT 100;
สิ่งที่อยากลดอาจเป็นการเดินอ่านเหตุการณ์ของอุปกรณ์อื่น การกรองช่วงเวลา หรือการเรียงชุดข้อมูลขนาดใหญ่ ต้องเปิด plan ดูว่าฐานข้อมูลทำอะไรอยู่ก่อน ไม่ถือว่า bottleneck อยู่คอลัมน์เวลาเพียงเพราะหน้าจอเรียงตามเวลานั้น
ค่าที่ใช้จริงก็มีผล หากอุปกรณ์หนึ่งมีข้อมูลเกือบทั้งตาราง ส่วนอีกตัวมีเพียงเล็กน้อย planner อาจประเมินต้นทุนต่างกัน จึงควรเก็บชุด parameter ที่เป็นตัวแทนงาน ไม่ทดสอบเฉพาะรหัสที่บังเอิญมีข้อมูลน้อยที่สุด
สำหรับ B-tree ใน PostgreSQL 17 ที่ใช้เป็นฐานของบทนี้ ลำดับคอลัมน์มีผลต่อขอบเขตที่ต้องเดิน index โดยเงื่อนไข equality ของคอลัมน์นำกับเงื่อนไขช่วงในตำแหน่งถัดไปมีบทบาทตามที่เอกสารอธิบาย ไม่ใช่มีชื่อคอลัมน์ครบใน index แล้วจะเท่ากันทุกการเรียง
ในตัวอย่าง อาจเริ่มประเมิน index ที่นำด้วย device_id แล้วตาม measured_at เพื่อให้สัมพันธ์กับการเจาะอุปกรณ์กับช่วงเวลา แต่ยังต้องตรวจ plan และการใช้งานอื่นก่อนเลือก นี่เป็นสมมติฐานของรูป query ไม่ใช่คำแนะนำให้สร้างในทุกตารางที่มีสอง field นี้
รูปคำสั่งสำหรับฐานข้อมูลทดลองอาจเป็นดังนี้ ต้องใช้กับ schema ที่ตั้งใจสร้างไว้สำหรับตรวจ และวางแผนนำขึ้นระบบจริงแยกต่างหาก
CREATE INDEX sensor_events_device_time
ON sensor_events (device_id, measured_at DESC);
การค้นเฉพาะ measured_at โดยไม่กรอง device_id เป็นอีก workload หนึ่งที่ต้องประเมิน ไม่สรุปว่า index ของตัวอย่างตอบคำถามนั้นได้เหมาะเท่ากันทุกกรณี และต้องจำว่าความสามารถของ planner เปลี่ยนตามรุ่น จึงควรอ่านเอกสารให้ตรงฐานที่ใช้อยู่
ถ้า query ต้องอ่านข้อมูลสัดส่วนมากของตาราง การอ่านแบบ sequential scan อาจเป็นทางเลือกที่ฐานข้อมูลประเมินว่าเหมาะกว่า ไม่ควรถือว่าไม่ใช้ index เท่ากับระบบผิดโดยอัตโนมัติ ต้องดูจำนวนแถวที่ต้องอ่านกับงานต่อเนื่องใน plan
สถิติที่ planner ใช้กับข้อมูลจริงก็สำคัญ หากค่าประมาณต่างจากการทำงานมาก ควรดูสภาพข้อมูลและการอัปเดต statistics ตามวิธีที่ฐานใช้ ก่อนพยายามบังคับรูป plan ที่คาดไว้จากชื่อ index
เงื่อนไข query ต้องเทียบกับสิ่งที่ index รองรับด้วย เช่น การใช้ expression, operator หรือการแปลงชนิดอาจมีผลต่อวิธีเข้าถึงข้อมูล ต้องดูรูปที่แอปส่งจริง ไม่ตรวจจาก query ที่เขียนย่อด้วยมือแล้วพบว่ารูปแบบไม่เหมือนที่ production ใช้
ส่วนการเรียงกับ LIMIT ก็มีผลต่อการเลือกแผน จึงต้องเก็บสองส่วนนี้ไว้ในการทดสอบ ไม่ลบ ORDER BY ออกเพื่อให้ query สั้นลงแล้วนำผลไปสรุปว่าแผนของหน้ารายการจริงจะเหมือนกัน
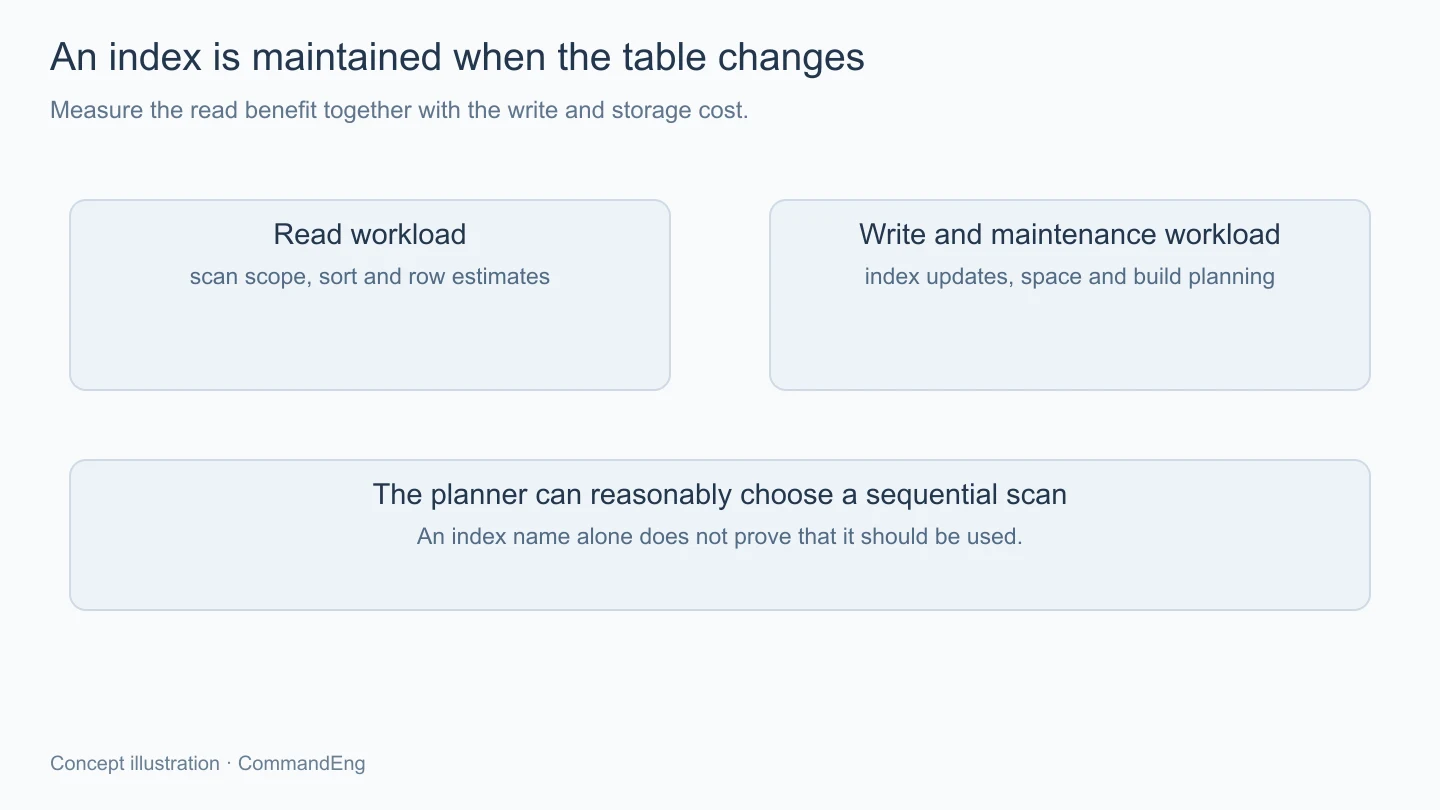
Index เป็นโครงสร้างที่ฐานต้องรักษาเมื่อข้อมูลเปลี่ยน จึงมีทั้งพื้นที่และภาระการเขียนเพิ่ม การเลือกหลาย index ที่ซ้อนหน้าที่กันควรมีเหตุผลของ workload ไม่เพิ่มทุก combination เผื่อไว้ก่อนโดยไม่มีหลักฐานว่าถูกใช้
ก่อนลบ index ที่ดูเหมือนไม่มีใครใช้ ต้องรู้ช่วงข้อมูลสถิติและงานที่เกิดเป็นรอบด้วย บาง query สำคัญอาจไม่ได้รันในช่วงสั้นที่กำลังดู และบาง index มีหน้าที่เรื่อง constraint ซึ่งต้องแยกจากการเลือกเพื่อความเร็วทั่วไป
ขั้นสร้าง index บนตารางจริงยังมีเรื่อง lock, เวลา และทรัพยากรที่ต้องวางแผน PostgreSQL มีตัวเลือกสร้างแบบ concurrent ตามข้อกำหนด แต่ไม่ควรเติมคำนี้ลงทุก migration โดยไม่อ่านข้อจำกัดกับวิธีรับมือเมื่อขั้นสร้างไม่สมบูรณ์
ดังนั้นบทนี้ใช้ SQL เป็นตัวอย่างโครงสำหรับทดลองเท่านั้น ไม่ใช่คำสั่งให้รันกับฐานใช้งานจริงทันที การนำขึ้นควรมีข้อมูลขนาดใกล้เคียง แผนตรวจสถานะ และขอบเขตผลกระทบที่เจ้าของระบบเข้าใจ
เก็บ plan ก่อนเปลี่ยน parameter ที่ใช้ ขนาดข้อมูลและสถิติที่เกี่ยวข้อง จากนั้นสร้าง index ในชุดทดลองแล้วตรวจ query เดิมภายใต้เงื่อนไขที่เปรียบเทียบได้ ดูทั้งเวลารวม แถวที่อ่าน การเรียง และ buffer ตามสิ่งที่เครื่องมือแสดงจริง
อย่าลืมดูการเขียนและ query อื่นที่ใช้ตารางร่วมกัน หากเวลาอ่านหนึ่งหน้าลดแต่ภาระงานหลักอีกส่วนเพิ่มขึ้นจนไม่เหมาะ ก็ต้องเลือกจากภาพรวม การมีผลวัดพร้อมบริบทช่วยให้คุย tradeoff ได้ตรงกว่าภาพ plan ที่เลือกมาเพียงรอบเดียว
หากยังไม่มีการทดลอง ก็อธิบายได้เพียงว่ารูปแบบใดควรถูกประเมิน ไม่ใส่ตัวเลขความเร็วหรือเปอร์เซ็นต์จากการคาดเดา เพราะต้นทุนขึ้นกับข้อมูลและสภาพระบบที่ต้องตรวจจริง
Index ควรถูกเลือกจากรูป query ทั้งการกรอง การเรียง และข้อมูลที่ต้องคืน พร้อมต้นทุนการเขียนและดูแล เมื่อเริ่มจาก plan แล้วตรวจสมมติฐานด้วยงานตัวแทน เราจะรู้ว่าโครงสร้างที่เพิ่มช่วยลดงานตรงไหน และตัดสินได้จากผลของระบบรวมโดยไม่เพิ่ม index ตามชื่อคอลัมน์เพียงอย่างเดียว