


Query ที่อ่านหรือแก้เพียงไม่กี่แถวอาจใช้เวลานานจนหน้าเว็บรอไม่ไหว ทั้งที่ดูจากเงื่อนไขแล้วไม่น่าต้องสแกนข้อมูลมาก หากเริ่มแก้ด้วยการเพิ่ม index ทันที เราอาจกำลังแก้คนละช่วงของเวลาที่หายไป
ใน PostgreSQL คำสั่งอาจต้องรอ lock ที่ขัดกับงานอื่นก่อนจะเดินต่อ การรอนี้มีเหตุผลด้านความสอดคล้องของข้อมูล แต่ถ้าคนถือ lock เปิด transaction ค้างไว้ งานสั้นที่ตามมาก็อาจรออยู่นานได้
จึงควรแยกผู้รอกับต้นทางที่ทำให้รอก่อนครับ แล้วค่อยตัดสินว่าจะปรับ query ขอบเขต transaction หรือนโยบายเวลารออย่างไร
ตั้งแต่แอปขอ connection ไปจนได้คำตอบ มีได้ทั้งเวลารอ pool เวลาส่งคำสั่ง เวลารอ lock และเวลาประมวลผลจริง การเห็น API ช้าจึงยังไม่ได้ระบุว่าฐานกำลังอ่านข้อมูลจากดิสก์นานหรือ CPU ไม่พอ
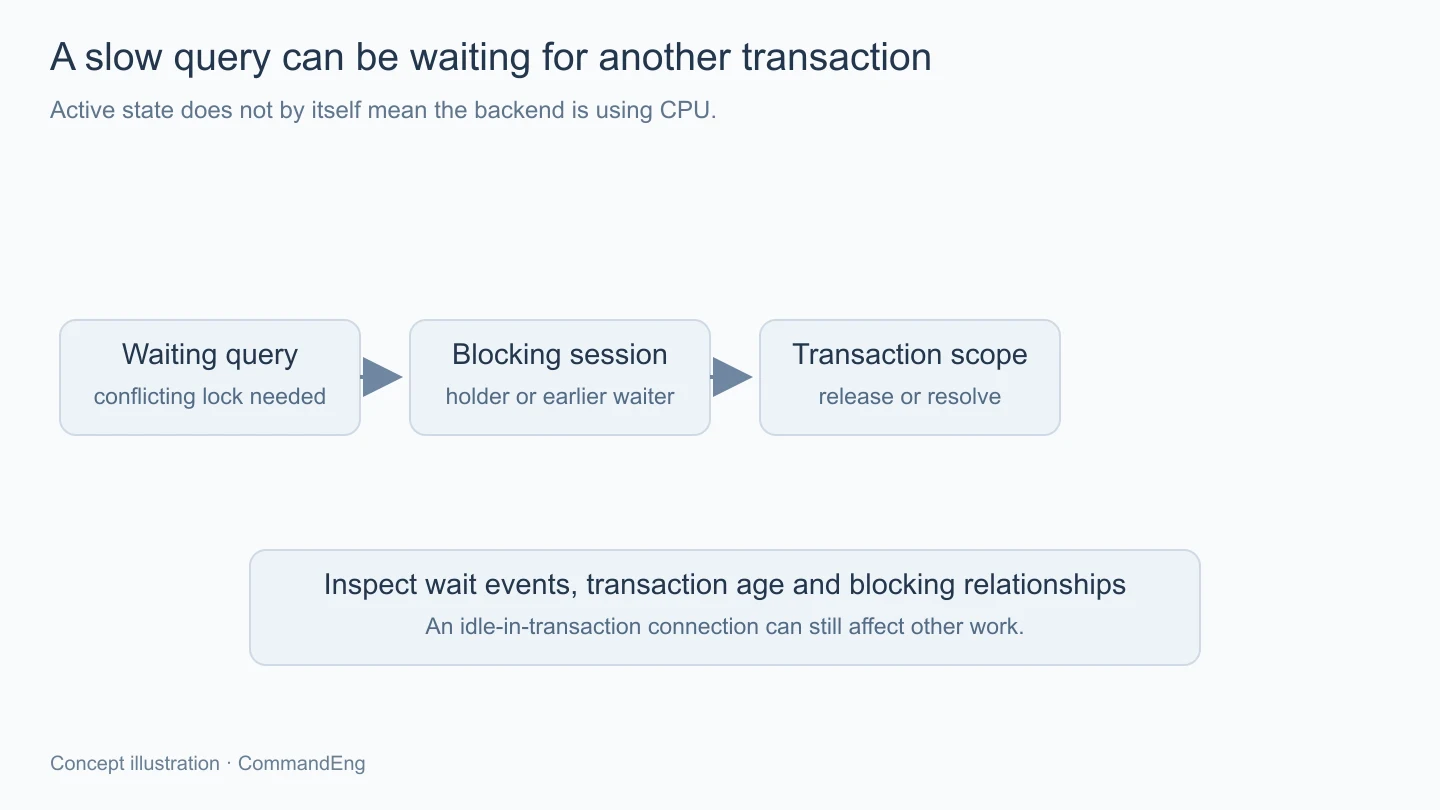
หากคำสั่งถึง server แล้ว ควรดู state กับ wait event ตามที่ PostgreSQL รายงานประกอบกัน สถานะ active บอกว่ามี query อยู่ในช่วงทำงาน แต่ไม่ได้แปลว่ามันกำลังใช้ CPU ตลอด เพราะยังอาจรอเหตุการณ์บางอย่างอยู่
ฝั่งแอปควรมีตัวอ้างอิงที่ช่วยผูกคำขอกับ session ตามความเหมาะสม โดยไม่เก็บ credential หรือค่าพารามิเตอร์ลับไว้ในรายงาน การเทียบเวลาโดยไม่มีตัวตนคำขออาจพาไปอ่าน query ของผู้ใช้อีกคนที่เริ่มใกล้กันแทน
PostgreSQL มีทั้ง table-level และ row-level lock หลายโหมดซึ่งขัดกันต่างชุด คำสั่งทั่วไปก็รับ lock ที่เหมาะสมเอง ไม่ใช่ต้องมี LOCK TABLE เขียนอยู่ในโค้ดก่อนจึงเกิดการรอได้
โดยทั่วไป lock ที่ transaction ถืออยู่จะอยู่จนจบ transaction ตามกติกา ส่วนกรณี savepoint และการย้อนบางช่วงมีรายละเอียดเพิ่ม การที่ statement แรกทำเสร็จจึงไม่ได้รับรองว่าทรัพยากรทั้งหมดถูกปล่อยให้ transaction อื่นแล้ว
ตัวอย่างสมมติคือแอปแก้รายการหนึ่งภายใน transaction แล้วไปเรียกบริการเครือข่ายก่อน commit หากบริการนั้นตอบช้า งานอื่นที่ต้องแก้รายการขัดกันก็ต้องรอตาม ทั้งที่ SQL ที่แก้รายการแรกอาจใช้เวลาจริงสั้นมาก
จึงควรลดช่วงที่ถือ transaction ให้ครอบคลุมเฉพาะสิ่งที่จำเป็นต่อความถูกต้อง ไม่เปิดรอผู้ใช้กดยืนยันหรือรอ API ภายนอกโดยไม่มีเหตุผลด้านสัญญางาน หากต้องประสานผลข้ามระบบ ต้องออกแบบสถานะและการส่งต่อแทนการถือ lock ไว้รออย่างเดียว
pg_stat_activity ช่วยดู session สถานะ เวลาเริ่ม transaction และ wait event ส่วน pg_blocking_pids ช่วยระบุ process ที่ขวางการรับ lock ตามความหมายของฟังก์ชัน ซึ่งอาจเกี่ยวข้องกับทั้งผู้ถือ lock และผู้รอที่อยู่ก่อนในคิว
ตัวอย่างอ่านข้อมูลต่อไปนี้เป็นจุดเริ่มสำหรับระบบที่มีสิทธิ์ตรวจ ไม่ใช่ผลจากฐานจริง และไม่ได้เลือกว่าจะยุติ session ใดให้โดยอัตโนมัติ
SELECT pid, state, xact_start, wait_event_type, wait_event,
       pg_blocking_pids(pid) AS blocking_pids
FROM pg_stat_activity
WHERE datname = current_database();
ควรอ่านขอบเขตสิทธิ์ของบัญชีที่ตรวจ เพราะข้อมูลบางส่วนถูกจำกัดตามบทบาท และไม่ควรเรียกถี่จนเครื่องมือดูปัญหาเองเพิ่มภาระโดยไม่จำเป็น ผลแต่ละครั้งก็เป็นภาพช่วงเวลานั้น จึงต้องเก็บเวลากับความสัมพันธ์ของ session ไว้ด้วย
ถ้าพบ idle in transaction หมายถึง session ยังอยู่ใน transaction แต่ขณะนั้นไม่ได้รัน query ไม่ได้หมายความว่าไม่มีผลต่อคนอื่น ต้องตามเจ้าของ connection กับเส้นทางแอปว่าทำไมยังไม่ commit หรือ rollback
การมีหลายงานรอ session เดียวอาจเป็นคิวที่ยังเดินต่อได้เมื่อเจ้าของปล่อย lock ส่วน deadlock เป็นความสัมพันธ์วนที่แต่ละฝ่ายถือสิ่งที่อีกฝ่ายต้องการและไม่มีใครไปต่อได้ตามลำดับนั้น
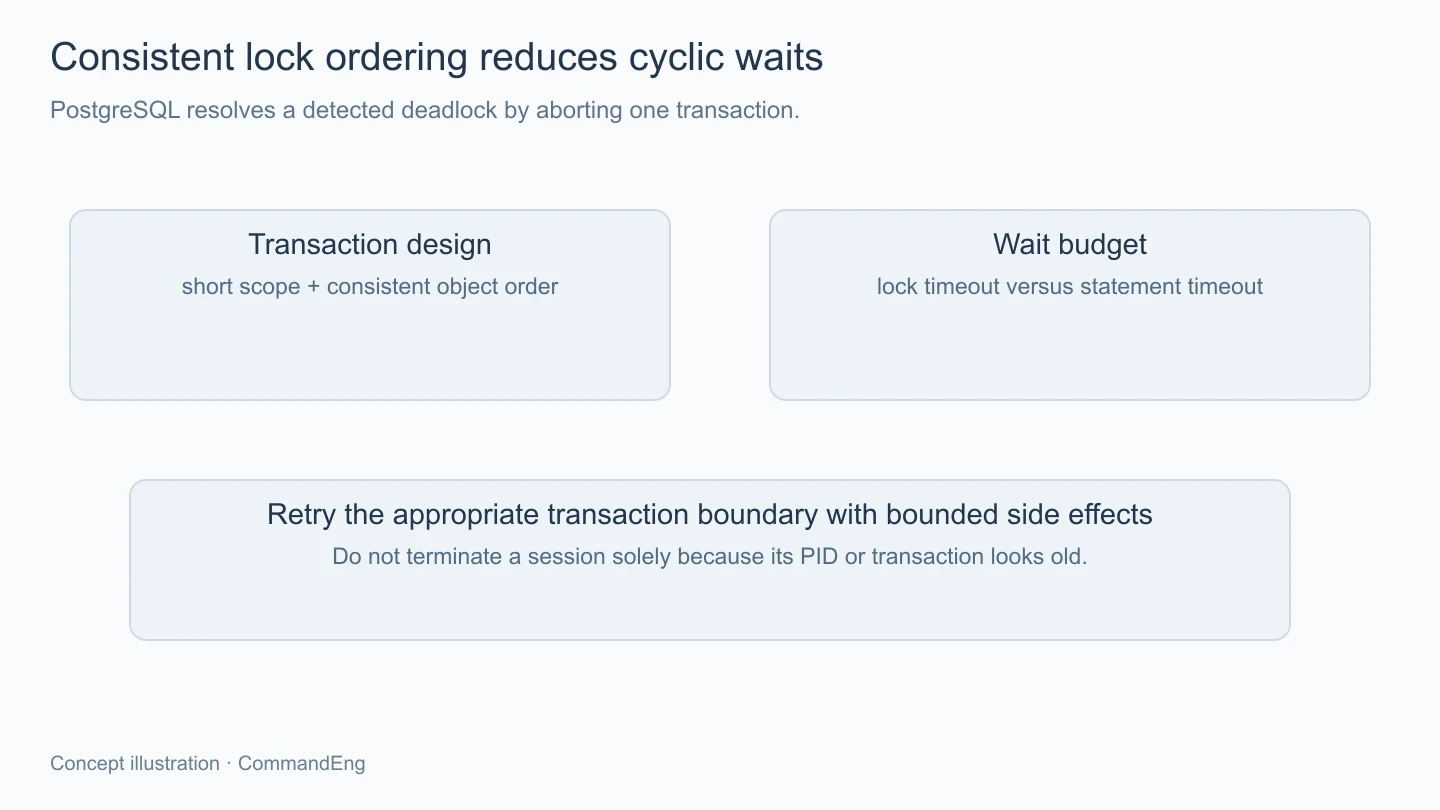
PostgreSQL ตรวจ deadlock แล้ว abort transaction หนึ่งเพื่อให้ส่วนที่เหลือดำเนินต่อ แต่ไม่ควรเขียนแอปโดยพึ่งว่าฝ่ายใดจะเป็นผู้ถูกเลือกแน่นอน การถูก abort ก็ต้องมีทางกลับไปเริ่ม transaction ใหม่จากข้อมูลที่เหมาะสมตามสัญญาของงาน
การรับ lock ของหลายรายการตามลำดับที่สอดคล้องกันช่วยลดโอกาสวนรอ เช่น งานสองทางที่ต้องแตะรายการคู่เดียวกันควรมีหลักเลือกก่อนหลังร่วมกัน ไม่ปล่อยให้ลำดับขึ้นกับว่าผู้ใช้เลือกตัวใดก่อนในหน้าจอ
หาก retry หลัง deadlock ต้องคิดผลนอก transaction ด้วย ฐานย้อนการเปลี่ยนภายในได้ตามขอบเขต แต่ไม่ได้ยกเลิกอีเมลหรือคำขอที่ส่งออกไปแล้วเอง จึงไม่ครอบทั้งฟังก์ชันด้วย retry แบบไม่ตรวจว่าแต่ละขั้นมีผลที่ทำซ้ำได้หรือไม่
lock_timeout ใช้จำกัดช่วงรอรับ lock ตามกติกาของ PostgreSQL ส่วน statement_timeout ครอบคลุมอายุ statement ในขอบเขตที่ต่างกัน การตั้งชื่อคล้ายกันไม่ได้หมายความว่าแทนกันได้หรือควรใส่ค่ารวมทั้งระบบเหมือนกัน
ค่า timeout ที่สั้นเกินสภาพงานอาจเปลี่ยนจากการรอเป็น error จำนวนมากโดยต้นเหตุยังอยู่ ส่วนค่าสูงมากก็อาจทำให้ connection ถูกใช้รอนานจนกระทบ pool ต้องเลือกตามลักษณะคำสั่งกับเวลาที่ผลิตภัณฑ์ยอมรับได้และมีทางจัดการ error ต่อ
หากจำเป็นต้องหยุดงานที่ขวาง ต้องรู้เจ้าของและผลของ transaction นั้นก่อน การยุติ connection เป็นการตัดงานซึ่งมีต้นทุนและผลต่อแอป ไม่ควรเลือกจาก PID ที่ดูเก่าที่สุดเพียงอย่างเดียว หรือยกเลิกผู้อ่านทุกตัวเพื่อให้การเปลี่ยน schema ผ่าน
หลังแก้ ควรตรวจทั้งเวลารอและความถูกต้องของงานพร้อมกัน โดยจำลองการทำงานพร้อมกันในฐานทดสอบที่แยกไว้ การรัน query เดี่ยวได้เร็วไม่พิสูจน์ว่าลำดับ lock สองเส้นทางจะไม่วนกันเมื่อมีผู้ใช้หลายคน
Query ที่ช้าอาจกำลังรอความรับผิดชอบของ transaction อื่น การดูผู้รอ ผู้ขวาง และอายุ transaction ช่วยแยกปัญหาออกจากการเลือกแผน query เมื่อจัดขอบเขต transaction ลำดับ lock และ timeout ให้สัมพันธ์กับงาน เราจะลดการรอที่ไม่จำเป็นพร้อมรักษาความถูกต้อง แทนการเร่งคำสั่งที่ยังไม่ได้เริ่มทำงานจริง