


แอปที่แยกฐานอ่านออกจากฐานเขียนอาจมีอาการบันทึกผ่านแล้วเปิดหน้ารายการกลับไม่เห็นข้อมูลใหม่ พอกดซ้ำจึงเสี่ยงสร้างรายการเพิ่ม ทั้งที่งานแรกถูกเก็บไว้ที่ primary แล้วตามปกติ
ความต่างนี้เกิดได้จากเส้นทางของข้อมูลและจังหวะที่ transaction อ่าน ไม่จำเป็นต้องแปลว่า INSERT หายไป หากคำขอถัดไปถูกส่งไป standby ที่ยัง replay การเปลี่ยนนั้นไม่ถึง ผลที่อ่านก็ยังเป็นฉบับก่อนหน้าได้
ก่อนกระจายคำขออ่านจึงต้องกำหนดว่างานใดยอมรับข้อมูลเก่าได้เพียงใดครับ แล้วใช้เกณฑ์นั้นเลือกปลายทาง แทนการถือว่า replica ทุกตัวเป็นสำเนาล่าสุดอยู่ตลอดเวลา
ใน physical replication ของ PostgreSQL มีเส้นทางส่งข้อมูล WAL จาก primary ไปยัง standby แล้วนำไป replay เพื่อสร้างสภาพฐานที่อ่านได้ การรับข้อมูล การเขียนลงพื้นที่ และการ replay มีความหมายต่างกันในกระบวนการนี้
การที่ primary ตอบ commit ตามนโยบายที่ตั้งอยู่จึงต้องอ่านภายใต้ขอบเขตการยืนยันนั้น หากเป็น asynchronous replication ก็ไม่ได้รอให้ทุก standby นำผลไปใช้และพร้อมให้ query ใหม่เห็นก่อนตอบ client
ตัวอย่างสมมติคือคำขอสร้างบทความสำเร็จจาก primary แล้วหน้ารายการไปอ่านอีกเครื่องทันที หากอีกเครื่องยังไม่ replay commit ของรายการนั้น ก็อาจยังไม่อยู่ในผลค้น แม้ transaction แรกสำเร็จจริงแล้วก็ตาม ตัวอย่างนี้อธิบายกลไก ไม่ใช่รายงานว่าเว็บนี้พบเหตุการณ์ดังกล่าว
สิ่งที่ต้องเก็บเพื่อไล่เหตุจึงมีทั้งตัวตนรายการ ผล commit ปลายทางที่อ่านและจังหวะของคำขอ ไม่ใช้ข้อความว่าฐานตอบ200จากชั้น API อย่างเดียวเพื่ออธิบายว่าระบบฐานแต่ละตัวเห็นข้อมูลแล้วเท่ากัน
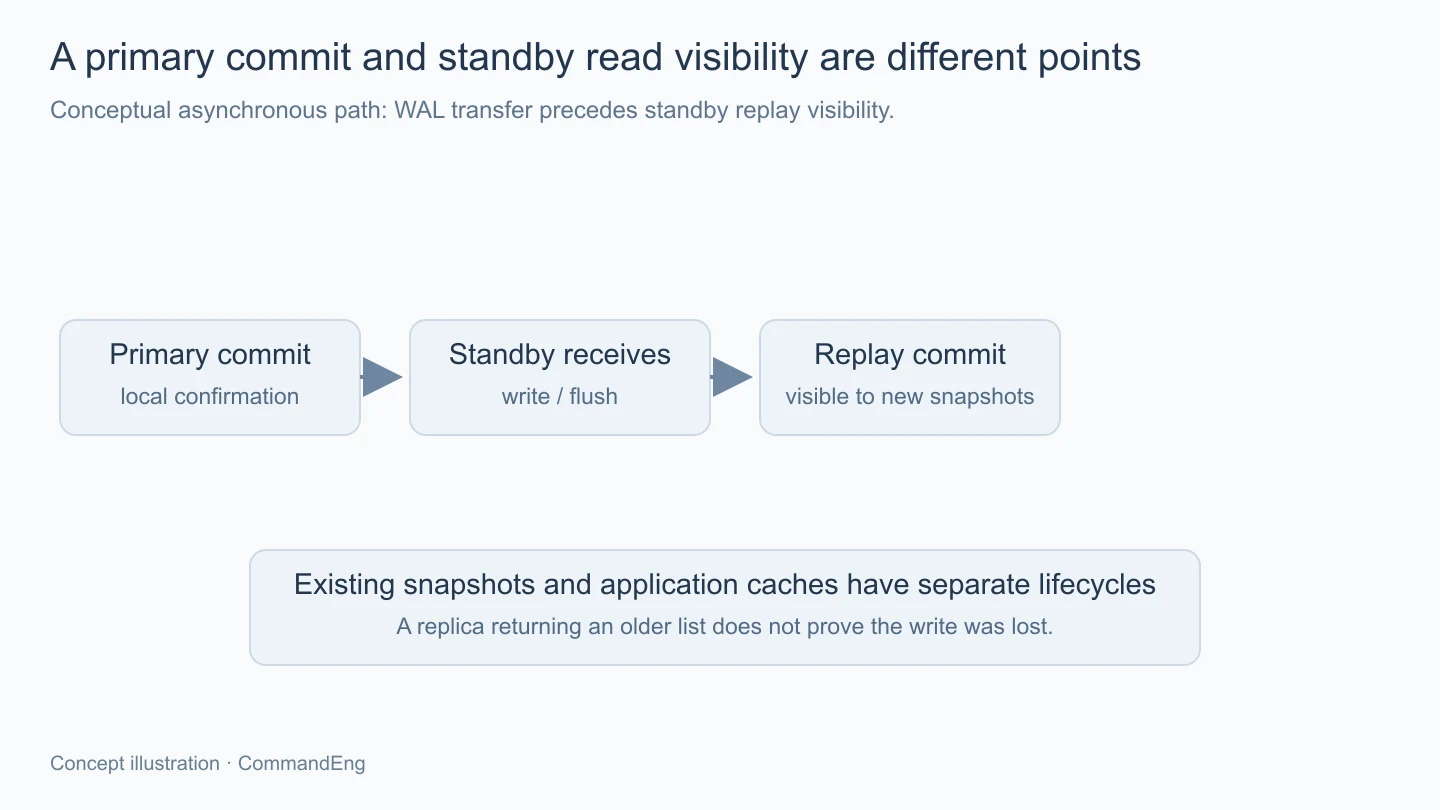
เมื่อ standby replay commit แล้ว การเปลี่ยนนั้นพร้อมให้ snapshot ใหม่มองเห็นตามกติกา แต่ query หรือ transaction ที่อ่านด้วย snapshot เดิมยังต้องพิจารณาตาม isolation level ที่ใช้ ไม่ใช่เห็นว่าฐานรับข้อมูลเพิ่มแล้วผู้อ่านทุกคนเปลี่ยนภาพย้อนหลังตามทันที
จึงต้องแยกกรณี replica ยังตามไม่ถึงออกจากกรณี client ถือ transaction อ่านชุดเดิมไว้นาน การเปิด query ใหม่ใน transaction เดิมกับการเริ่ม transaction ใหม่อาจมีความหมายต่างกันตามระดับที่กำหนด
บน primary เองก็มีขอบเขตการมองเห็นของ transaction เช่นกัน การย้ายคำอ่านกลับ primary จึงควรทำให้สัมพันธ์กับการ commit ที่ยืนยันแล้วและ snapshot ที่เหมาะสม ไม่ใช้เป็นคำแก้ทุกกรณีโดยยังไม่ตรวจลำดับของแอป
Cache ของแอปหรือ HTTP เป็นอีกชั้นที่ต้องตาม หาก query จากฐานให้ข้อมูลใหม่แล้วแต่หน้าแสดงฉบับเก่า การเพิ่มความเข้มของ replication ก็ไม่ได้ล้าง cache นั้นให้ เราต้องผูกหลักฐานจากแต่ละชั้นก่อนเลือกแก้
ข้อมูลสรุปสำหรับดูแนวโน้มอาจยอมให้ตามหลังได้ตามเงื่อนไขงาน แต่หน้าที่ผู้ใช้เพิ่งแก้ข้อมูลแล้วต้องตรวจว่าฉบับของตัวเองถูกเก็บครบ มักต้องมีทางอ่านผลที่สัมพันธ์กับการเขียนนั้นอย่างชัดเจน
ทางหนึ่งคือให้คำตอบหลังเขียนคืนข้อมูลฉบับที่ยืนยันแล้ว หรืออ่านต่อจาก primary ในเส้นทางที่ต้องการ read-after-write ตามสัญญาของระบบ ส่วนการส่งไป replica อาจต้องมีเงื่อนไขว่าจุดนั้นตามถึงการเปลี่ยนที่เกี่ยวข้องแล้วจริง
การหน่วงเวลาให้รอช่วงหนึ่งก่อนอ่านเป็นเพียงสมมติฐานเรื่องเวลาตาม ไม่ใช่หลักฐานว่า replica ต้องทันเสมอ เมื่อมีภาระหรือเครือข่ายต่างออกไป ช่วงเดียวกันก็อาจไม่พอ ควรออกแบบทาง fallback หรือสถานะรอที่ตรงกับสิ่งที่ตรวจได้
หากใช้หลักฐานตำแหน่ง WAL หรือกลไกเฉพาะของระบบ ต้องดูว่าเปรียบเทียบอยู่บนสายข้อมูลและอายุของ primary ที่ถูกต้อง พร้อมจำกัดเวลารอ ไม่ทำเป็นการรอไม่สิ้นสุดที่ย้ายปัญหาจากข้อมูลเก่าไปเป็นคำขอค้าง
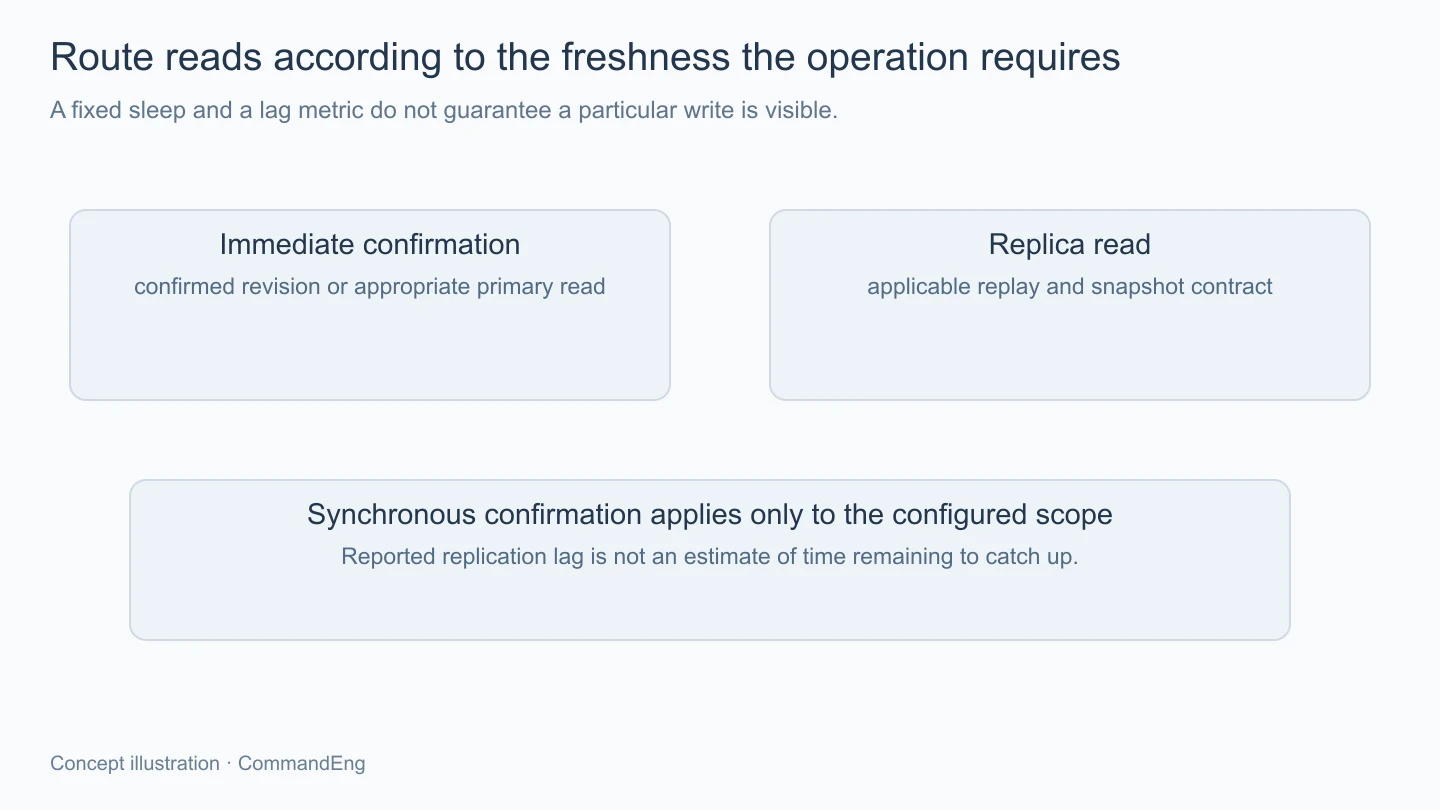
Synchronous replication ต้องอ่านร่วมกับค่าที่กำหนดว่ารอ standby ใด จำนวนเท่าไร และรอถึงขั้นใด การมี replica หลายตัวไม่ได้หมายความว่าทุกตัวอยู่ในชุดที่ commit ต้องรอเหมือนกัน
PostgreSQL มีความต่างระหว่างการยืนยันรับหรือเขียนข้อมูลกับการ replay โดย remote_apply ใช้รอการนำ transaction ไปใช้บน synchronous standby ที่เกี่ยวข้องตาม config แต่ยังต้องเลือกทางอ่านให้ตรงกับขอบเขตนั้น
Replica ที่ไม่ได้เป็นฝ่ายที่ต้องรอ หรือ standby ชั้นถัดไปในโครงสร้างแบบส่งต่อ จึงยังต้องพิจารณาความสดของตัวเอง ไม่ใช้ชื่อโหมดเดียวไปสรุปแทนปลายทางทั้งหมดที่ load balancer อาจเลือก
การเพิ่มระดับการรอยังมีผลต่อ latency และความพร้อมรับงานเมื่อปลายทางที่ต้องยืนยันมีปัญหา จึงควรเลือกจากข้อกำหนดข้อมูลกับขอบเขตบริการ ไม่เปลี่ยนค่า production เพื่อแก้หน้ารายการช้าโดยยังไม่ประเมินผลต่อทุก transaction
ข้อมูลใน pg_stat_replication ช่วยดูจังหวะส่ง เขียน flush และ replay ตามคอลัมน์ที่ระบบให้ แต่ค่าระยะ lag ไม่ใช่คำพยากรณ์ว่าอีกกี่วินาที standby จะตามทันทั้งหมด ไม่ควรนำไปนับถอยหลังให้ผู้ใช้โดยไม่มีความหมายรองรับ
เมื่อระบบเงียบและตามทันแล้ว ค่าบางชุดอาจเปลี่ยนเป็น NULL ตามพฤติกรรมของสถิติ การแทนทุก NULL เป็นความล้มเหลวหรือเป็นศูนย์โดยอัตโนมัติจึงอาจสร้างภาพผิด ต้องแยกไม่ทราบค่า ไม่มีข้อมูลใหม่ และการเชื่อมต่อที่มีปัญหาตามหลักฐานอื่นด้วย
Query ที่รันนานบน standby ยังอาจขัดกับการนำ WAL ไปใช้ตามข้อจำกัดของ hot standby การเลือกให้รอหรือยกเลิก query เกี่ยวข้องกับความสดและความพร้อมใช้งาน ไม่ใช่เพียงตั้งเวลาให้นานที่สุดแล้วได้ทั้งการอ่านไม่สะดุดกับข้อมูลล่าสุดฟรีๆ
ชุดทดสอบควรมีการเขียนแล้วอ่านทันที การชะลอเส้นทางจำลอง และการอ่านผ่านปลายทางหลายตัวในสภาพแวดล้อมแยก พร้อมตรวจว่า UI ไม่แปลรายการที่ยังไม่เห็นเป็นการบันทึกล้มเหลวแล้วส่งซ้ำเอง
Replica ช่วยแยกภาระและรองรับรูปแบบบริการได้ แต่ความสดของการอ่านต้องสัมพันธ์กับการส่ง replay และ snapshot ของผู้ใช้ เมื่อกำหนดสัญญาอ่านหลังเขียนกับทางเลือกปลายทางให้ชัด เราจะอธิบายข้อมูลที่ยังตามไม่ทันได้ตรงเหตุ และรักษาผลเขียนเดิมโดยไม่ชวนให้ผู้ใช้สร้างงานซ้ำจากหน้าที่อ่านฉบับเก่า