


เวลาเปิดหน้า metrics ของบริการ เราอาจเจอค่าที่ลงท้ายด้วย total แล้วเห็นตัวเลขเพิ่มขึ้นไปเรื่อยๆ เช่น จำนวนคำขอที่รับหรือจำนวนงานที่ทำเสร็จ ตัวเลขแบบนี้ช่วยบอกว่ามีกิจกรรมสะสมมาเท่าไร แต่ถ้าจะดูว่าช่วงนี้ระบบกำลังยุ่งแค่ไหน การมองค่าล่าสุดอย่างเดียวอาจยังตอบไม่ได้
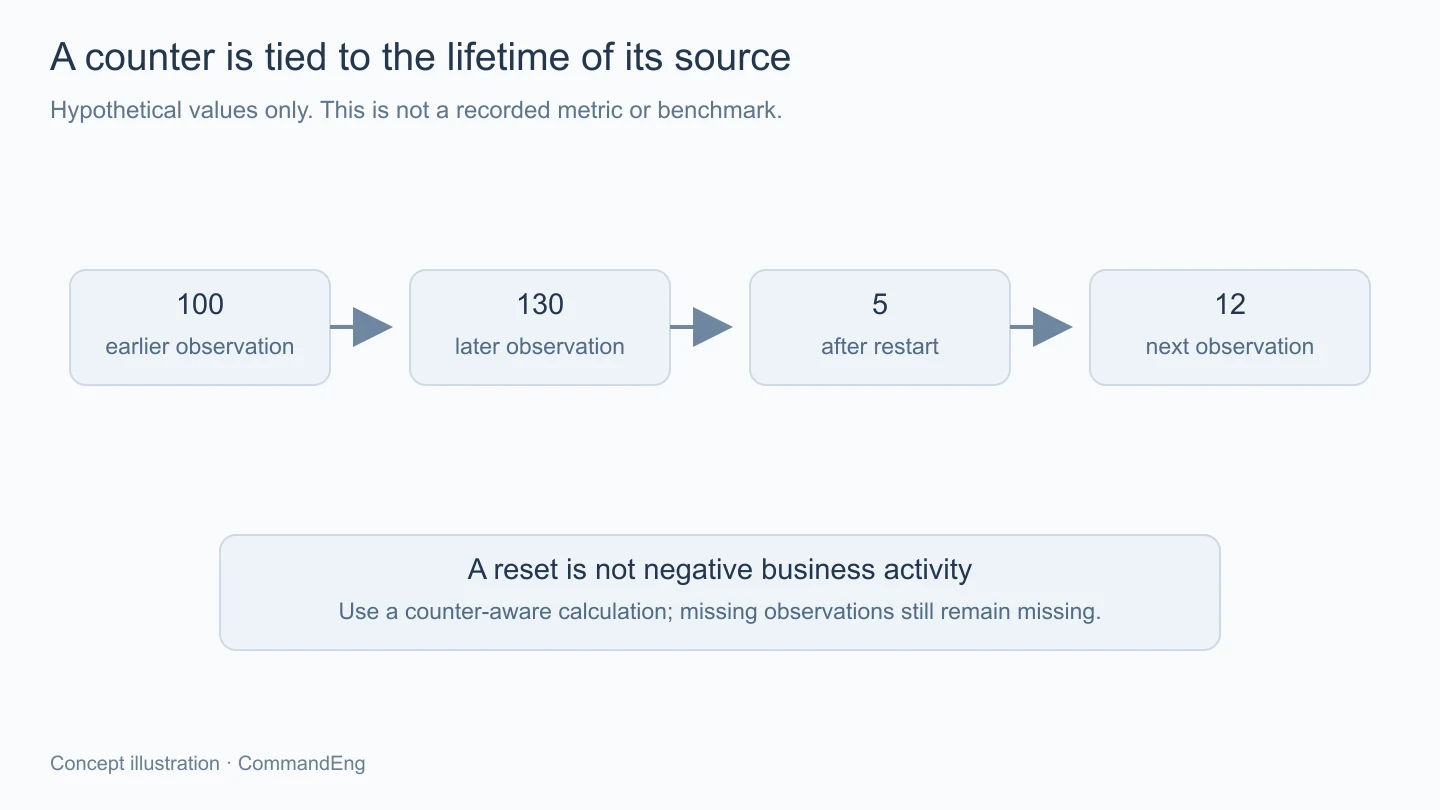
บริการที่รันมาหลายวันย่อมมีโอกาสสะสมค่ามากกว่าตัวที่เพิ่งเริ่ม แม้ตัวที่เริ่มใหม่กำลังรับงานถี่กว่าอยู่ก็ตาม และเมื่อมีการ deploy ค่าเดิมก็อาจกลับไปเริ่มนับใหม่จนเส้นกราฟลดฮวบ ถ้าเราอ่านทุกการลดลงเป็นการหายไปของงาน ก็จะตีความข้อมูลผิดตั้งแต่ต้น
ก่อนแก้กราฟจึงควรรู้ว่าค่านั้นเป็นตัวนับสะสมหรือค่าที่สะท้อนสภาพปัจจุบัน แล้วค่อยเลือกวิธีคำนวณตามความหมายครับ
Counter ใช้กับสิ่งที่เพิ่มสะสม เช่น จำนวน request ที่รับแล้ว หรืองานที่เสร็จแล้ว โดยอาจเริ่มใหม่เมื่อ process เริ่มรอบใหม่ ส่วนจำนวนงานที่กำลังรันมีทั้งเพิ่มเมื่อรับงานและลดเมื่องานจบ จึงเหมาะกับ gauge ซึ่งขึ้นลงได้ตามสภาพในขณะนั้น
ความต่างนี้สำคัญกว่าชื่อที่แสดงใน dashboard เพราะฟังก์ชันที่ใช้กับ counter อาศัยความคาดหมายว่าค่าจะเพิ่มตามลำดับ หากนำจำนวนงานค้างที่ลดลงตามปกติมาคำนวณด้วยวิธีที่ตีความการลดเป็น reset เราก็จะได้ตัวเลขที่ไม่ได้อธิบายสิ่งที่อยากวัดแล้ว
ควรเริ่มตรวจจากจุดสร้าง metric และเอกสารของ exporter ว่านับตอนใด เช่น นับเมื่อเริ่มรับคำขอหรือเมื่อตอบเสร็จ ความหมายสองแบบนี้อาจให้ภาพต่างกันเมื่อมีงานค้างมาก ถึงจะใช้ counter ถูกชนิดเหมือนกันก็ตาม
ใน Prometheus ฟังก์ชัน rate ใช้คำนวณอัตราเพิ่มเฉลี่ยต่อวินาทีของ counter ภายในช่วงที่ระบุ ตัวอย่างต่อไปนี้เป็นชื่อ metric สมมติสำหรับอธิบายรูปแบบ ไม่ใช่ผลจากระบบ CommandEng
rate(app_requests_total{service="example-api"}[5m])
ความหมายคือดูอัตราของแต่ละ series จากข้อมูลในช่วงห้านาทีนั้น ไม่ได้บอกว่าทุกวินาทีมีคำขอเท่ากัน และห้านาทีก็เป็นเพียงช่วงตัวอย่าง ไม่ใช่ค่าที่เหมาะกับ scrape interval หรือจังหวะงานของทุกระบบเสมอไป
ช่วงสั้นช่วยให้เห็นการเปลี่ยนเร็วขึ้น แต่ก็ไวต่อความเบาบางของตัวอย่าง ส่วนช่วงยาวช่วยเฉลี่ยภาพให้เรียบขึ้นและอาจกลบการพุ่งสั้นๆ ไปด้วย จึงควรเขียนชื่อกราฟหรือคำอธิบายให้รู้ว่าเป็นอัตราเฉลี่ยจากช่วงไหน ไม่เรียกว่า request ตอนนี้โดยไม่มีขอบเขตเวลา
อีกจุดที่ชวนสับสนคือช่วงที่ dashboard แสดงกับช่วงคำนวณใน query เราอาจเปิดดูประวัติทั้งวัน แต่แต่ละจุดบนเส้นยังเป็น rate จากหน้าต่างห้านาทีตามคำสั่ง การขยายหน้าจอให้เห็นทั้งวันจึงไม่ได้เปลี่ยนแต่ละจุดให้เป็นค่าเฉลี่ยรายวันเอง
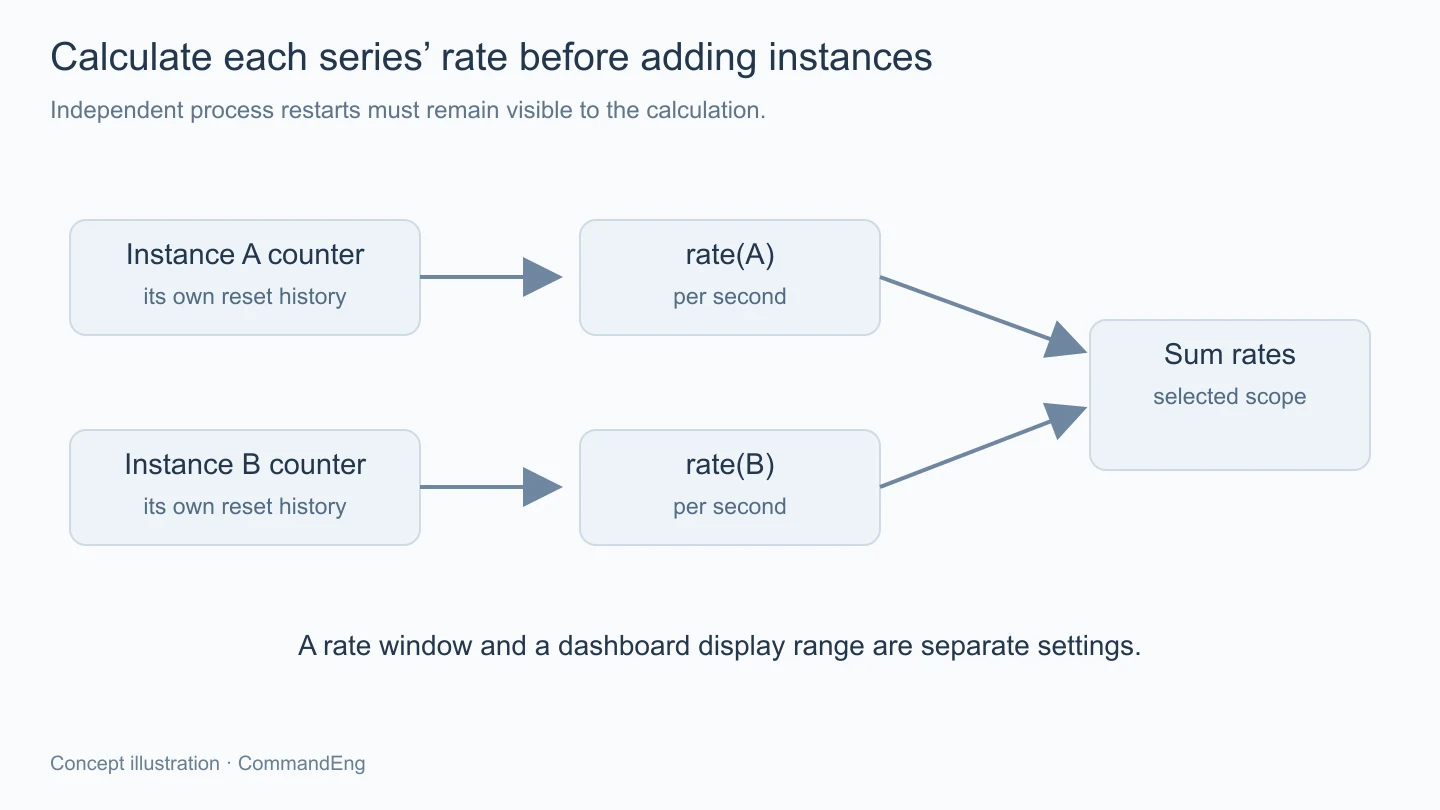
เมื่อบริการมีหลาย instance แต่ละตัวมีอายุ process และจังหวะ restart ของตัวเอง การคำนวณ rate ควรเกิดกับ counter ของแต่ละ series ก่อน แล้วจึงนำอัตราที่ได้มารวมตามขอบเขตที่ต้องการ
sum by (service) (
  rate(app_requests_total{service="example-api"}[5m])
)
หากรีบรวมค่าดิบก่อน การลดลงจาก instance ที่เพิ่งเริ่มใหม่อาจถูกค่าที่เพิ่มจากอีก instance บดบัง จนขั้นคำนวณถัดไปมองไม่เห็น reset ตาม series เดิม เอกสาร Prometheus จึงระบุให้ทำ rate ก่อน aggregation สำหรับงานลักษณะนี้
ส่วน label ที่เหลือหลัง sum ต้องตรงกับสิ่งที่อยากอ่าน ถ้ารวมทุก environment เข้าด้วยกัน ก็อาจเห็นอัตราของงาน dev ปนกับ prod ขณะที่ชื่อกราฟยังทำให้คนเข้าใจว่าเป็นผู้ใช้จริง การจัดขอบเขต series จึงเป็นส่วนหนึ่งของความถูกต้อง ไม่ใช่เพียงการตกแต่ง legend
ควรตรวจหน่วยที่ตั้งใน panel ให้ตรงด้วย เพราะ rate คืนอัตราต่อวินาที การเปลี่ยนป้ายเป็นต่อนาทีโดยไม่คำนวณให้สัมพันธ์กัน จะทำให้ชื่อกับตัวเลขอธิบายคนละค่า แม้ query ภายในจะถูกต้องแล้วก็ตาม
หากต้องการดูจำนวนที่เพิ่มในช่วงเวลา Prometheus มี increase ซึ่งปรับการ reset และประมาณค่าให้ครอบคลุมขอบช่วงตามการคำนวณ จึงเป็นไปได้ที่จะเห็นค่าทศนิยม แม้สิ่งที่นับจริงเป็นเหตุการณ์ทีละครั้ง
นั่นไม่ได้แปลว่าระบบรับครึ่ง request แต่เป็นผลจากวิธีประมาณบนตัวอย่างที่เก็บเป็นรอบ การปัดตัวเลขให้ดูง่ายทำได้ในงานแสดงผลตามบริบท แต่ควรเข้าใจก่อนว่าค่านั้นไม่ได้กลายเป็นบันทึกเหตุการณ์รายรายการที่ครบถ้วนเพียงเพราะแสดงเป็นจำนวนเต็ม
ถ้างานต้องการยอดที่ตรวจสอบย้อนหลังอย่างเคร่งครัด เช่น ตรวจรายการที่มีผลทางธุรกิจ ก็ควรอาศัยแหล่งข้อมูลที่ออกแบบเก็บเหตุการณ์หรือรายการนั้นโดยตรง ส่วน metrics ใช้ดูแนวโน้มและสภาพบริการตามขอบเขตที่เก็บได้ ไม่ใช้แทนบัญชีรายการโดยไม่มีหลักฐานความครบถ้วน
ช่วงที่เก็บ metrics ไม่ได้ อาจเกิดจาก target หยุด เครือข่ายขาด หรือเส้นทางเก็บข้อมูลมีปัญหา การแสดงช่องว่างเป็นศูนย์ทันทีจะทำให้ความหมายเปลี่ยนจากไม่รู้ค่าเป็นยืนยันว่าไม่มีงาน ทั้งที่บริการอาจยังรับคำขออยู่บางส่วน
การปรับ reset ของ rate ช่วยรับมือค่าที่สังเกตเห็นว่าลดลง แต่ไม่ได้สร้างประวัติที่ไม่เคยถูกเก็บกลับมาได้ครบ เช่น งานช่วงสั้นที่เกิดและหายไประหว่างรอบเก็บพร้อม process ที่หยุดไปแล้ว จึงควรตรวจสุขภาพของการ scrape และความต่อเนื่องของ series ร่วมกับกราฟงาน
ก่อนนำ query ไปใช้แจ้งเตือน ลองตรวจในชุดทดลองทั้งตอน counter เพิ่มตามปกติ ตอน process เริ่มใหม่ และตอนข้อมูลขาด แล้วดูว่ากราฟกับข้อความยังสื่อถูกหรือไม่ บทนี้ยังไม่ได้ดึง metrics ของระบบจริง จึงไม่มีอัตรา request หรือช่วง reset ที่อ้างว่าเกิดขึ้นแล้ว
การอ่าน counter ให้ตรงเริ่มจากรู้ว่านับอะไรและเริ่มนับเมื่อใด จากนั้นเลือกช่วงคำนวณ ทำ rate ต่อ series ก่อนรวม และรักษาความต่างระหว่างข้อมูลขาดกับค่าศูนย์ เมื่อดูขอบเขตเหล่านี้ร่วมกัน เส้นที่ลดหลัง deploy ก็จะไม่ถูกตีความว่าเป็นงานหาย และตัวเลขความถี่จะอธิบายภาระได้ตรงกว่าค่าสะสมเพียงค่าเดียว