เพิ่ม label ใน Prometheus แล้วข้อมูลโตเร็วแค่ไหน
ตอนเพิ่ม metric ให้ระบบ เรามักอยากเก็บรายละเอียดไว้ให้กรองได้ทุกมุม เพราะไม่รู้ว่าภายหลังจะอยากถามอะไรเพิ่ม จึงเริ่มจากชื่อบริการ แล้วตามด้วยเส้นทาง ผู้ใช้ รหัสงาน หรือข้อความผิดพลาดที่เกิดขึ้น
แต่ label ใน Prometheus ไม่ได้เป็นเพียงช่องข้อความที่แนบเพิ่มโดยไม่มีผลครับ ชุดค่าของ label ที่ต่างกันทำให้เกิด time series ต่างกันตาม data model ดังนั้นรายละเอียดที่ดูเป็นข้อมูลอีกช่องหนึ่งอาจขยายจำนวนชุดที่ระบบต้องดูแลไปมากกว่าที่คาด
ก่อนเพิ่ม label ลองถามว่ามันช่วยตอบคำถามรวมแบบใด และค่าที่เป็นไปได้มีขอบเขตหรือไม่ จะช่วยให้เลือกได้ว่าสิ่งใดควรเป็น metric ส่วนรายละเอียดใดควรเก็บใน log หรือแหล่งข้อมูลอีกแบบ
ชื่อ metric เดียวอาจมีหลายชุดข้อมูล
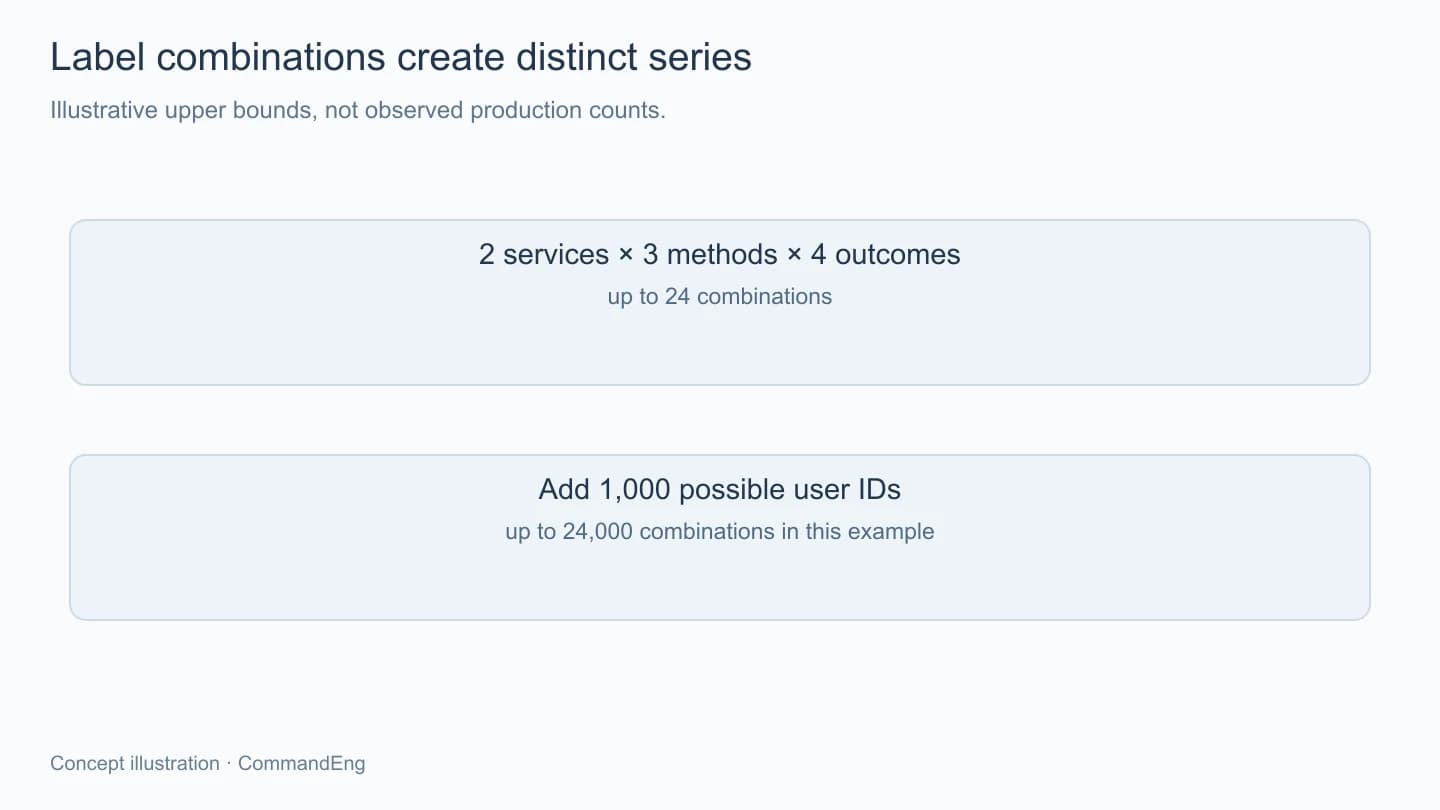
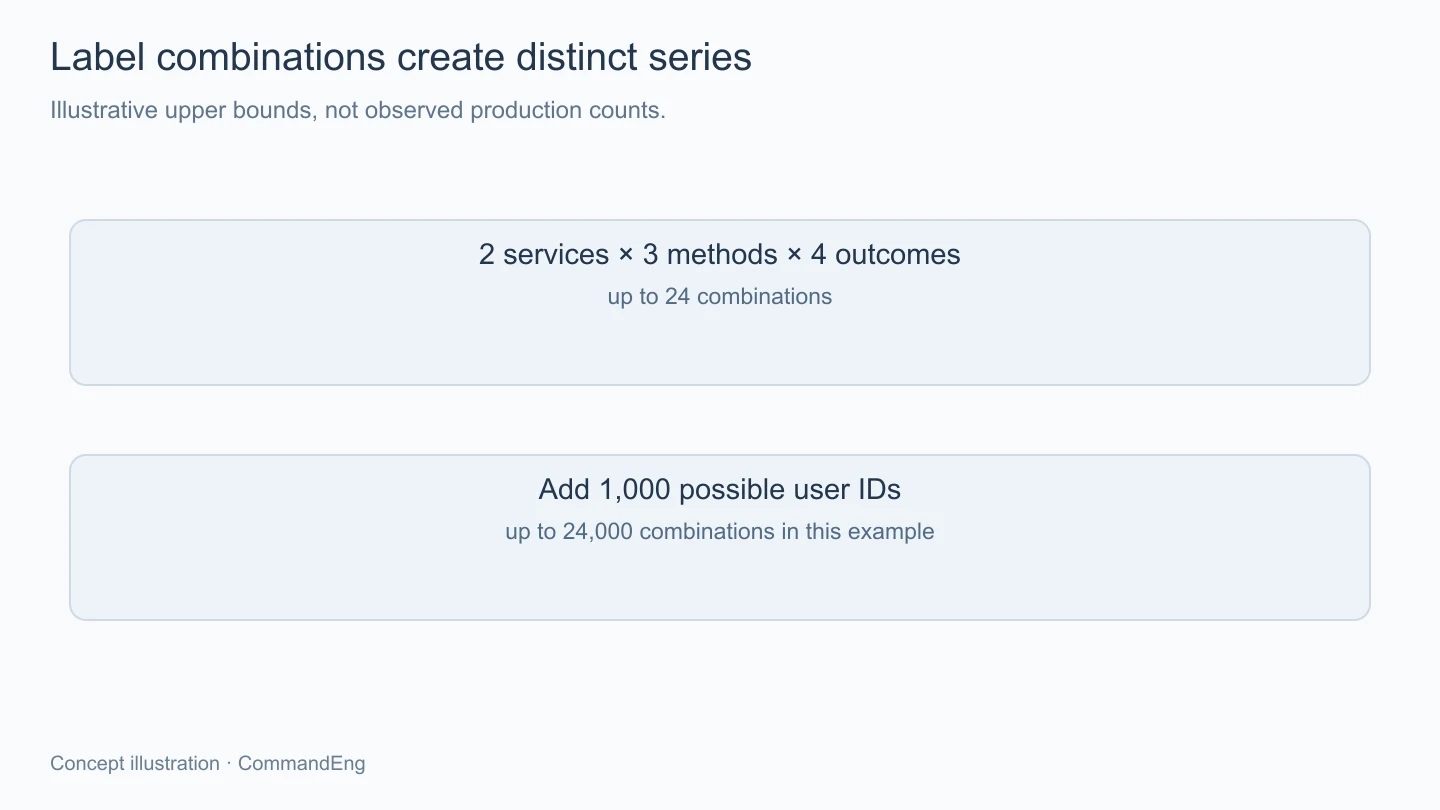
สมมติเรานับคำขอแยกตามบริการ วิธี HTTP และกลุ่มผลลัพธ์ หากมีบริการสองตัว วิธีสามแบบ และผลลัพธ์สี่กลุ่ม จำนวนชุดที่เป็นไปได้จากสามแกนนี้คือ 24 ชุดในตัวอย่างเชิงคณิตศาสตร์ แต่ของจริงจะมีเท่าไรต้องดูชุดค่าที่เกิดขึ้นจริงด้วย
ถ้าเพิ่มรหัสผู้ใช้ที่อาจมีได้อีกหนึ่งพันค่า เพดานชุดผสมในตัวอย่างก็ขยับไปเป็น 24,000 ชุดทันที ตัวเลขนี้ไม่ได้เป็นผลวัดของระบบใด และยังไม่รวมรายละเอียดชนิด metric แต่ช่วยให้เห็นว่าต้นทุนไม่ได้เพิ่มเป็นเพียงหนึ่งคอลัมน์เหมือนภาพที่เราคุ้นจากตารางทั่วไป
metric บางชนิดยังมีหลาย series ต่อชุด label ตามโครงสร้างของมัน เช่น classic histogram ที่มีส่วน bucket กับข้อมูลประกอบ จึงควรประเมินจากรูปแบบที่ส่งออกจริง ไม่คำนวณเฉพาะจำนวนชื่อ metric ที่เห็นในโค้ด
จำนวนชุดที่เปลี่ยนตามเวลาเป็นอีกเรื่องที่ต้องดู เพราะแม้บางช่วงมีค่าพร้อมกันไม่มาก แต่การเกิดตัวตนใหม่ต่อเนื่องก็ทำให้มีประวัติ series ตามมา การดูภาพนิ่งช่วงสั้นจึงยังไม่ตอบภาระทั้งหมดของ retention ที่ตั้งไว้
ข้อมูลที่เปลี่ยนตามคำขอมักไม่เหมาะเป็น label หลัก
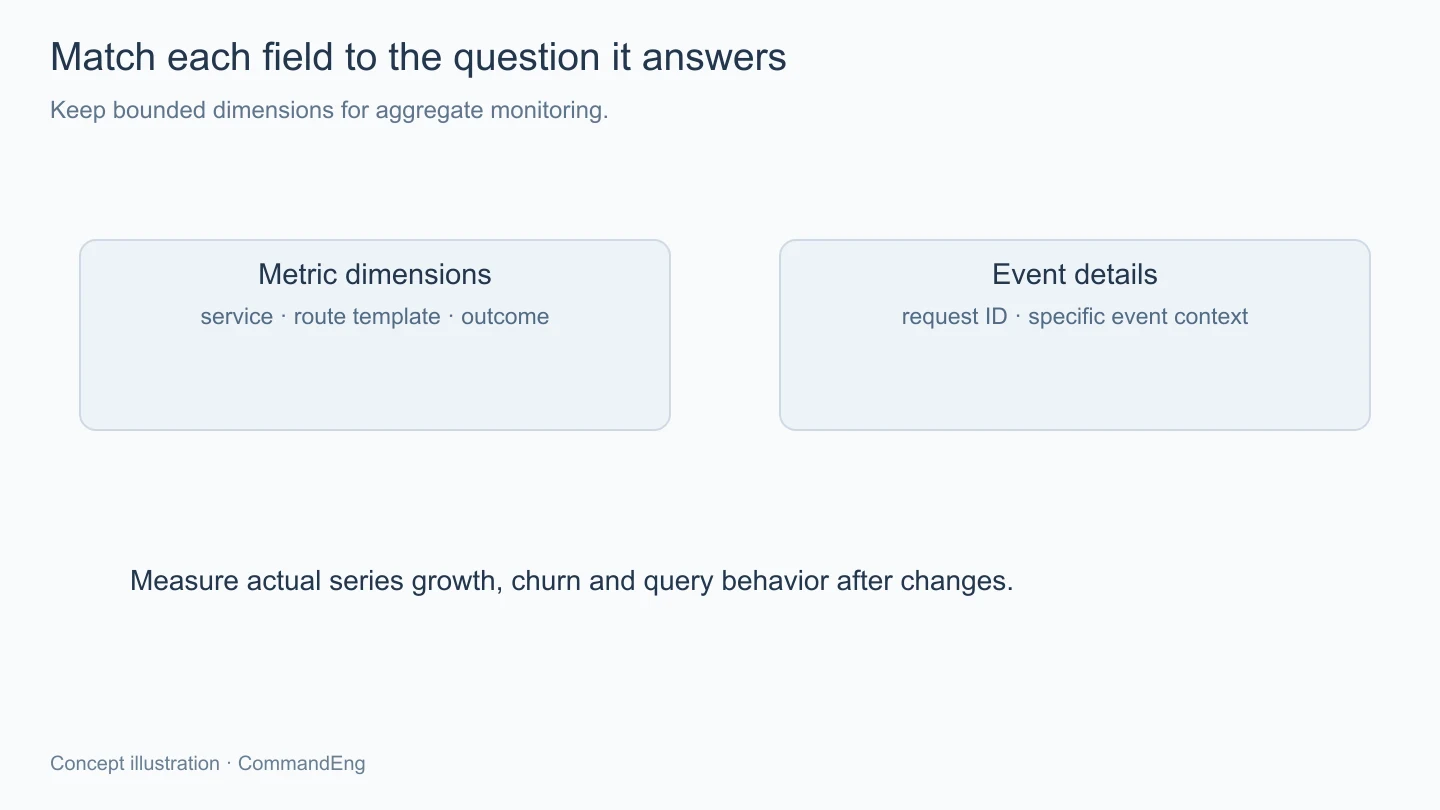
รหัสคำขอ รหัสธุรกรรม หรือข้อความ error ที่ใส่รายละเอียดอิสระมีโอกาสสร้างค่าหลากหลายมาก หากติดเป็น label กับทุก metric ก็อาจทำให้ระบบรวมข้อมูลต้องดูแลรายละเอียดระดับเหตุการณ์ที่มันไม่ได้จำเป็นต่อคำถามรวม
เส้นทาง URL ก็เช่นกัน /users/123 กับ /users/456 อาจเป็นงานประเภทเดียวกันในแอป ถ้าคำถามคือเส้นทางอ่านผู้ใช้ช้าหรือไม่ การเก็บ route template ที่แอปรู้จักอย่าง /users/:id อาจตอบได้ตรงกว่าเก็บ URL จริงทุกค่า ทั้งนี้ต้องเลือกจากข้อมูลการ route ที่เชื่อถือได้ ไม่แทนตัวเลขสุ่มจนชื่อเพี้ยน
ส่วนตัวระบุอย่าง pod หรือ instance ยังมีประโยชน์สำหรับบางการตรวจ ไม่ใช่ว่าค่าหลายแบบต้องถูกตัดทั้งหมด แต่ควรรู้ว่ามันมีหน้าที่อะไร เปลี่ยนบ่อยเพียงใด และเก็บไว้ในขอบเขตที่ระบบรับได้หรือไม่ แทนการใช้กติกาห้ามทุก label ที่ไม่คงที่เหมือนกันหมด
ข้อมูลส่วนบุคคลหรือความลับก็ไม่ควรถูกพาเข้ามาเพียงเพื่อให้กรองสะดวก เพราะ metric อาจถูกส่งต่อหลายระบบและมี retention ของมันเอง การเลือก label จึงเป็นการเลือกขอบเขตข้อมูลที่ทีมจะต้องดูแลต่อด้วย
คำถามรวมใช้กลุ่มที่นิยามได้
ถ้าอยากรู้สัดส่วนคำขอล้มเหลว เราอาจใช้กลุ่มผลลัพธ์ที่กำหนดไว้ ไม่ต้องมีข้อความผิดพลาดเต็มเป็นค่า label ทุกครั้ง ส่วนถ้าอยากตามว่าคำขอใดล้มเหลวเพราะข้อมูลอะไร ก็เก็บรายละเอียดที่เหมาะสมใน log แล้วมีรหัสอ้างอิงสำหรับเชื่อมต่อภายหลัง
ก่อน instrument ลองเขียน query ที่อยากใช้จริงหนึ่งสองแบบ เช่น ดูอัตราข้อผิดพลาดตาม service หรือระยะตอบสนองตาม route ถ้าเพิ่ม label แล้วไม่มีคำถามใดต้องใช้ ก็ควรถามว่าจำเป็นต้องสร้าง series แยกตั้งแต่ต้นหรือไม่
ชื่อ metric กับหน่วยก็ควรสื่อความหมายตามแนวทางที่ทีมใช้ เช่น แยกเวลาเป็นหน่วยเดียวกันและระบุชนิดตัวนับให้ชัด เพราะ label ที่คุมได้แต่คนเขียน query ตีความหน่วยผิด ก็ยังทำให้ Dashboard ตอบคำถามผิดได้อยู่ดี
การเลือกกลุ่มควรมีทางจัดการค่าที่ไม่รู้จักด้วย ไม่ให้โค้ดเส้นทางผิดพลาดสร้าง label จากข้อความอิสระแทนรายการที่กำหนดไว้จนขอบเขตหลุดเฉพาะวันที่ระบบมีปัญหา ซึ่งเป็นวันที่เราต้องพึ่ง monitoring มากที่สุดพอดี
ตรวจภาระจริงก่อนและหลังเพิ่มข้อมูล
หลังเพิ่ม metric ให้ดูจำนวน series ที่เกิด ขนาดการส่งออก ภาระ ingest และเวลาของ query ตามวิธีวัดที่ระบบมี โดยเก็บช่วงและขอบเขตให้เทียบกันได้ ไม่ใช้ผลจากเครื่องทดลองที่มีผู้ใช้หนึ่งคนแทนระบบที่มีความหลากหลายจริง
ควรตรวจกรณีที่สร้างค่าหลายแบบด้วย เช่น route ต่างๆ และผลลัพธ์ผิดพลาดตามที่งานรองรับ ไม่ทดสอบเฉพาะเส้นทางสำเร็จเพราะอาจไม่เห็น label ที่ถูกสร้างเฉพาะเวลาล้มเหลวหรือ reconnect
ผลด้านหน่วยความจำ พื้นที่ หรือค่าใช้จ่ายต้องวัดจากระบบและนโยบายที่ใช้จริง บทนี้จึงให้เพียงตัวอย่างจำนวนชุดผสม ไม่แปลงเป็นขนาด RAM หรือราคาต่อเดือนจากค่าทั่วไปที่ยังไม่ใช่ของงานเรา
เมื่อต้องลด label ให้ระวังความหมายที่รวมกัน
การตัด label ภายหลังอาจช่วยเปลี่ยนข้อมูลที่เข้าต่อจากนั้นได้ตามจุดที่ตั้งค่า แต่ต้องดูว่าชุดที่เคยแยกจะกลายเป็นชื่อเดียวกันหรือไม่ และควรรวมค่าด้วยวิธีใด ไม่ลบแกนออกแบบสุ่มแล้วถือว่าข้อมูลจะรวมถูกความหมายทั้งหมด
ข้อมูลที่ ingest ไปแล้วก็มีวงจรชีวิตตาม storage และ retention ของมัน การแก้ source วันนี้ไม่ได้แปลว่าภาระประวัติทั้งหมดหายทันที ควรแยกผลของข้อมูลใหม่กับสิ่งที่ยังอยู่ระหว่างรอหมดอายุในการติดตามผล
หากต้องเปลี่ยนชื่อหรือรูปแบบ metric ให้จดช่วงย้ายและปรับ query, Dashboard กับ alert ที่ใช้อยู่ด้วย เพื่อไม่ให้แก้ต้นทุนการเก็บแล้วสร้างช่องว่างการเฝ้าระวังโดยไม่มีใครรู้
สรุป
label ควรเกิดจากคำถามที่ metric ต้องตอบและมีขอบเขตค่าที่เข้าใจได้ เมื่อแยกรายละเอียดระดับเหตุการณ์ไปอยู่ในที่เหมาะสม ประเมินชุดผสม และตรวจภาระจริงหลังเพิ่ม เราจะกรองข้อมูลได้ตามงานโดยไม่ให้ความละเอียดที่ยังไม่มีคนใช้ขยายจำนวน series ไปเรื่อยๆ จน monitoring ดูแลยากกว่าระบบที่กำลังเฝ้าอยู่ครับ

