


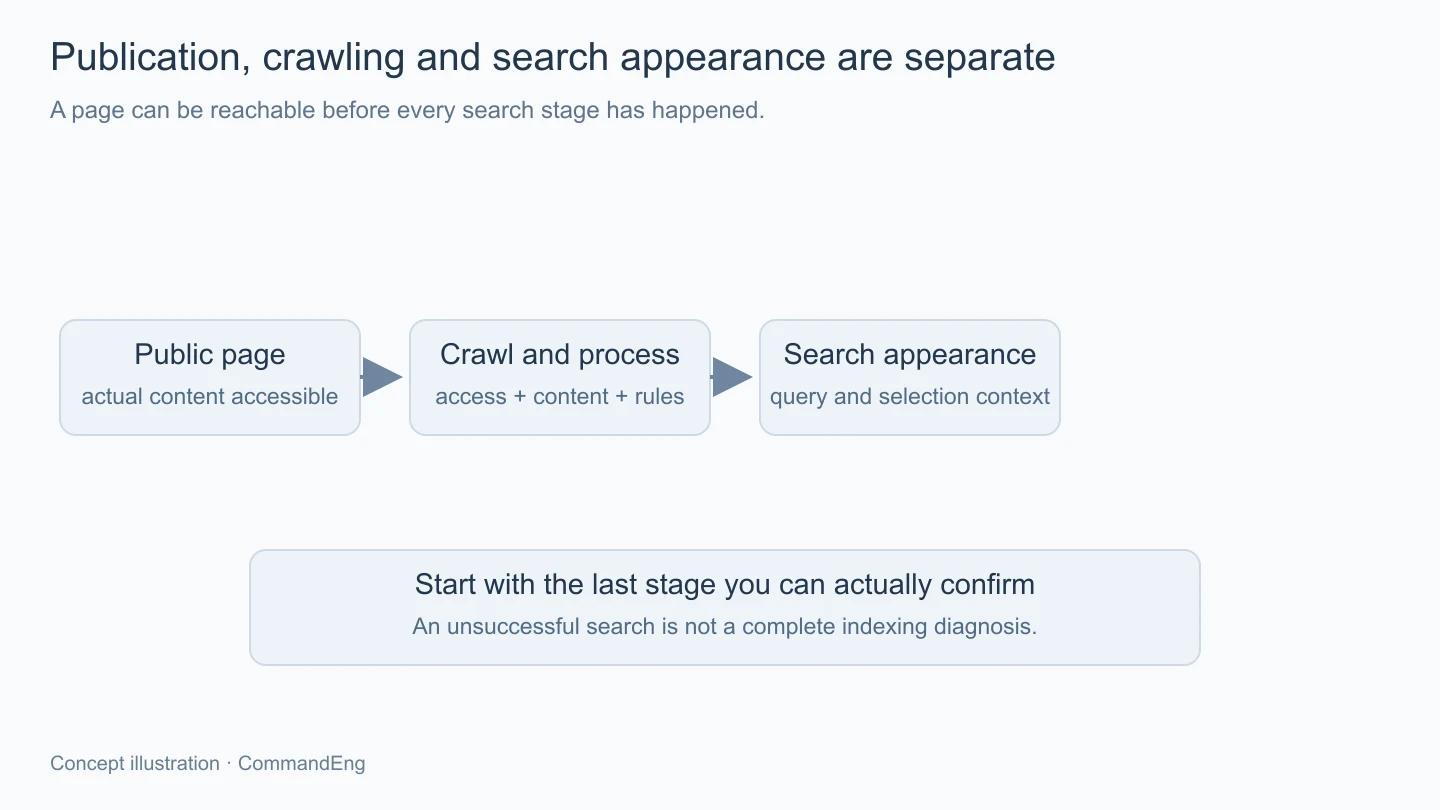
พอเขียนบทความเสร็จและเปิดจากลิงก์ได้ เราก็คงอยากลองค้นชื่อใน Google ดูว่าคนอื่นจะเจอหรือยัง แต่การที่เว็บเผยแพร่หน้าแล้วไม่ได้หมายความว่าระบบค้นหาจะนำหน้าเข้าดัชนีและแสดงกับคำค้นที่ลองในจังหวะเดียวกัน
ถ้าค้นไม่เจอ สิ่งแรกที่ควรทำจึงเป็นการแยกว่าหน้าติดอยู่ตรงไหนครับ ยังไม่ถูกพบ เข้าถึงไม่ได้ มีคำสั่งห้าม index หรือมีข้อมูลในดัชนีแล้วแต่ไม่ได้ถูกเลือกมาแสดงในคำค้นนั้น แต่ละกรณีมีงานแก้ต่างกัน
การไล่จากสถานะที่ตรวจได้จะช่วยให้เราไม่รีบเปลี่ยนชื่อหรือเติมคำค้น ทั้งที่อาจยังมีเงื่อนไขพื้นฐานซึ่งทำให้ระบบอ่านบทความไม่ถึงเลย
เริ่มจาก URL ที่ต้องการให้คนอ่านใช้จริง แล้วเปิดโดยไม่พึ่งบัญชีผู้ดูแล ตรวจว่ามีบทความครบ ไม่ได้เห็นเพียงหน้า preview หรือโครงที่ต้องเรียกข้อมูลด้วยสิทธิ์เฉพาะ เพราะสถานะตอนคนเขียนล็อกอินอาจต่างจากคนทั่วไป
ตรวจ HTTP response และปลายทางหลัง redirect ด้วย หน้าที่แสดงข้อความบทความแต่ตอบ error หรือหน้าหายที่ยังตอบสำเร็จล้วนต้องดูตามความหมายของมัน การเห็นหน้าตาบางอย่างจึงยังไม่พออธิบายว่าระบบค้นหาได้รับคำตอบใด
สำหรับเว็บที่มีบริการกลางหรือระบบป้องกันคำขอ ควรตรวจว่าเส้นทางสาธารณะไม่ได้พาไปหน้าท้าทายหรือบล็อกผู้เข้าที่ไม่ใช่ session เดิม การตรวจควรอาศัยผลจากเครื่องมือที่เกี่ยวข้อง ไม่เปลี่ยน User-Agent แล้วถือว่าเท่ากับ Googlebot จริงทุกเงื่อนไข
จด URL ที่ตรวจให้ตรง รวมถึง http กับ https ชื่อโฮสต์ และเส้นทางท้ายลิงก์ หากแต่ละที่เปิดได้แต่ทำหน้าที่ไม่เหมือนกัน ต้องรู้ก่อนว่ากำลังตั้งใจเผยแพร่ฉบับใด ไม่สลับลิงก์ไปมาแล้วรวมผลเป็นหน้าเดียว
บทความใหม่ควรมีลิงก์จากส่วนที่เกี่ยวข้อง เช่น รายการเนื้อหาหรือบทที่เล่าต่อกัน และมีลิงก์ที่ระบบตามได้จริง การมีไฟล์อยู่ที่ URL แต่ไม่มีทางเชื่อมจากส่วนอื่นทำให้การตรวจความสัมพันธ์และการพบหน้ามีงานเพิ่มโดยไม่จำเป็น
Sitemap ใช้แจ้งรายการ URL ที่เราต้องการให้รู้จักได้อีกทาง แต่ไม่ได้รับรองว่าทุกรายการจะถูกนำเข้าดัชนี ควรให้รายการนั้นตรงกับหน้าที่เผยแพร่และ URL หลัก แทนการใส่ทุกเส้นทางที่ระบบสร้างออกมาได้
เวลาตรวจลิงก์ให้ดูปลายทางกับข้อความประกอบ ไม่เพียงจำนวนลิงก์ ถ้ารายการบทความพาไป URL เก่าแล้วต่อ redirect หลายขั้น ก็ควรปรับให้สอดคล้องกับทางเข้าที่ต้องการใช้จริง เพื่อให้ทั้งคนอ่านและระบบค้นหาเจอสิ่งเดียวกันได้ตรงขึ้น
สำหรับงานเผยแพร่อัตโนมัติ ควรแยกสถานะบันทึกข้อมูลสำเร็จจากรายการสาธารณะอัปเดตแล้วด้วย บางระบบมีแคชที่ทำให้บทความเปิดตรงได้ก่อนจะปรากฏในหน้า index ของเว็บ จึงต้องตรวจทางเชื่อมที่คนจะใช้หลังเผยแพร่ด้วย
หน้าอาจมี robots meta หรือ X-Robots-Tag ที่กำหนด noindex อยู่ รวมถึงกฎ robots.txt ที่ขวางการอ่าน ต้องดูทั้ง response header กับเนื้อหาหน้าจริง เพราะคำสั่งอาจมาจากคนละชั้นของระบบ
หากคัดค่าจาก environment ทดลองมาขึ้น production โดยไม่ได้แยกเงื่อนไข ก็อาจมีคำสั่งที่ถูกต้องสำหรับ UAT แต่ไม่ตรงกับบทความสาธารณะ การแก้จึงควรอยู่ในจุดกำหนดนโยบาย ไม่ลบด้วยมือทีละหน้าจนบทใหม่กลับมาติดแบบเดิม
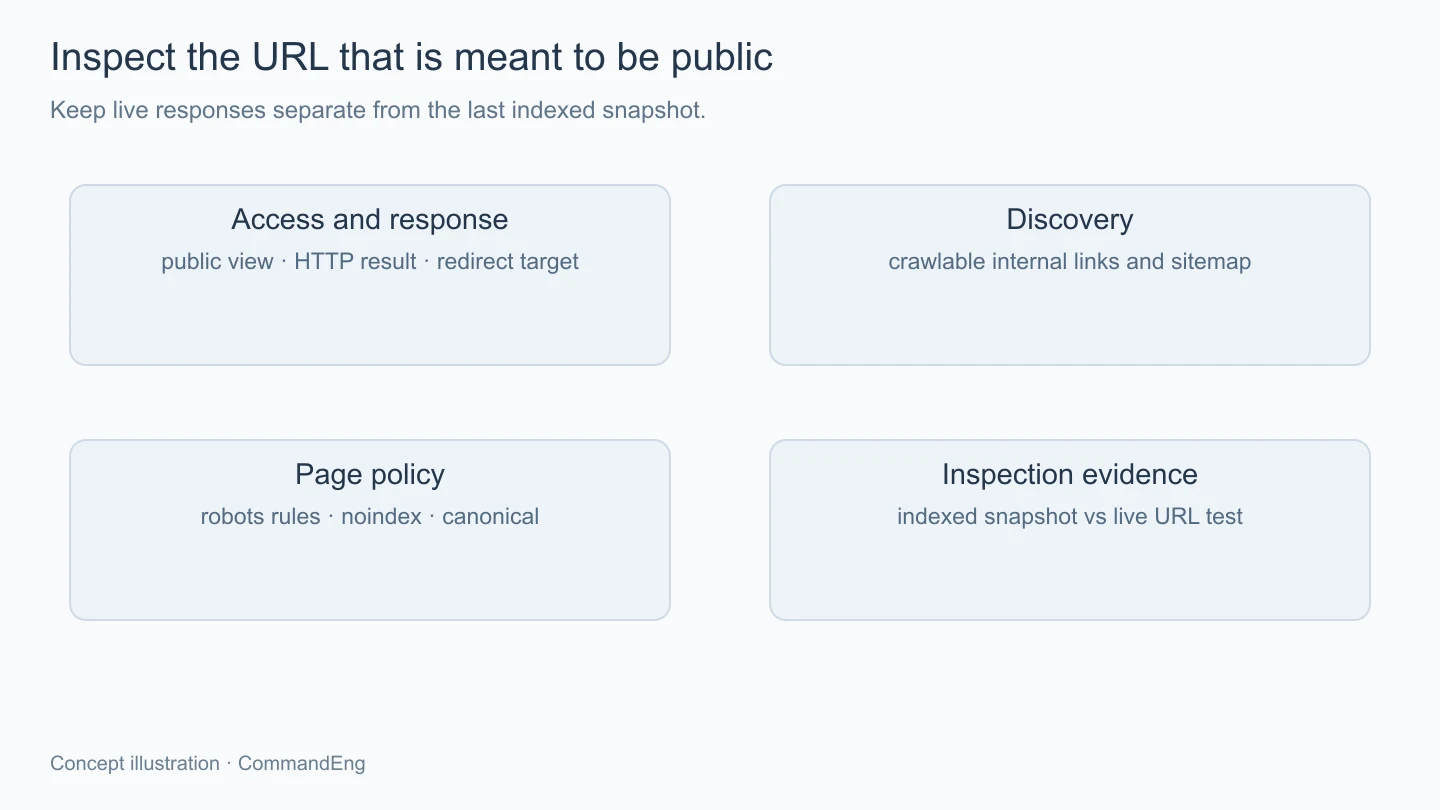
อีกส่วนที่ควรดูคือ canonical ว่าชี้ไป URL ใด หากหน้าใหม่บอกอีกหน้าหนึ่งเป็นตัวแทน ต้องตรวจว่าตั้งใจให้เนื้อหาสองหน้านั้นเป็นชุดซ้ำกันจริงหรือไม่ โดยเฉพาะ template ที่ใช้ค่าจากหน้าอื่นค้างไว้
อย่าแก้ทุกกฎพร้อมกันโดยไม่รู้หน้าที่ เช่น เปิดอ่านและเปิด index ทุกส่วนของเว็บเพียงเพื่อแก้บทความเดียว ควรระบุหน้าที่ต้องเป็นสาธารณะให้ชัด แล้วรักษาขอบเขตของหน้าทดลองหรือข้อมูลภายในไว้ตามความต้องการเดิม
ใน Search Console สามารถตรวจ URL ภายใต้ property ที่เกี่ยวข้องเพื่อดูข้อมูลฉบับที่ Google รู้จัก และทดสอบ URL ปัจจุบันได้ สองส่วนนี้ตอบต่างเวลากัน จึงควรอ่านวันที่กับขอบเขตของผลก่อนสรุป
Live test ช่วยดูว่าระบบเข้าถึงหน้าปัจจุบันได้อย่างไร แต่ไม่ได้รับรองว่าหน้าจะถูก index หรือได้ canonical ตามที่เราตั้ง ส่วนข้อมูลฉบับที่เก็บไว้ช่วยอธิบายสิ่งที่ระบบเคยประมวลผล ซึ่งอาจยังไม่รวมการแก้ล่าสุด
ถ้าผลบอกว่าไม่ถูก index ให้เริ่มจากเหตุที่รายงานและข้อมูลประกอบของ URL นั้น แทนการนำวิธีแก้จากสถานะอื่นมาใช้ทั้งหมด ควรดูว่าเป็นเรื่องการเข้าถึง การเลือกหน้าตัวแทน หรือการประเมินเนื้อหา ก่อนเลือกขั้นถัดไป
หลังแก้ข้อที่ยืนยันได้ อาจขอให้สำรวจ URL ตามความสามารถของเครื่องมือ แต่ไม่จำเป็นต้องส่งซ้ำตลอดเวลา และยังไม่ควรสัญญาว่าจะปรากฏภายในจำนวนชั่วโมงที่กำหนด เพราะการส่งคำขอไม่ได้ทำให้ทุกขั้นรับประกันตามกัน
การแสดงผลขึ้นกับคำค้นกับบริบทที่เกี่ยวข้อง จึงควรแยกคำถามว่าระบบมีหน้าอยู่หรือไม่ออกจากคนค้นเจอหน้าด้วยคำใดและอันดับใด การหาไม่เจอจากคำกว้างหนึ่งคำยังไม่ใช่หลักฐานยืนยันว่าไม่มีหน้าอยู่ในดัชนี
เมื่อพื้นฐานพร้อมแล้วค่อยกลับมาดูว่าบทความตอบคำถามชัดแค่ไหน ชื่อกับเนื้อหาสอดคล้องกันหรือไม่ และมีข้อมูลที่เป็นประโยชน์ต่อเรื่องนั้นจริงหรือยัง งานเนื้อหาเป็นอีกส่วนที่ต้องทำต่อ ไม่ใช่ขั้นที่ถูกแทนได้ด้วยการส่ง sitemap เพียงครั้งเดียว
เก็บวันเผยแพร่ วันแก้ และผลตรวจที่ได้ไว้ จะช่วยให้แยกสถานะเก่ากับใหม่ในรอบถัดไป บทนี้เสนอวิธีไล่ตรวจตามหน้าที่ของระบบ ไม่ได้อ้างสถานะ Search Console ของเว็บไซต์นี้หรือผลอันดับที่ไม่ได้ตรวจจริง
บทความที่เปิดได้แต่ยังค้นไม่เจอควรถูกตรวจเป็นลำดับ ตั้งแต่ทางเข้าสาธารณะ ลิงก์ที่พาไปถึง คำสั่งเกี่ยวกับ index และข้อมูลจาก URL Inspection เมื่อแยกการเผยแพร่ การอ่าน การทำดัชนี และการแสดงผลออกจากกัน เราจะเลือกแก้จากหลักฐานของหน้าจริง แล้วค่อยพัฒนาเนื้อหากับชื่อเรื่องโดยไม่ต้องเดาว่าทุกอาการแก้ด้วยการเพิ่มคำค้นครับ