


การนำเอกสารเข้า RAG มักมีขั้นแบ่งข้อความเป็นชิ้นเล็กๆ เพื่อให้ค้นส่วนที่เกี่ยวข้องแล้วส่งให้โมเดลอ่านได้พอดี ขั้นนี้ดูเหมือนเป็นงานเตรียมข้อมูลทั่วไป แต่ถ้าเลือกขอบเขตไม่สัมพันธ์กับเนื้อหา ชิ้นที่ค้นเจอก็อาจมีคำตอบเพียงครึ่งเดียว
อย่างประโยคที่บอกว่าให้ใช้ขั้นตอนสำรอง อาจอยู่ใต้หัวข้อเฉพาะรุ่นทดสอบ หากแยกมาโดยไม่มีหัวข้อนั้น คนหรือโมเดลที่เห็นเฉพาะประโยคก็อาจเข้าใจว่าใช้กับทุกระบบ ความผิดจึงเกิดได้แม้ค้นข้อความจากต้นฉบับจริง ไม่ได้มีการสร้างประโยคใหม่ขึ้นมาเลย
ก่อนปรับจำนวน token ของ chunk จึงควรมองว่าหน่วยความคิดในเอกสารอยู่ตรงไหน และต้องมีบริบทอะไรติดมาด้วยเพื่อให้ตีความได้ครบครับ
เอกสารมีโครงสร้างหลายแบบ ทั้งหัวข้อ ย่อหน้า รายการขั้นตอนและตาราง การตัดทุกช่วงด้วยจำนวนตัวอักษรเท่ากันอาจแบ่งคำอธิบายออกจากเงื่อนไขที่ตามมา หรือเอาท้ายเรื่องหนึ่งมาต่อกับต้นอีกเรื่องเพียงเพราะอยู่ในช่วงขนาดเดียวกัน
การใช้ขอบเขตตามโครงสร้างช่วยรักษาบริบทบางส่วนได้ แต่ต้องดูเนื้อหาที่ parser อ่านออกมาด้วย หากหัวข้อกับตารางหายตั้งแต่ขั้นแปลงไฟล์ การเลือก splitter ที่รู้จักหัวข้อก็อาจไม่มีโครงสร้างเหลือให้ใช้ตามที่คิด
จึงควรตรวจข้อความหลังแปลงก่อนแบ่ง ไม่กระโดดจากเห็นไฟล์ PDF เปิดได้ไปสรุปว่า chunk ที่ได้รักษาลำดับและความสัมพันธ์เหมือนหน้าเอกสารแล้ว โดยเฉพาะหน้าที่มีหลายคอลัมน์ ตารางหรือหมายเหตุแยกอยู่ด้านล่าง
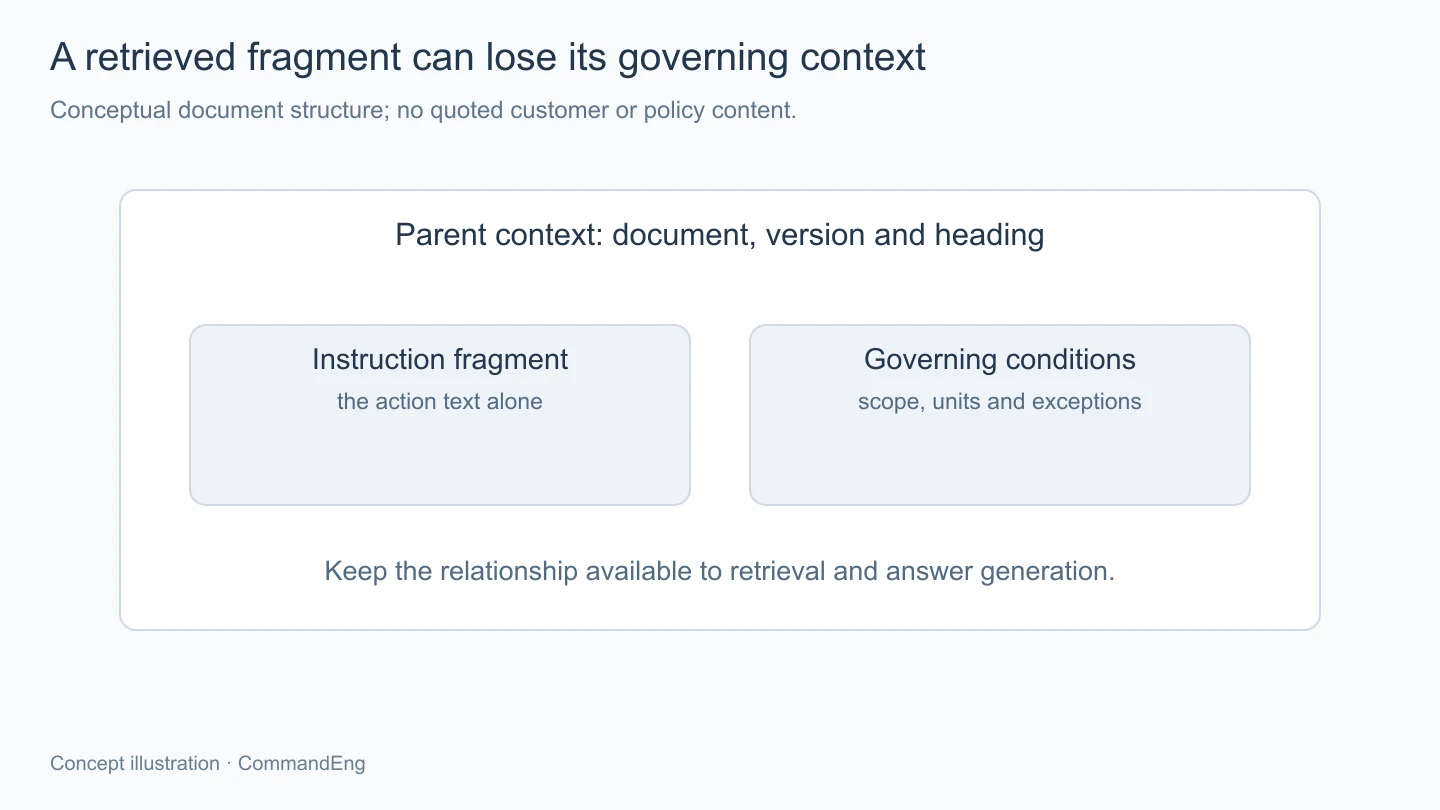
หาก chunk มีตัวเลขแต่ไม่มีหน่วย หรือมีคำสั่งแต่ไม่มีขอบเขตผู้ใช้ คำตอบที่สร้างต่อก็อาจดูสมบูรณ์ทั้งที่ผู้อ่านนำไปใช้ผิดเงื่อนไขได้ ควรระบุว่าข้อมูลประเภทใดต้องอยู่ร่วมกันก่อนเลือกวิธีตัด
สำหรับตาราง ชื่อคอลัมน์กับแถวที่เกี่ยวข้องมีผลต่อความหมายมาก การได้ค่าจากแถวหนึ่งโดยไม่รู้ว่าคอลัมน์เป็นค่าเริ่มต้นหรือค่าสูงสุดเป็นคนละอย่างกัน การรักษาโครงสร้างหรือเพิ่มคำอธิบายที่มาจากต้นฉบับจึงอาจจำเป็นกว่าการทำให้ทุก chunk สั้นเท่ากัน
ข้อยกเว้นก็ต้องตามไปด้วย เช่น ขั้นตอนหลักอาจใช้ทั่วไปแต่มีเงื่อนไขหยุดอยู่ในย่อหน้าถัดไป หากตัดสองส่วนแยกแล้วผลค้นมักได้เฉพาะขั้นตอนหลัก เราควรพิจารณาดึงบริบทที่เกี่ยวข้องเพิ่ม ไม่รอให้โมเดลอนุมานข้อยกเว้นที่ไม่เคยถูกส่งให้เห็น
แนวทาง contextual retrieval ที่ Anthropic อธิบายไว้พยายามเติมบริบทเฉพาะชิ้นเพื่อให้รู้ว่าข้อความนั้นอยู่ในเรื่องใด หลักคิดช่วยให้เห็นว่าชิ้นข้อมูลสั้นอาจต้องมีกรอบประกอบ แต่รายละเอียดที่เพิ่มยังต้องถูกตรวจและตามกลับไปยังเอกสารได้
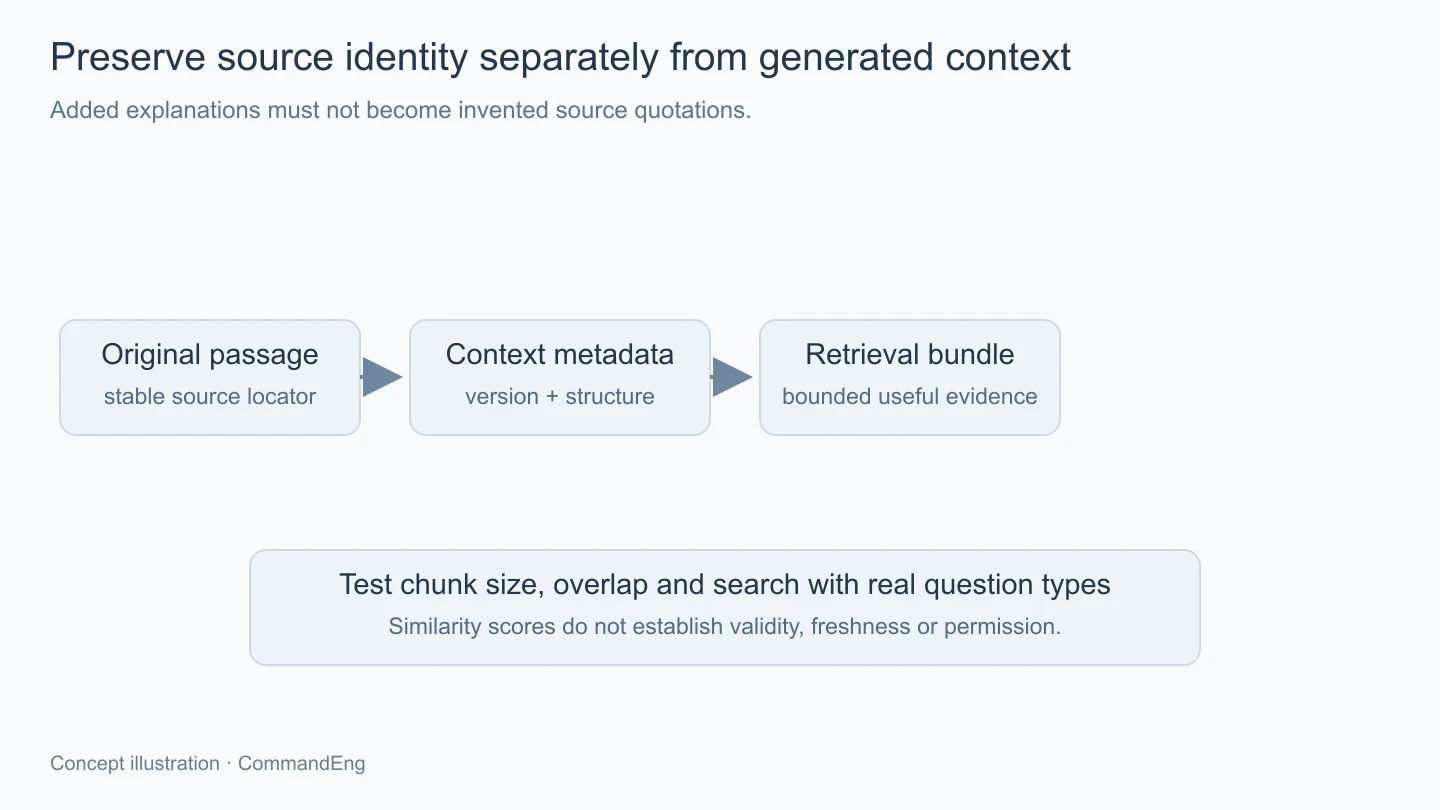
ถ้าให้โมเดลช่วยสร้างคำอธิบาย chunk ควรเก็บว่าข้อใดเป็นต้นฉบับและข้อใดเป็นคำอธิบายที่ระบบสร้าง ไม่ผสมจนคำที่เดาเพิ่มกลายเป็นคำอ้างจากเจ้าของเอกสาร ในงานที่ข้อมูลชัดอยู่ในหัวข้อหรือ metadata อาจนำข้อมูลที่ยืนยันได้มาใช้ตรงๆ ตามบริบท
การเก็บชื่อเอกสาร ลำดับหัวข้อ รุ่นและตำแหน่งอ้างอิงร่วมกับชิ้นข้อมูลช่วยให้ทั้งขั้นค้นและขั้นแสดงหลักฐานทำงานต่อได้ แต่ต้องเลือกว่า field ใดใช้กรอง ใช้ค้น หรือใช้แสดง ไม่ส่งทุกอย่างเข้า prompt เพียงเพราะมีข้อมูลอยู่
Chunk เล็กช่วยแยกเรื่องเฉพาะได้ แต่เสี่ยงขาดบริบท ส่วน chunk ใหญ่เก็บความต่อเนื่องมากขึ้นแต่พาเนื้อหาที่ไม่เกี่ยวเข้าไปด้วย เมื่อคำถามต้องการเรื่องสั้นๆ โมเดลก็ยังต้องอ่านส่วนอื่นในพื้นที่ context ที่มีขอบเขต
Overlap ช่วยให้ข้อความใกล้ขอบติดไปกับชิ้นข้างเคียงได้บางส่วน แต่เพิ่มข้อมูลซ้ำในดัชนีและผลค้น จึงต้องระวังการได้หลายชิ้นที่เล่าเนื้อหาเดียวกันจนแย่งพื้นที่ของหลักฐานอีกส่วนที่จำเป็น การเพิ่ม overlap ไม่ได้แก้เอกสารที่ขาดบริบทตั้งแต่ต้นทุกชนิด
ค่าที่เหมาะจึงต้องมาจากเอกสาร ภาษาและคำถามที่ต้องรองรับ ไม่ใช้จำนวน token ของตัวอย่างต่างประเทศเป็นมาตรฐานตายตัว รวมถึงต้องรู้ว่าหน่วย token ขึ้นกับ tokenizer ที่เลือก ไม่เท่ากับจำนวนคำหรือจำนวนตัวอักษรในภาษาไทยโดยตรง
Embedding ช่วยจัดข้อความที่มีความหมายเกี่ยวข้องให้ค้นร่วมกันได้ตามโมเดล แต่รหัสรุ่น ชื่อ parameter หรือเลขอ้างอิงบางอย่างต้องการความตรงตัวด้วย การออกแบบการค้นอาจต้องพิจารณาข้อมูลที่ใช้จับคำร่วมกับความหมายตามลักษณะคำถาม
การค้นแบบผสมหรือ rerank เป็นทางเลือกที่ต้องตรวจด้วยชุดงานจริง ไม่ใช่ข้อรับรองว่าการใส่หลายขั้นจะดีขึ้นเสมอไป ควรเริ่มจากดูว่าคำถามที่พลาดเกิดเพราะหา chunk ไม่เจอ หรือเจอแล้วแต่ตัดข้อมูลประกอบที่ต้องใช้หายไป
Metadata เรื่องรุ่น สิทธิ์และช่วงมีผลก็ต้องกรองตามกติกาต่างหาก คะแนนใกล้ไม่ได้ยืนยันว่าข้อความนั้นเป็นฉบับที่อนุญาตหรือยังมีผลอยู่ การเพิ่มคะแนนให้ผลค้นจึงไม่ควรข้ามเงื่อนไขข้อมูลเหล่านี้
พื้นที่ context ยังต้องใช้กับคำถาม คำสั่งและข้อมูลส่วนอื่นที่ระบบส่งมาด้วย การกำหนดจำนวน chunk จึงควรดูสิ่งที่เหลือให้หลักฐานจริง ไม่ใช้ขนาดหน้าต่างของโมเดลทั้งก้อนเป็นงบเอกสารแล้วค่อยตัดส่วนท้ายทิ้งโดยไม่รู้ว่าหลักฐานจำเป็นหลุดไปหรือไม่
ชุดตรวจควรมีคำถามที่คำตอบอยู่ในย่อหน้าเดียว อยู่ในตาราง และต้องใช้หัวข้อแม่กับข้อยกเว้นร่วมกัน แล้วดูว่าผลค้นนำส่วนที่จำเป็นมาให้ครบหรือไม่ จากนั้นค่อยดูว่าโมเดลใช้ส่วนเหล่านั้นถูกความหมายหรือเปล่า
เมื่อเปลี่ยนวิธีแบ่ง ควรเก็บรุ่นของ splitter และตัวอ้างอิงเอกสารไว้เพื่อย้อนเปรียบเทียบ พร้อมตรวจว่าลิงก์หรือข้อความอ้างยังชี้ถึงส่วนเดิมได้ ไม่ตัดสินจากคำตอบที่ไหลลื่นขึ้นเพียงสองสามคำถาม แล้วรายงานว่าชุดใหม่ดีขึ้นทั้งระบบโดยไม่มีหลักฐานที่ครอบคลุม
Chunk ที่นำไปใช้ต่อได้ต้องรักษาความหมายของต้นฉบับ ทั้งหัวข้อ รุ่น หน่วยและข้อยกเว้น เมื่อแยกข้อมูลอ้างอิงออกจากบริบทที่ระบบเติม และเลือกขนาดกับการค้นจากคำถามที่ตรวจได้ เราจะรู้ว่าปัญหาอยู่ที่การแบ่ง การค้นหรือการตอบ พร้อมรักษาทางกลับไปยังข้อความต้นทางให้เจ้าของข้อมูลตรวจเองได้