


ระบบตอบคำถามจากเอกสารมักเริ่มจากนำไฟล์เข้าฐานค้น แล้วลองถามว่าหาข้อมูลที่อยู่ในไฟล์ได้หรือไม่ พอตอบได้ก็เหมือนว่าทางเชื่อมระหว่างความรู้กับโมเดลพร้อมแล้ว แต่เอกสารของงานจริงไม่ได้หยุดอยู่ที่ฉบับแรก มีทั้งแก้ข้อความ เปลี่ยนเงื่อนไขและเลิกใช้งานบางฉบับในภายหลัง
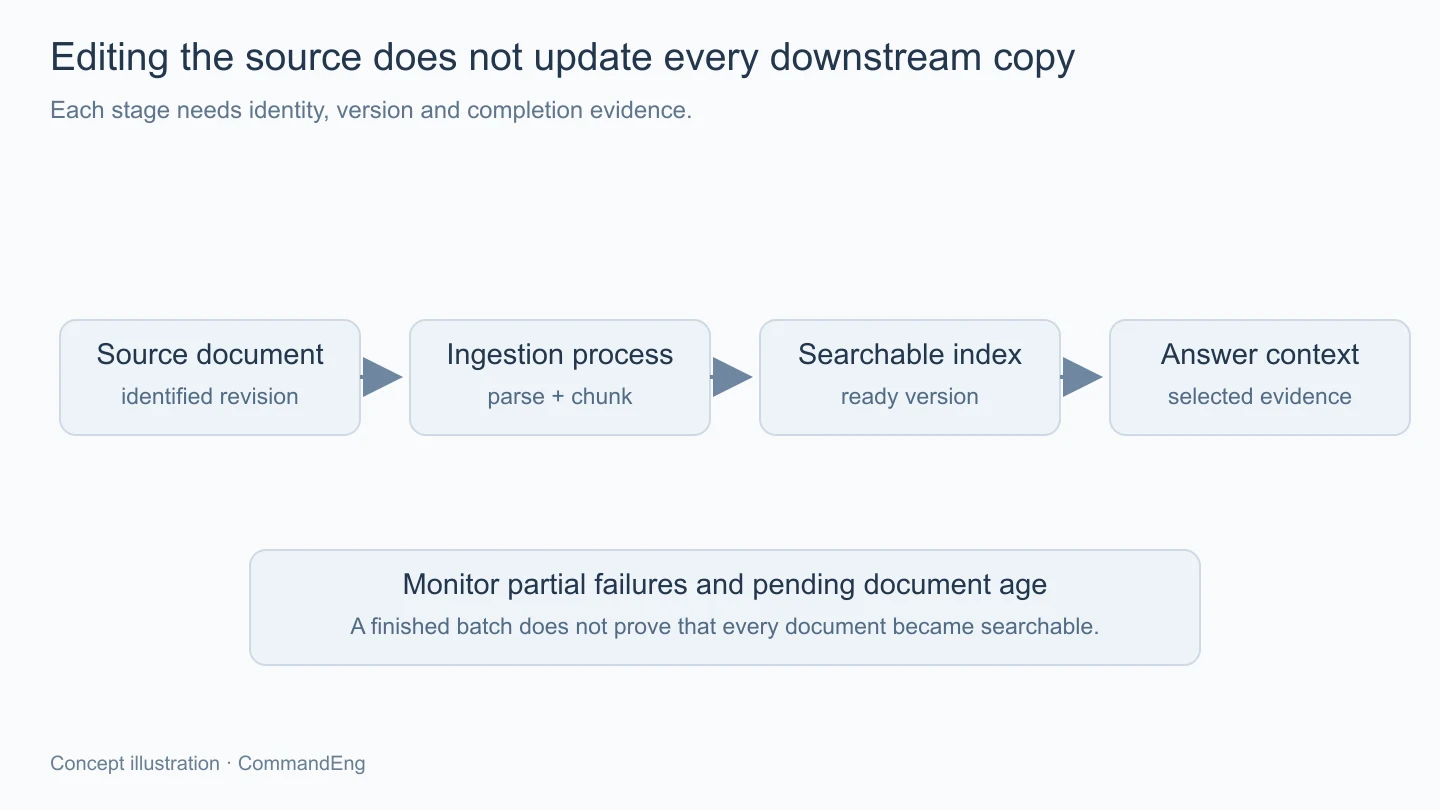
เมื่อคนแก้ต้นฉบับแล้วถามซ้ำ แต่ระบบยังตอบจากข้อมูลเก่า สาเหตุจึงอาจไม่ได้อยู่ที่โมเดลไม่ยอมอ่านคำสั่งล่าสุด เราต้องดูว่าการแก้ได้เดินทางผ่านขั้นนำเข้า ดัชนีค้นและ cache ไปถึงคำขอครั้งนั้นแล้วหรือยัง
RAG จึงมีวงจรดูแลข้อมูลเหมือนระบบอื่นครับ การเพิ่มเอกสารเข้าได้เป็นเพียงจุดเริ่ม ส่วนความสดต้องมีตัวตนของเอกสาร รุ่นและหลักฐานว่าขั้นต่างๆ ทำงานกับฉบับใดอยู่
ระหว่างเอกสารต้นทางกับคำตอบ อาจมีขั้นดึงไฟล์ แปลงเนื้อหา แบ่งชิ้นข้อมูล สร้าง embedding แล้วบันทึกเข้าที่ค้น แต่ละขั้นอาจทำคนละเวลา หากขั้นใดล้มเหลวหรือยังไม่เริ่ม การที่ไฟล์ต้นทางเปลี่ยนแล้วก็ไม่ได้ทำให้ปลายทางพร้อมตามทันที
ควรบันทึกสถานะที่อธิบายได้ เช่น พบฉบับใหม่แล้ว กำลังแปลง หรือนำเข้าพร้อมค้น ไม่ใช้คำว่าอัปเดตแล้วกับทุกขั้นเหมือนกัน และควรมีรหัสงานหรือหลักฐานที่ตามจากต้นฉบับมาถึงชุดที่ถูกเผยให้ค้นได้
เรื่องนี้ต่างจากการฝึกโมเดลใหม่ RAG สามารถส่งเนื้อหาที่ค้นได้เข้ามาประกอบคำขอขณะใช้งานตามการออกแบบ แต่ไม่ได้ทำให้ข้อมูลที่แก้ในแหล่งหนึ่งกลายเป็นความรู้ล่าสุดของทุกคำตอบเอง หากคำขอไม่ได้รับเนื้อหาฉบับใหม่ ก็ยังมีช่องให้ใช้ข้อมูลเดิมอยู่
ชื่อไฟล์อย่างเดียวอาจไม่พอ เพราะคนเปลี่ยนชื่อได้ และไฟล์คนละงานก็อาจใช้ชื่อเดียวกัน ควรมี document ID ที่คงความสัมพันธ์กับต้นฉบับ และข้อมูล version หรือ hash ตามสิ่งที่ต้องใช้ตัดสินความเปลี่ยนแปลง
เอกสาร LlamaIndex ยกกลไกที่ใช้ document ID กับ hash เพื่อรู้ว่าข้อมูลเดิมเปลี่ยนและควรถูกประมวลผลใหม่ ตัวอย่างนี้ช่วยชี้บทบาทของตัวตนกับเนื้อหา แต่ต้องตรวจการตั้งค่าจริงของ pipeline ไม่ถือว่าการใช้ library นั้นเปิดการจัดการทุกขั้นให้อัตโนมัติเสมอไป
ชิ้นข้อมูลที่แตกจากเอกสารก็ควรย้อนกลับไปยัง document ID กับรุ่นได้ หากสร้าง chunk ใหม่ทุกครั้งโดยไม่รู้ว่าชุดเก่ามาจากฉบับใด เราอาจเพิ่มข้อมูลใหม่ได้แต่ไม่สามารถบอกว่าควรถอนชุดใดออกจากการค้น แล้วสุดท้ายทั้งสองฉบับยังแข่งกันอยู่
การเพิ่มฉบับใหม่ไม่ได้แปลว่าฉบับเก่าควรหายเสมอไป บางงานต้องตอบคำถามย้อนหลังด้วย แต่ต้องแยกได้ว่าฉบับใดใช้กับช่วงเวลา รุ่นผลิตภัณฑ์หรือกลุ่มผู้ใช้ใด ไม่ปล่อยให้คะแนนความใกล้ของข้อความเป็นผู้เลือกนโยบายความมีผลแทน
หากตั้งใจให้ค้นเฉพาะปัจจุบัน ควรมีวิธีสลับชุดที่พร้อมใช้หลังนำเข้าใหม่ครบ หรือถอน chunk เก่าตามขอบเขตที่ถูกต้อง ไม่ลบต้นฉบับเก่าก่อนรู้ว่าชุดใหม่พร้อมจนเกิดช่วงไม่มีหลักฐาน หรือเปิดให้ค้นข้อมูลครึ่งเก่าครึ่งใหม่โดยไม่ตั้งใจ
ขั้นลบของ vector store ก็ต้องดูขอบเขต ตัวอย่าง Weaviate ให้ระบุ collection กับตัวระบุหรือ filter และต้องมี tenant เมื่อใช้ชุดหลาย tenant การบอกว่าใช้ document ID จึงยังต้องตรวจว่าเป็นรหัสในพื้นที่ใด ไม่ลบจากชื่อคล้ายกันโดยยังไม่ยืนยันชุดงาน
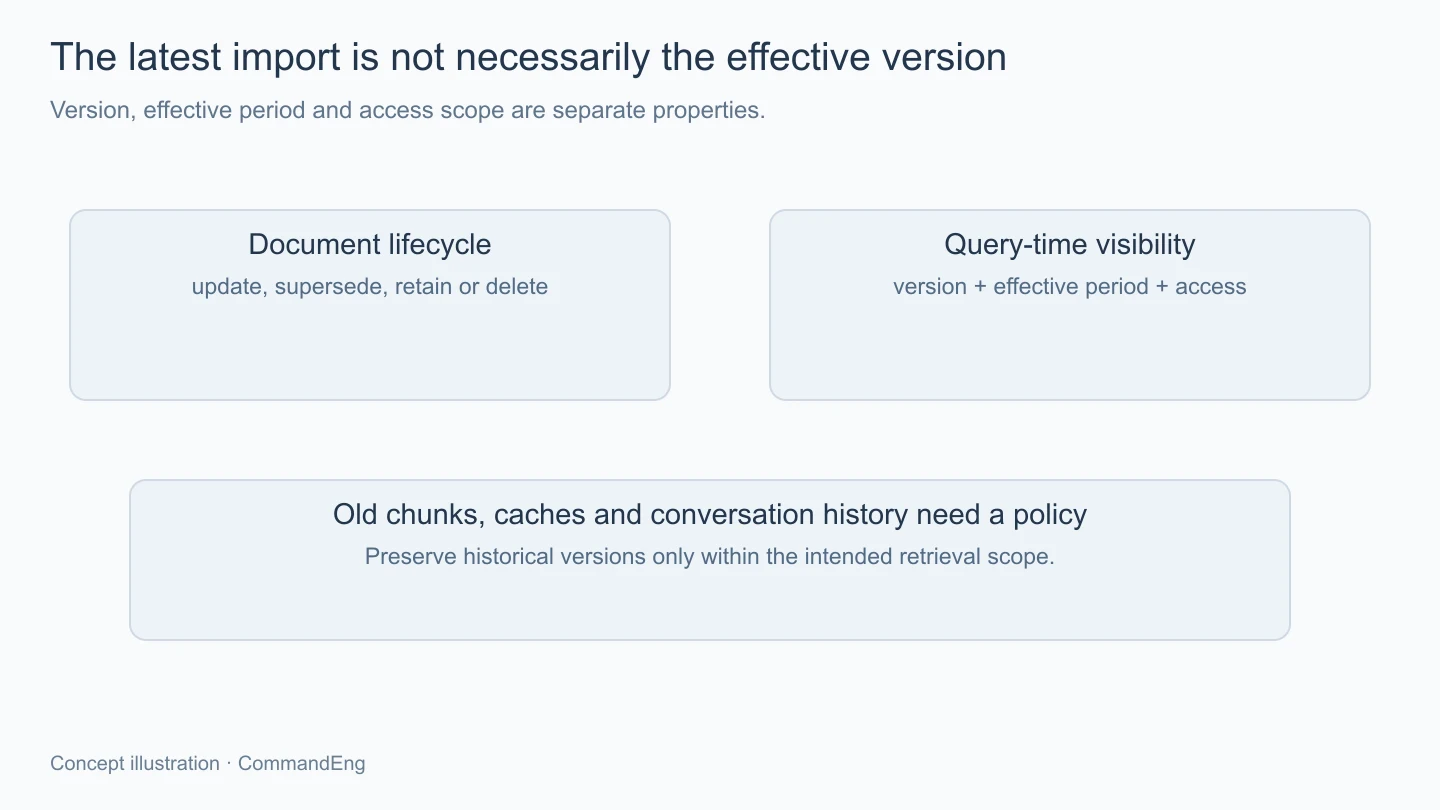
เอกสารที่เพิ่งนำเข้าอาจเป็นระเบียบเก่าที่คนอัปโหลดซ้ำ ขณะที่ฉบับที่แก้ไว้ล่วงหน้าอาจยังไม่ถึงวันที่มีผล การเรียงตามเวลา ingestion อย่างเดียวจึงไม่บอกว่าควรใช้ตอบคำถามปัจจุบันหรือคำถามของช่วงใด
ควรเก็บข้อมูลตามความหมายของงาน เช่น รุ่นที่ใช้ ช่วงมีผล สถานะยกเลิกและแหล่งเจ้าของเอกสาร เมื่อคำถามไม่ได้ระบุรุ่นและมีหลายคำตอบที่ใช้ได้คนละเงื่อนไข ระบบควรถามเพิ่มหรือแสดงข้อจำกัด ไม่เลือกหนึ่งฉบับแล้วเขียนเป็นกติกาสากล
ข้อมูลเรื่องสิทธิ์ก็ต้องตามการเปลี่ยนด้วย หากเอกสารถูกจำกัดกลุ่มผู้อ่านภายหลัง การที่ chunk เคยนำเข้าตอนยังเปิดกว้างไม่ได้ทำให้เปิดเผยต่อไปได้ตามเดิม ต้องตรวจทั้งกติกาค้นและผลที่ส่งให้โมเดล ไม่กรองหลังสร้างคำตอบจนเนื้อหาภายในถูกนำไปใช้ก่อนแล้ว
แม้ดัชนีจะปรับแล้ว คำตอบที่ cache ไว้หรือเนื้อหาที่ส่งอยู่ในประวัติแชทอาจยังอ้างฉบับเดิม ต้องรู้ว่าคีย์ของ cache กับบริบทที่ค้างผูกกับรุ่นเอกสารอย่างไร และระบบควรตรวจซ้ำเมื่อความรู้ที่เกี่ยวข้องเปลี่ยนหรือไม่
ถ้าผู้ใช้ถามต่อจากคำตอบเก่า ควรแยกว่ากำลังอธิบายฉบับที่เคยอ้างหรือถามสถานะปัจจุบัน ไม่ปล่อยให้คำว่าล่าสุดในข้อความกลายเป็นข้อสรุปโดยยังไม่มีการค้นใหม่ตามแหล่งที่ต้องใช้
การเปลี่ยน parser วิธีแบ่ง chunk หรือโมเดล embedding ก็เป็นรุ่นของกระบวนการอีกชั้น ควรเก็บให้ตรวจได้ว่าดัชนีส่วนใดสร้างด้วยวิธีใด และต้องสร้างใหม่หรือสลับชุดอย่างไรตามการรองรับจริง ไม่มองเฉพาะวันแก้เนื้อหาไฟล์
ควรติดตามอายุของงานนำเข้าที่ค้างกับข้อผิดพลาดรายเอกสารด้วย ไม่ให้สถานะรวมว่างานจบกลบไฟล์บางฉบับที่แปลงไม่ผ่าน เจ้าของความรู้จะได้รู้ว่าส่วนใดยังตอบจากข้อมูลเดิมอยู่และต้องแก้ที่ต้นทางหรือกระบวนการนำเข้า
ชุดทดสอบสามารถใช้เอกสารสมมติที่มีเงื่อนไขคนละรุ่น แล้วตรวจหลังเพิ่ม แก้ เลิกใช้และเปลี่ยนสิทธิ์ ดูทั้งรายการ chunk ที่ค้นได้กับคำตอบสุดท้าย เพราะคำตอบที่ดูถูกครั้งหนึ่งอาจเกิดโดยไม่ได้ค้นฉบับที่ตั้งใจใช้ก็ได้
ควรเก็บ document ID version และส่วนที่ถูกส่งเข้า context ของการตรวจนั้น โดยปกปิดข้อมูลตามสิทธิ์ บทนี้ยังไม่มีการแก้ฐานความรู้หรือลบเอกสารจริงของผู้ใช้ จึงไม่มีผลยืนยันว่าดัชนีหรือ cache ใดตามทันต้นฉบับแล้ว
ความสดของ RAG เกิดจากวงจรเอกสารที่ตามตัวตน รุ่นและสถานะได้ตลอดทาง เมื่อจัดการ chunk เก่า สิทธิ์ ช่วงมีผลและ cache ร่วมกับการนำเข้า เราจะรู้ว่าคำตอบอ้างฉบับใดก่อนตัดสินว่าล่าสุดจริงหรือไม่ ส่วนการตรวจควรเริ่มจากการเปลี่ยนที่รู้ผลคาดหวัง แล้วดูทั้งหลักฐานที่ค้นกับข้อความที่โมเดลเขียนออกมา