ตั้ง CPU กับ RAM ใน Kubernetes จากอะไรดี
ตอนเขียน manifest ครั้งแรก เรามักอยากมีค่า CPU กับ RAM ใส่ไว้ให้บริการขึ้นได้ก่อน จึงอาจเริ่มจากตัวอย่างของคนอื่น แล้วค่อยกลับมาดูอีกทีเมื่อแอปเริ่มช้าหรือมี container ถูกเริ่มใหม่
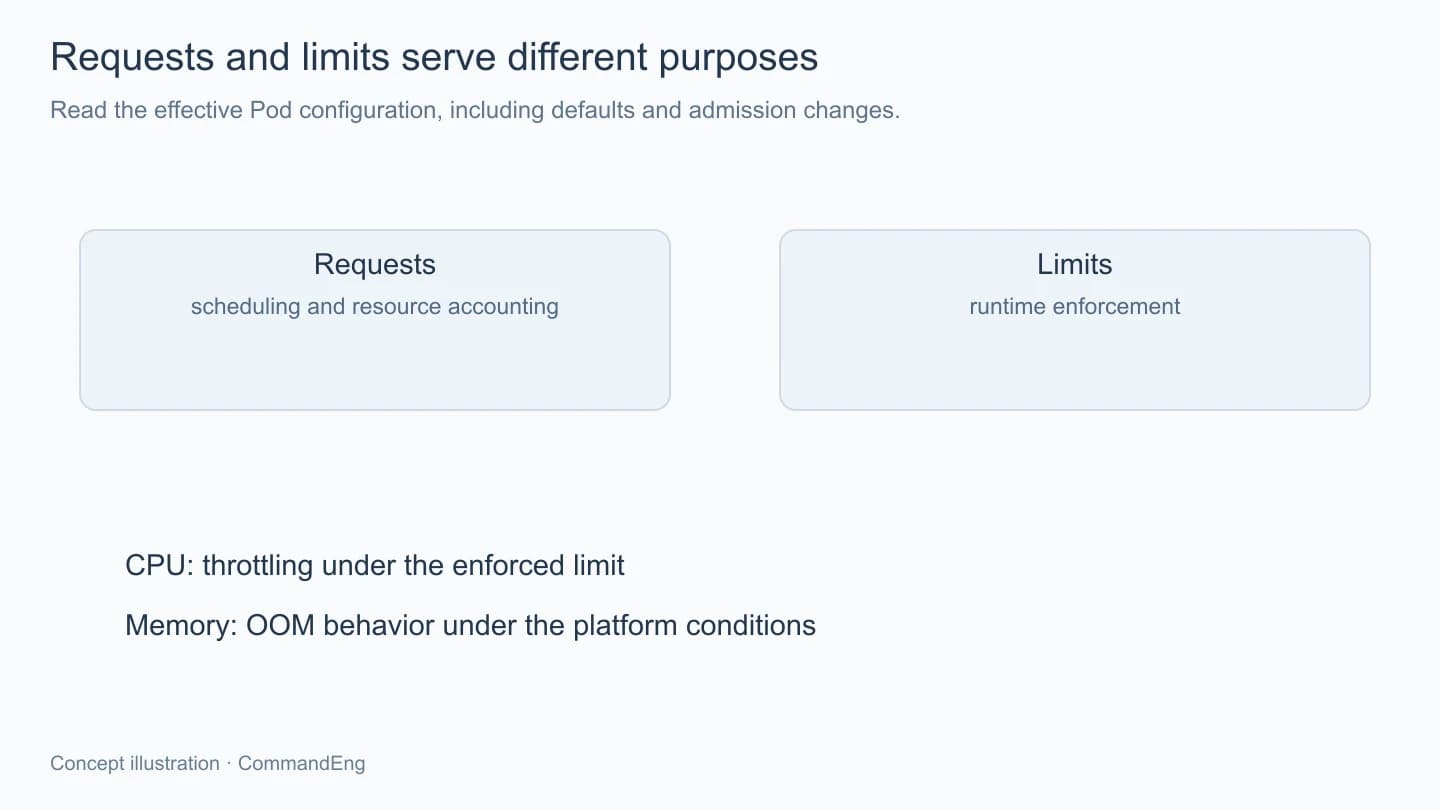
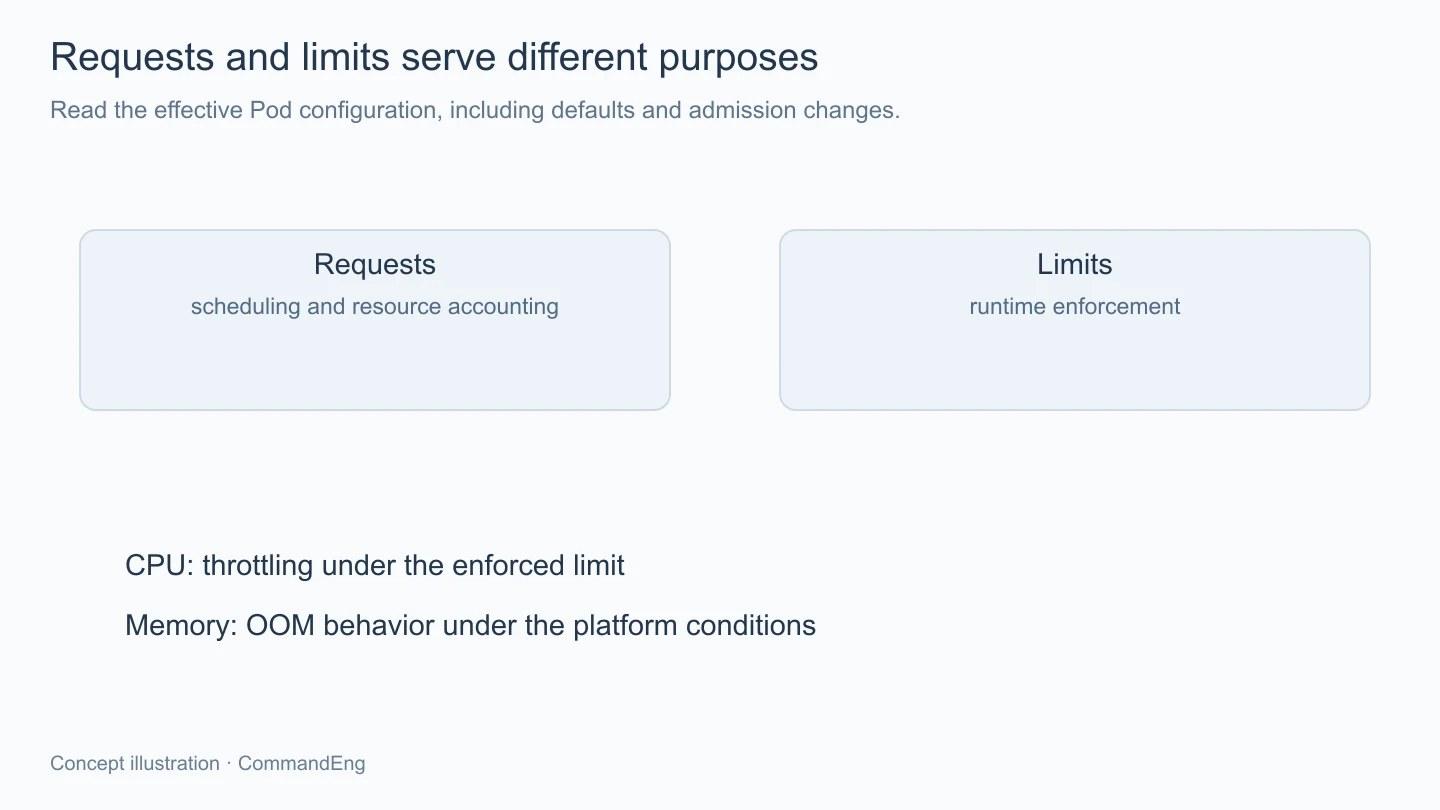
แต่ค่าพวกนี้มีผลตั้งแต่การเลือกที่ลงไปจนถึงสิ่งที่เกิดตอนใช้ทรัพยากรเพิ่มครับ ถ้าคิดว่า requests กับ limits เป็นตัวเลขชุดเดียวที่ตั้งให้เท่ากันไว้ก็พอ เราอาจยังไม่รู้ว่ากำลังขอพื้นที่เท่าไรและกำลังจำกัดพฤติกรรมส่วนใด
ก่อนเลือกขนาด ลองแยกหน้าที่ของสองค่านี้กับหลักฐานที่ต้องใช้ก่อน แล้วค่อยดูว่าระหว่าง dev, UAT และ production ควรต่างกันจากภาระงานอย่างไร ไม่ใช่เปลี่ยนชื่อ environment แต่คัดตัวเลขเดิมทุกจุด
requests ช่วยบอกสิ่งที่ต้องใช้ในการจัดวาง
Kubernetes ใช้ requests เป็นข้อมูลสำคัญตอนจัด Pod ลง Node ตามทรัพยากรที่จัดสรรได้ การตั้งจึงควรสะท้อนความต้องการของงานในขอบเขตที่เลือก ไม่ตั้งต่ำมากเพียงเพื่อให้ทุกอย่างลงได้แล้วค่อยหวังว่า Node จะรับไหวเมื่อใช้จริงพร้อมกัน
แต่ requests ก็ไม่ใช่เพดานการใช้โดยตัวมันเอง หากมีเงื่อนไขรองรับ container สามารถใช้มากกว่าค่านั้นได้ตามข้อกำหนดที่เหลือ จึงต้องอ่านร่วมกับ limits และสภาพ Node ไม่แปลว่าตั้ง request เท่านี้แล้วระบบจะใช้เท่านี้ตลอดเวลา
หน่วยต้องถูกด้วย CPU ใช้รูปแบบที่ Kubernetes กำหนด เช่น millicpu ส่วนหน่วยความจำมีความต่างของหน่วยที่เลือก การพิมพ์ชื่อหน่วยผิดอาจเปลี่ยนความหมายมากกว่าที่คิด ควรตรวจค่าที่คลัสเตอร์รับจริงและสิ่งที่ admission policy อาจเติมให้ด้วย
ถ้าไม่ได้ใส่บางค่า คลัสเตอร์อาจมีการตั้งต้นหรือกฎเพิ่มเติม จึงไม่ควรอ่านเฉพาะไฟล์ที่ส่งไปแล้วถือว่าเป็นขอบเขตสุดท้ายของ Pod เสมอไป การตรวจ object ที่ใช้งานจริงช่วยให้รู้ว่าตัวเลขใดมีผลอยู่
limits ของ CPU กับ memory ไม่ได้ตอบสนองเหมือนกัน
CPU limit บนระบบที่ใช้กลไกตามปกติจำกัดเวลาประมวลผลด้วยการ throttle ดังนั้นแอปอาจยังรันอยู่แต่ตอบช้าลงเมื่อแตะข้อจำกัด ไม่จำเป็นต้องมี restart ให้สังเกตง่ายเหมือนเหตุบางประเภท
memory limit มีการบังคับคนละลักษณะ และเมื่อใช้เกินเงื่อนไขที่ระบบตรวจพบก็อาจถูก OOM kill ได้ รายละเอียดต้องดูระบบที่รันจริง ไม่แปลว่าหน่วยความจำจะถูกลดความเร็วให้เหมือน CPU ทุกกรณี
จึงควรดูทั้งการใช้งาน เหตุเริ่มใหม่ และสัญญาณการถูกจำกัดตามที่เครื่องมือเก็บได้ การเห็น CPU ใช้ไม่สูงในกราฟหนึ่งอาจยังต้องดูวิธีรวมกับช่วงเวลา เพราะค่าเฉลี่ยกว้างอาจไม่แสดงช่วงสั้นที่กระทบเวลาตอบสนอง
การเพิ่ม limit อาจช่วยแก้อาการบางแบบ แต่ต้องดูว่ามีทรัพยากรให้จริงและปัญหามาจากอะไร หากเป็น memory leak การเพิ่มพื้นที่อาจเพียงเลื่อนเวลาที่จะเจอเหตุเดิม ไม่ได้ทำให้พฤติกรรมใช้หน่วยความจำกลับมาคงที่เอง
เก็บช่วงทำงานที่เป็นตัวแทนของหน้าที่
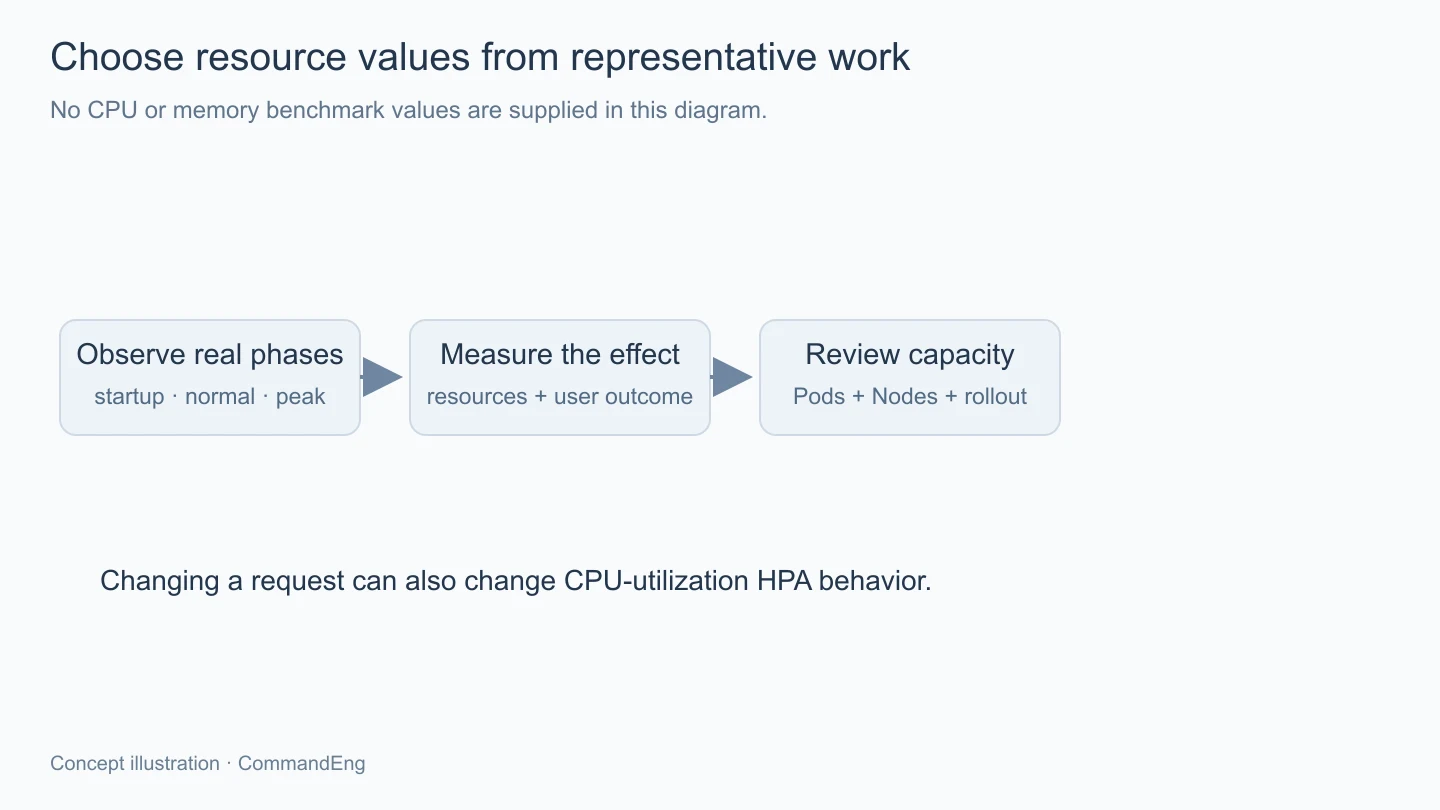
เริ่มจากช่วงปกติ ช่วงเริ่มแอป และช่วงภาระสูงตามที่ระบบต้องรับ โดยเก็บทั้งทรัพยากรกับผลที่ผู้ใช้ได้รับ เช่น เวลาตอบสนอง อัตราล้มเหลว หรือเวลาที่งานเบื้องหลังใช้ ไม่เลือกขนาดจากตัวเลข CPU อย่างเดียวโดยไม่รู้ผลต่อหน้าที่
งานที่มี import หรือประมวลผลเป็นรอบอาจมีรูปแบบต่างจากเว็บที่ตอบคำขอเรื่อยๆ ถ้าเก็บเพียงตอนว่าง เราก็จะขาดข้อมูลของช่วงที่ใช้จริงมากที่สุด จึงควรมีรายการสถานการณ์ที่ต้องครอบคลุมก่อนสรุปค่าตั้งต้น
วัดต่อเนื่องตามลักษณะงานด้วย เพราะหน่วยความจำหลังเปิดใหม่อาจต่างจากหลังรับงานมาระยะหนึ่ง หากมี cache หรือคิวที่สะสม ต้องรู้ว่าขอบเขตเติบโตอยู่ตรงไหน ไม่ใช้ค่าช่วงแรกไปรับรองงานระยะยาวทันที
ค่าที่ได้ควรถูกเก็บคู่กับรุ่นแอป ขนาดข้อมูล และจำนวน replica เพื่อให้เทียบการเปลี่ยนแปลงได้ หากปรับหลายอย่างพร้อมกันแล้วทรัพยากรลดลง เราจะยังไม่รู้ว่าผลมาจากขนาดต่อ Pod หรือการแบ่งงานที่เปลี่ยนไป
UAT กับ production ต่างกันได้ แต่ต้องมีเหตุผล
UAT อาจมีจำนวนผู้ใช้และข้อมูลน้อยกว่า จึงไม่จำเป็นต้องใช้ขนาดเดียวกับ production ทุกด้าน แต่ควรรู้ว่าสิ่งที่ทดสอบใน UAT ยืนยันเรื่องใด และส่วนใดต้องใช้สภาพใกล้ production จึงประเมินได้
จำนวน replica กับทรัพยากรต่อ replica เป็นคนละแกน การเพิ่มจำนวนช่วยได้ตามความสามารถแบ่งงานของแอป ขณะที่เพิ่มขนาดต่อ Pod เปลี่ยนขอบเขตการประมวลผลของแต่ละตัว จึงไม่ควรเรียกทั้งสองแบบรวมว่าขยายระบบโดยไม่บอกว่าปรับอะไร
หากใช้ HPA แบบ CPU utilization ค่า request ยังเป็นฐานของการตีความอัตราใช้งานตามที่กำหนดด้วย การเปลี่ยน request จึงอาจเปลี่ยนพฤติกรรม autoscale แม้ภาระจริงไม่ได้เปลี่ยนตาม ต้องตรวจสองส่วนร่วมกันก่อนแก้ตัวเลขหนึ่งตัว
นับความจุของ Node และช่วงอัปเดตด้วย
ต่อให้ค่าต่อ Pod ดูเหมาะ หากจำนวนที่ต้องรันพร้อมกันเกินทรัพยากรที่จัดวางได้ ก็ยังอาจมี Pod รออยู่ โดยเฉพาะช่วง rolling update ที่มีตัวใหม่เพิ่มขึ้นก่อนตัวเก่าหยุดตามกลยุทธ์ที่เลือก
ควรเผื่อทรัพยากรของระบบและบริการร่วมที่ Node ต้องใช้ ไม่เอาขนาดเครื่องทั้งหมดหารด้วย request แล้วถือเป็นจำนวน Pod ที่รับรองได้ และดูข้อกำหนดการกระจายงานตาม failure domain หากงานต้องรองรับการเสียของบางเครื่องด้วย
ตอนเปลี่ยนค่าจึงควรตรวจสถานะการจัดวาง เหตุที่ pending และผลต่อแอปหลังปล่อย ไม่ดูเพียงว่า manifest ผ่าน validation เพราะการตรวจรูปแบบยังไม่ได้ทดลองว่าความจุของคลัสเตอร์พอในทุกช่วงที่ออกแบบไว้
ควรจดผู้รับผิดชอบกับเหตุผลของการปรับค่าไว้ในประวัติการตั้งค่าด้วย หากมีระบบอัตโนมัติหรือเครื่องมือจัดการหลายตัว ต้องรู้ว่าใครเป็นเจ้าของค่าปัจจุบัน ไม่ให้ผลที่ปรับจากการทดลองถูกอีกตัวเขียนทับกลับโดยไม่มีใครเห็นว่ากำลังใช้ข้อกำหนดชุดใดจริง
สรุป
requests กับ limits มีหน้าที่ต่างกัน และ CPU กับ memory ก็มีผลเมื่อถูกจำกัดต่างกัน การเลือกขนาดจึงควรมาจากภาระจริงกับผลต่อการใช้งาน พร้อมดูจำนวน replica, HPA และความจุ Node ร่วมกัน เมื่อเก็บเงื่อนไขการวัดไว้ เราจะปรับค่าระหว่าง environment ได้มีเหตุผลกว่าการคัดตัวเลขที่ทำให้ตัวอย่างหนึ่งรันผ่านครับ

