


เวลาเพิ่มหน้าทดลองหรือหน้าที่ไม่ต้องการให้ปรากฏใน Google เราอาจคิดว่าปิดบอทไว้ก็น่าจะจบ แล้วใส่ noindex เพิ่มอีกชั้นเพื่อให้แน่ใจ แต่ถ้าปิดทางอ่านหน้าตั้งแต่ต้น ระบบค้นหาก็อาจไม่เห็นคำสั่งที่เราเพิ่งใส่ไว้ข้างใน
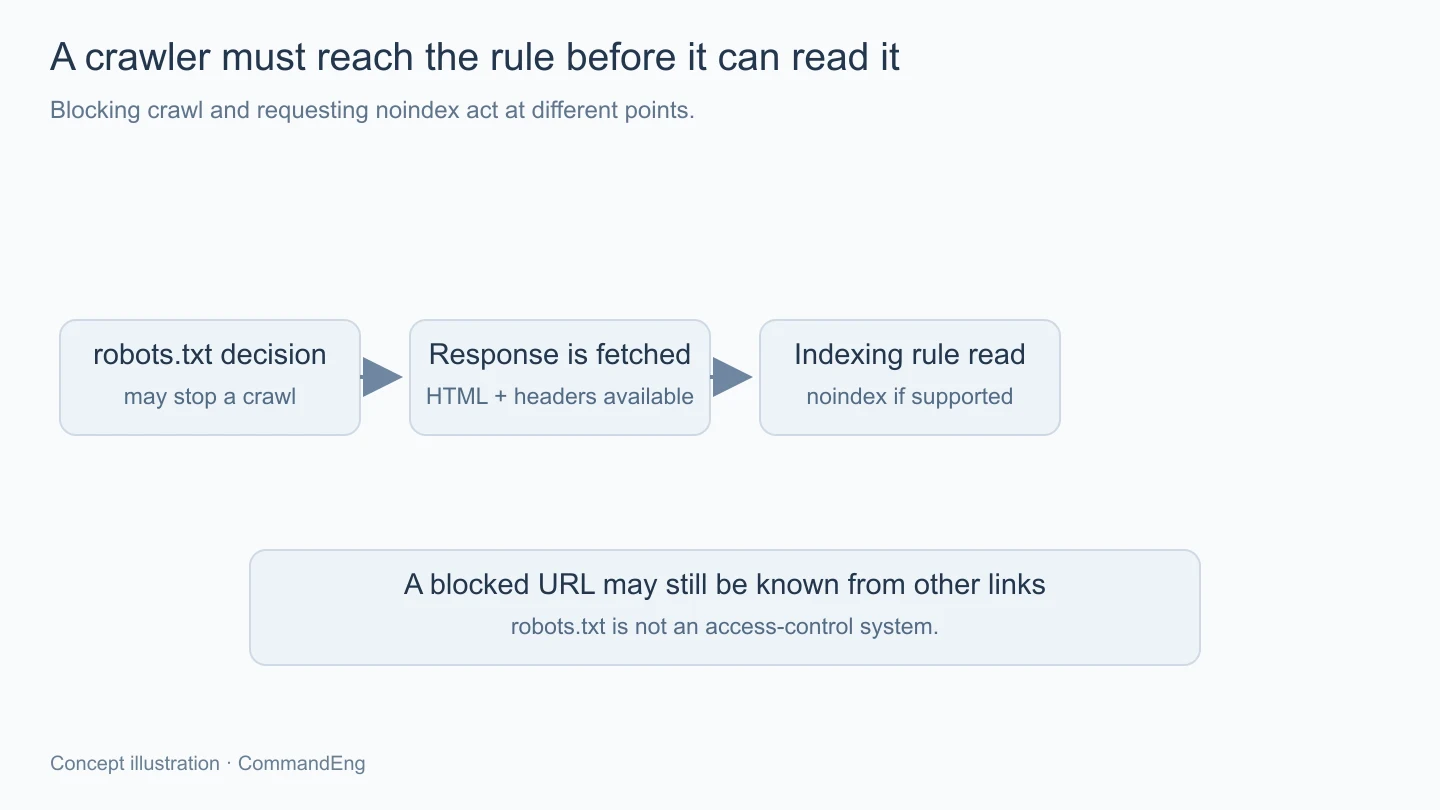
เรื่องนี้เกิดจากเครื่องมือสองอย่างทำคนละหน้าที่ครับ robots.txt ใช้บอกการเข้ามาอ่านของ crawler ที่ทำตามกฎ ส่วน noindex บอกเรื่องการนำเนื้อหาเข้าดัชนีเมื่อระบบอ่านคำสั่งนั้นได้
ก่อนเลือกใช้จึงควรบอกเป้าหมายให้ชัด ว่าต้องการลดการอ่าน ไม่ให้แสดงในผลค้นหา หรือไม่ให้คนนอกเข้าถึงเนื้อหาเลย ทั้งสามข้อไม่ใช่เรื่องเดียวกัน
กฎใน robots.txt ช่วยบอก crawler ที่เกี่ยวข้องว่าเส้นทางใดอนุญาตหรือไม่อนุญาตให้เข้ามาอ่าน จึงมีประโยชน์กับการจัดการการสำรวจตามลักษณะเว็บ แต่ไม่ใช่ระบบตรวจสิทธิ์ที่จะบังคับให้ทุก client เปิด URL ไม่ได้
ถ้าเส้นทางหนึ่งถูกห้าม crawl ระบบที่ทำตามกฎอาจไม่โหลดเนื้อหาหน้านั้น แต่ยังรู้จัก URL จากลิงก์ภายนอกได้ จึงไม่ควรถือว่าการ disallow ทำให้ URL หายจากผลค้นหาแน่นอนทุกกรณี
อีกด้านหนึ่ง การบล็อกทรัพยากรที่หน้าใช้จริงอาจทำให้ระบบเข้าใจเนื้อหาได้ไม่ครบ เช่น ข้อมูลหรือโค้ดที่จำเป็นต่อการแสดงบทความ จึงควรตรวจสิ่งที่กฎครอบคลุม ไม่ใช้การปิด directory กว้างๆ โดยยังไม่รู้ว่า URL สาธารณะต้องใช้ส่วนใด
ถ้าเว็บมีหลายโฮสต์หรือ environment ต้องตรวจไฟล์ของปลายทางที่ใช้อยู่จริงด้วย กฎที่ถูกต้องบน UAT ไม่ควรถูกนำมาคาดว่าเหมาะกับเว็บสาธารณะ และการแก้ไฟล์ใน repo ก็ยังต้องตรวจว่าผลตอบสาธารณะเปลี่ยนตามแล้วหรือไม่
สำหรับหน้า HTML สามารถใช้ robots meta ในส่วน head เพื่อระบุ noindex ส่วน response header แบบ X-Robots-Tag ใช้กำหนดกฎกับทรัพยากรที่ตอบกลับได้เช่นกัน รวมถึงกรณีที่ไม่ใช่ HTML ตามการรองรับของระบบค้นหา
ตัวอย่าง meta ของหน้าสมมติ:
<meta name="robots" content="noindex">
ส่วนตัวอย่าง header ของ response อีกแบบ:
X-Robots-Tag: noindex
คำสั่งทั้งสองต้องอยู่ในคำตอบที่ crawler อ่านได้ หาก robots.txt หรือเงื่อนไขอื่นกันการเข้าถึงไว้ก่อน ระบบก็ไม่รู้ว่าหน้ามี noindex เพิ่มแล้ว การใช้พร้อมกันจึงต้องดูเส้นทางของการอ่าน ไม่คิดว่ายิ่งปิดหลายจุดยิ่งได้ผลตามเป้าหมายเสมอ
Google ไม่รองรับการเขียน noindex เป็นกฎใน robots.txt ถ้าต้องการใช้คำสั่งนี้ต้องอยู่ในช่องทางที่รองรับจริง และถ้าใช้ CMS ก็ควรตรวจว่าตัวเลือกซ่อนจากการค้นหาสร้างคำตอบแบบใดให้หน้า ไม่เดาจากชื่อปุ่มเพียงอย่างเดียว
หน้าที่เปิดให้คนทั่วไปอ่านได้แต่ไม่ต้องการให้อยู่ในผลค้นหา อาจใช้ noindex โดยเปิดทางให้ระบบอ่านกฎ ส่วนหน้าที่เป็นข้อมูลภายในและไม่ต้องการให้คนนอกเห็นควรมีการควบคุมสิทธิ์การเข้าถึงโดยตรง
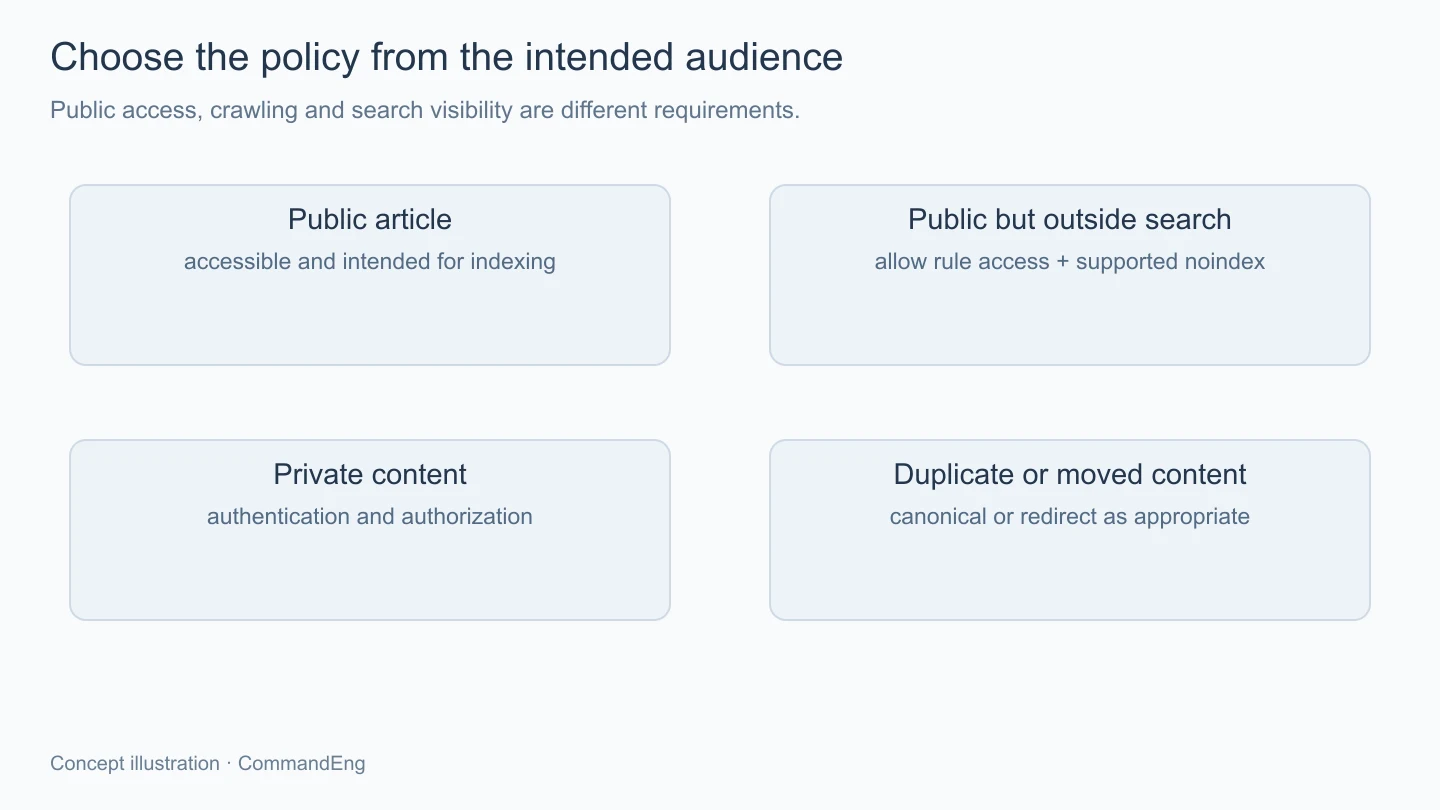
การหายจากผลค้นหาไม่ได้ทำให้ลิงก์ที่ใครมีอยู่เปิดไม่ได้ จึงต้องแยกเป้าหมายนี้ในขั้นออกแบบ เช่น เอกสารร่างที่ผู้รับลิงก์เปิดอ่านได้กับหลังบ้านที่ต้องล็อกอินเป็นคนละนโยบาย แม้ทั้งคู่ไม่ต้องการให้ค้นเจอเหมือนกัน
สำหรับหน้า duplicate ที่อยากรวมความสัมพันธ์ไป URL หลัก ก็อาจเป็นเรื่อง canonical มากกว่า noindex การห้าม index ทุกฉบับอาจตัดหน้าที่ตั้งใจใช้เป็นตัวแทนออกไปด้วย จึงควรอ่านบทบาทของเครื่องมือให้ตรงกับเหตุที่สร้างหน้าซ้ำ
ส่วนหน้าที่ถูกลบหรือย้ายถาวรต้องมีสถานะตอบกลับกับเส้นทางย้ายที่เหมาะสม การคงหน้าเนื้อหาหายแต่ตอบสำเร็จแล้วเติม noindex ไปเรื่อยๆ อาจไม่ได้ช่วยให้โครงเว็บสะท้อนสิ่งที่มีอยู่จริงสำหรับคนอ่าน
คำสั่งอาจถูกเติมจากหลายชั้น เช่น แอปสร้าง meta แต่บริการกลางเพิ่ม header อีกชุด หรือ template บางกลุ่มรับค่าจาก environment ไม่เหมือนกัน จึงควรดู response ของ URL ที่เป็นปัญหาจริงทั้งสองส่วน
หากมี redirect ให้ตามไปถึงปลายทางด้วย เพื่อรู้ว่ากฎอยู่ที่ใดและกำลังใช้กับคำตอบใด ส่วนการแสดงผลผ่าน JavaScript ก็ควรระวังการเปลี่ยนคำสั่งระหว่างทาง และดูผลที่เครื่องมือของระบบค้นหาอ่านได้ประกอบ
ตรวจเงื่อนไขของหน้าอย่างบทความ ร่าง รายการ และหลังบ้านแยกกัน การได้ผลถูกหนึ่ง URL ไม่รับรองว่ากฎของทุก template ถูก เพราะแหล่งกำหนด metadata อาจมีหลายจุดที่ไม่ได้ใช้ค่าเดียวกัน
ในงานที่มี environment ทดลอง แนะนำให้มีการตรวจนโยบายหลังขึ้นระบบด้วย เช่น หน้าบทความสาธารณะที่ต้อง index ไม่ควรติด noindex โดยไม่ตั้งใจ ส่วนหน้าทดลองก็ยังอยู่ในขอบเขตเดิม การตรวจตามบทบาททำให้ไม่ต้องเลือกเปิดหรือปิดทั้งเว็บแบบเหมารวม
เมื่อเพิ่งเปลี่ยนกฎ ข้อมูลฉบับที่ระบบค้นหาเคยเก็บไว้อาจยังสะท้อนสถานะเก่า ควรแยกการตรวจ response ปัจจุบันจากข้อมูลการ crawl ครั้งก่อน แล้วดูว่าได้อ่านกฎใหม่ไปหรือยัง
URL Inspection ช่วยดูข้อมูลเหล่านี้ในขอบเขตที่เครื่องมือรายงานได้ ส่วน live test ก็ยังไม่ใช่คำรับรองผล index ในอนาคต จึงควรเก็บวันแก้กับสิ่งที่เปลี่ยนไว้ เพื่อไม่วนแก้กฎเดิมซ้ำเพียงเพราะรายงานยังไม่ทันเปลี่ยน
หากต้องนำเนื้อหาออกจากการเข้าถึงอย่างเร่งด่วน ควรจัดการการเข้าถึงหน้าโดยตรงตามหน้าที่ ไม่รอให้การอัปเดตดัชนีมารับผิดชอบแทน การกำหนดผู้เห็นเนื้อหากับการนำ URL ออกจากผลค้นหายังเป็นคนละขั้นที่ต้องดูแยกกัน
บันทึกเหตุผลของกฎที่ตั้งไว้ด้วย โดยเฉพาะ path ที่ดูคล้ายหน้าสาธารณะ เมื่อเพิ่มหมวดใหม่หรือเปลี่ยนโครง URL จะได้ตรวจว่ากฎเดิมยังครอบคลุมตรงที่ตั้งใจ ไม่ขยายไปบล็อกหน้าใหม่จากชื่อเส้นทางที่บังเอิญใกล้กัน
robots.txt กับ noindex ใช้แทนกันไม่ได้ เพราะข้อหนึ่งกำกับการ crawl ส่วนอีกข้อบอกการ index หลังระบบอ่านคำสั่งได้ เลือกนโยบายจากเป้าหมายของแต่ละหน้า แล้วตรวจทั้งทางเข้าถึง header และ HTML ของ URL จริง จะช่วยให้การซ่อนจากผลค้นหาไม่ถูกสับสนกับการป้องกันข้อมูลหรือการรวมหน้าซ้ำครับ