ช่วง rolling update แอปรุ่นเก่ากับใหม่ต้องอยู่ด้วยกันได้ไหม
เวลา deploy แบบ rolling update เรามักอยากให้บริการทำงานต่อระหว่างเปลี่ยนรุ่น จึงทยอยเพิ่มตัวใหม่และนำตัวเก่าออก แทนการหยุดทุกอย่างแล้วเปิดพร้อมกันใหม่ในจังหวะเดียว
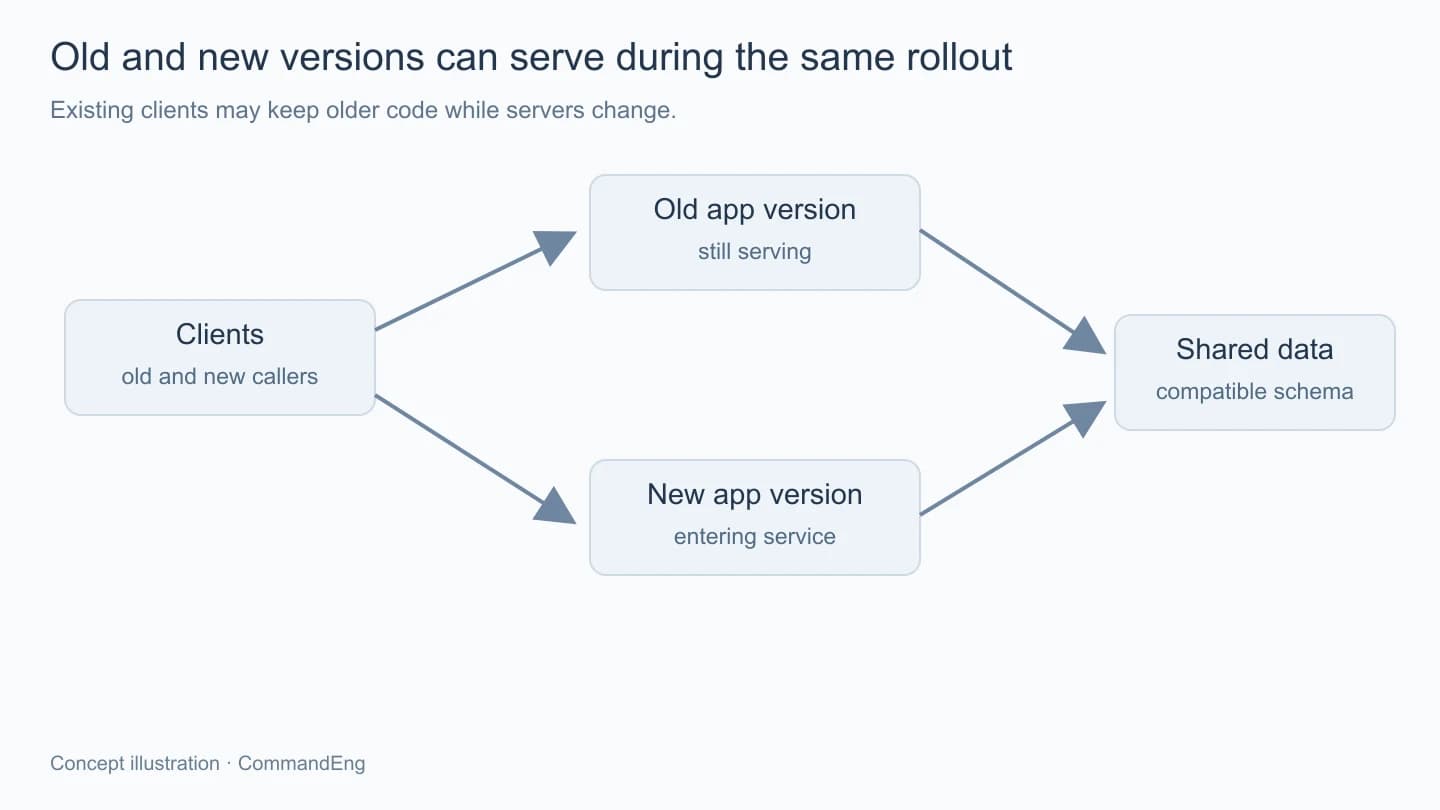
แต่ในช่วงรอยต่อนั้น ระบบไม่ได้มีเพียงรุ่นใหม่ครับ คำขอบางส่วนอาจไปตัวเก่า บางส่วนไปตัวใหม่ และหน้าเว็บที่คนเปิดค้างไว้ก็อาจยังมีโค้ดจากก่อน deploy อยู่ด้วย การที่รุ่นใหม่ทดสอบผ่านเมื่อรันเดี่ยวจึงยังไม่ครอบคลุมสถานการณ์ทั้งหมด
ก่อนปล่อย ลองมองว่าแต่ละส่วนต้องทำงานร่วมกับรุ่นใดในช่วงเปลี่ยน แล้วค่อยจัดวิธีเปลี่ยน API ข้อมูล และการหยุดรับงานให้ตามกันได้ จะช่วยให้ความต่อเนื่องของบริการมีหลักฐานมากกว่าการเห็นจำนวน Pod ครบ
ระหว่าง rollout มีหลายรุ่นอยู่ในเส้นทางเดียวกัน
Deployment จัดการ ReplicaSet กับจำนวนตามกลยุทธ์ที่กำหนด ทำให้รุ่นเก่ากับใหม่มีช่วงอยู่ร่วมกันได้ ส่วนจำนวนที่เพิ่มและจำนวนที่ยอมไม่พร้อมมีข้อกำหนดที่ต้องอ่านตามการตั้งค่า ไม่ควรคิดว่าทุก rollout จะเปลี่ยนทีละ Pod เหมือนตัวอย่างเดียวกันเสมอไป
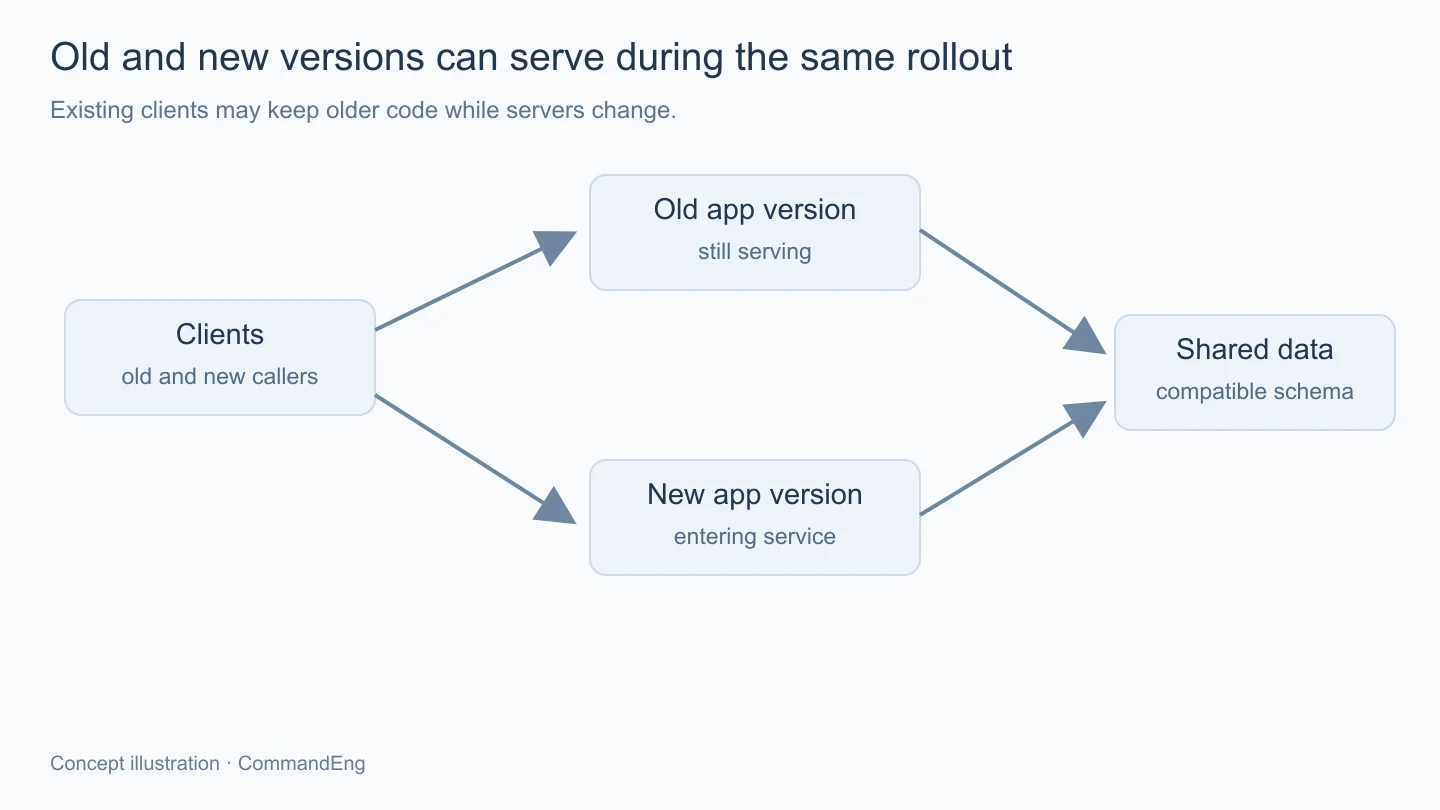
ถ้าแต่ละ Pod รับคำขอจาก Service เดียวกัน API ที่ใช้ร่วมควรมีพฤติกรรมที่ผู้เรียกในช่วงนั้นเข้าใจได้ ทั้งผู้เรียกรุ่นใหม่กับผู้เรียกที่ยังไม่อัปเดต ไม่สมมติว่า backend กับ frontend ถูกโหลดใหม่พร้อมกันทุกคนทันทีที่เริ่ม deploy
งานเบื้องหลังและอุปกรณ์ที่ reconnect ช้าก็เป็นผู้เรียกที่ต้องนับด้วย หากดูเฉพาะหน้าเว็บที่เพิ่ง refresh บนเครื่องทดสอบ เราอาจขาดหลักฐานของลูกข่ายที่ยังใช้รูปแบบเดิมอยู่ในระยะที่ระบบตั้งใจรองรับ
เปลี่ยน API ให้มีช่วงที่อ่านข้ามรุ่นได้
การเพิ่มข้อมูลใหม่ที่ผู้เรียกเดิมยังไม่ต้องใช้มีผลต่างจากการลบหรือเปลี่ยนความหมายของ field เดิม หากต้องเปลี่ยนแบบกระทบผู้เรียก ควรมีช่วงรองรับหรือเส้นทางรุ่นที่ชัด ไม่ให้การปล่อย server ใหม่เป็นเหตุให้ผู้ใช้ที่ยังเปิดหน้าเก่าทำงานต่อไม่ได้ทันทีโดยไม่มีแผน
ฝั่งผู้รับข้อมูลก็ควรตรวจตามสัญญาที่กำหนด ไม่เขียนให้พังเมื่อพบ field เพิ่มหากรูปแบบงานไม่ได้ตั้งใจให้เข้มระดับนั้น แต่ก็ไม่แปลว่าให้ข้ามการตรวจทุกอย่าง เพราะหน่วย ชนิด และความหมายของค่าที่ต้องใช้ยังต้องตรงกัน
ควรมีรายการทดสอบความเข้ากันได้ตามคู่ที่ต้องอยู่ร่วม เช่น frontend เดิมกับ API ใหม่ และข้อมูลที่ส่งจาก worker เดิมเข้าบริการใหม่ ไม่ใช้คำว่ามี version control แล้วเป็นหลักฐานว่ารุ่นต่างๆ ทำงานด้วยกันได้ เพราะประวัติโค้ดกับสัญญาระหว่างระบบเป็นคนละส่วนที่ต้องตรวจ
schema ของฐานข้อมูลต้องคิดถึงตัวเก่าด้วย
ถ้ารุ่นใหม่แก้ฐานข้อมูลจนรุ่นเก่าอ่านไม่ได้ ช่วงที่ยังมี Pod เก่าทำงานก็อาจเกิดข้อผิดพลาดได้ แม้ตัวใหม่ใช้ schema ใหม่สำเร็จ วิธีเปลี่ยนจึงควรรักษาช่วงที่ทั้งสองฝั่งทำงานได้ตามที่ออกแบบ
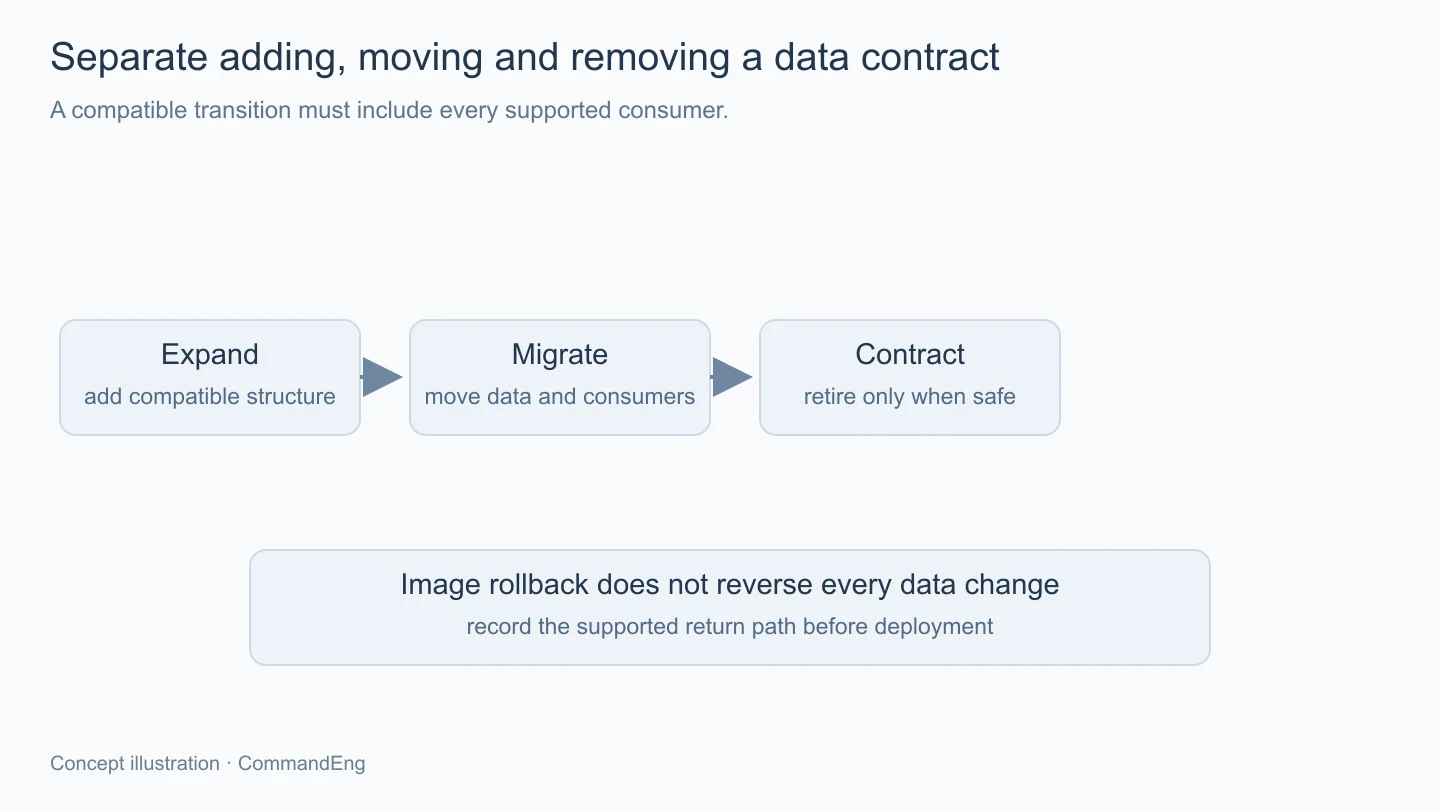
แนวทางอย่างเพิ่มส่วนใหม่ก่อน ย้ายการอ่านเขียนหรือข้อมูลตามขั้น แล้วค่อยตัดของเดิมเมื่อไม่ใช้งานแล้ว ช่วยแยกการเปลี่ยนเป็นช่วงที่ตรวจได้ แต่รายละเอียดต้องตรงกับฐานข้อมูลและแอป ไม่ใช้ชื่อ expand/contract เป็นคำรับรองว่าจะย้อนกลับได้ทุกกรณี
ถ้ามี backfill หรือ migration ที่ใช้เวลานาน ควรดูความครบ ความสามารถทำซ้ำ และภาระที่สร้างต่อระบบ ไม่ให้ทุก Pod ใหม่ต่างเริ่มงานเดียวกันโดยไม่มีการประสาน และควรมีทางรู้ว่าข้อมูลส่วนใดยังอยู่ระหว่างเปลี่ยน
rollback ของ image ไม่ได้ทำให้ข้อมูลถูกย้ายกลับตามเอง จึงต้องวางขอบเขตว่าถ้าตัวใหม่มีปัญหา เราจะกลับแอปเดิมได้ถึงจุดใด หรือจำเป็นต้องใช้แนวทางแก้ต่อไปข้างหน้าตามสภาพข้อมูลที่เปลี่ยนแล้ว
ความพร้อมรับงานกับการออกจากระบบต้องครบวงจร
ตัวใหม่ควรผ่าน readiness ที่สะท้อนงานก่อนรับคำขอ ส่วนตัวเก่าต้องมีวิธีหยุดรับงานใหม่และจัดการงานค้างตามระยะที่ระบบให้ ไม่ใช่ปิด process ทันทีโดยสมมติว่าการถอนออกจากทางส่งงานเกิดพร้อมกันทุกส่วน
คำขอที่เชื่อมค้าง การอัปโหลด หรืองานใน queue อาจมีวงจรชีวิตต่างจาก request สั้น จึงต้องตรวจตามสิ่งที่แอปทำจริง ไม่ทดสอบเพียงเปิดหน้าแรกระหว่างกด deploy แล้วสรุปว่าไม่มีการสะดุดของทุกงาน
หากผู้เรียกมี retry ต้องดูด้วยว่าคำขอเดิมที่ไปถึงตัวเก่าแล้วบางส่วนจะถูกส่งมาทำใหม่กับตัวใหม่อย่างไร งานที่มีผลเปลี่ยนข้อมูลควรมีการจัดการซ้ำตามสัญญาของมัน ไม่ให้การทำให้คำขอสำเร็จภายหลังสร้างผลเกินหนึ่งรอบโดยไม่มีใครเห็น
ความจุต้องรับช่วงที่มีตัวเพิ่มชั่วคราว
เมื่อกลยุทธ์อนุญาตเพิ่ม Pod ใหม่ก่อนลดเก่า ต้องมีพื้นที่ให้จัดวางตาม requests กับเงื่อนไขอื่น มิฉะนั้น rollout อาจค้างรอโดยที่แอปไม่ได้มีข้อผิดพลาดจากโค้ดเลย ควรแยกสถานะรอทรัพยากรออกจากการเริ่มแอปไม่ผ่าน
การมี replica พร้อมหลายตัวก็ควรดูว่าอยู่บนเส้นทางหรือพื้นที่เสียร่วมกันอย่างไร และบริการที่พึ่งอยู่รับจำนวน connection ที่เพิ่มชั่วคราวได้หรือไม่ ไม่คิดเฉพาะจำนวนปกติหลัง rollout จบ
ตัวเลือกจำนวนและช่วงรอจึงควรมาจากเวลาที่แอปเริ่มกับข้อกำหนดความพร้อม ไม่เลือกเพื่อให้ deploy จบเร็วที่สุดเพียงอย่างเดียว และต้องมีเกณฑ์ว่าติดอยู่ระดับใดจึงต้องหยุดหรือเริ่มตรวจต่อ
ทดสอบช่วงผสม ไม่ใช่ก่อนกับหลังอย่างเดียว
ในชุดทดสอบ ลองให้รุ่นเก่ากับใหม่อยู่ร่วมแล้วใช้เส้นทางที่สำคัญ ทั้งผู้เรียกเดิม งานเขียนข้อมูล และการหยุดตัวเก่า เก็บ error, latency กับรุ่นที่รับคำขอให้เชื่อมกันได้ จะช่วยระบุว่าข้อผิดพลาดเกิดเฉพาะช่วงใด
หลังปล่อยควรรู้ว่ารุ่นใดกำลังทำงานจริงและยังมี client เก่าในขอบเขตที่รองรับอยู่หรือไม่ การประกาศว่ารุ่นใหม่พร้อมจึงควรมาจากพฤติกรรมที่ตรวจครบช่วง ไม่ใช่เพียงสถานะ rollout ของ controller ที่ยืนยันจำนวนตามเงื่อนไขของมัน
สรุป
rolling update ต้องออกแบบให้ API ข้อมูล และ lifecycle รับช่วงที่หลายรุ่นอยู่ร่วมกันได้ เมื่อแยกการเพิ่ม schema การย้ายข้อมูล และการตัดของเดิม พร้อมทดสอบงานค้างกับความจุระหว่างอัปเดต เราจะปล่อยรุ่นได้ต่อเนื่องขึ้นและรู้ขอบเขตของทางกลับก่อนต้องใช้จริงครับ

