


เมื่อเว็บมีบทความเพิ่มขึ้น รายการ URL ที่อยากให้ระบบค้นหารู้จักก็ควรอัปเดตตามเนื้อหาที่เผยแพร่จริง หากยังจัดรายการด้วยมือ งานเล็กๆ อย่างเปลี่ยน slug หรือถอนบทความอาจทำให้ไฟล์ที่แจ้งไว้กับหน้าที่คนเปิดได้เริ่มไม่ตรงกัน
Sitemap ช่วยรวบรายการที่เราต้องการบอกได้ครับ แต่ก่อนสร้างไฟล์ควรตกลงว่าหน้าแบบไหนควรอยู่ในนั้น และข้อมูลอย่างวันแก้ไขควรอ้างอิงการเปลี่ยนแปลงใด ไม่ใช่ใช้เพียงเวลาที่ระบบสร้างไฟล์ครั้งล่าสุด
เมื่อวางกติกาตั้งแต่ต้น เราจะใช้ข้อมูลชุดเดียวกับการเผยแพร่ช่วยดูแลรายการต่อได้ โดยไม่ต้องไล่ตามแก้ทุก URL หลังบทความเริ่มมีจำนวนมาก
หน้าที่ใส่ควรเป็นฉบับสาธารณะที่ต้องการให้คนค้นพบ และเป็น URL หลักตามนโยบายของเว็บ หากบทความเดียวเปิดได้ทั้งลิงก์ปกติกับลิงก์ติดค่าติดตาม ก็ไม่จำเป็นต้องใส่ทุกแบบเพื่อแสดงว่ามีหลายหน้า
ควรคัดออกตั้งแต่ร่าง หน้าที่ตั้ง noindex หน้าต้องล็อกอิน และหน้าที่ถูกลบหรือย้ายจนไม่ได้เป็นปลายทางหลักแล้ว รายการที่ใส่จึงสะท้อนความตั้งใจเผยแพร่ มากกว่ารายการทุก record ที่มีในฐานข้อมูล
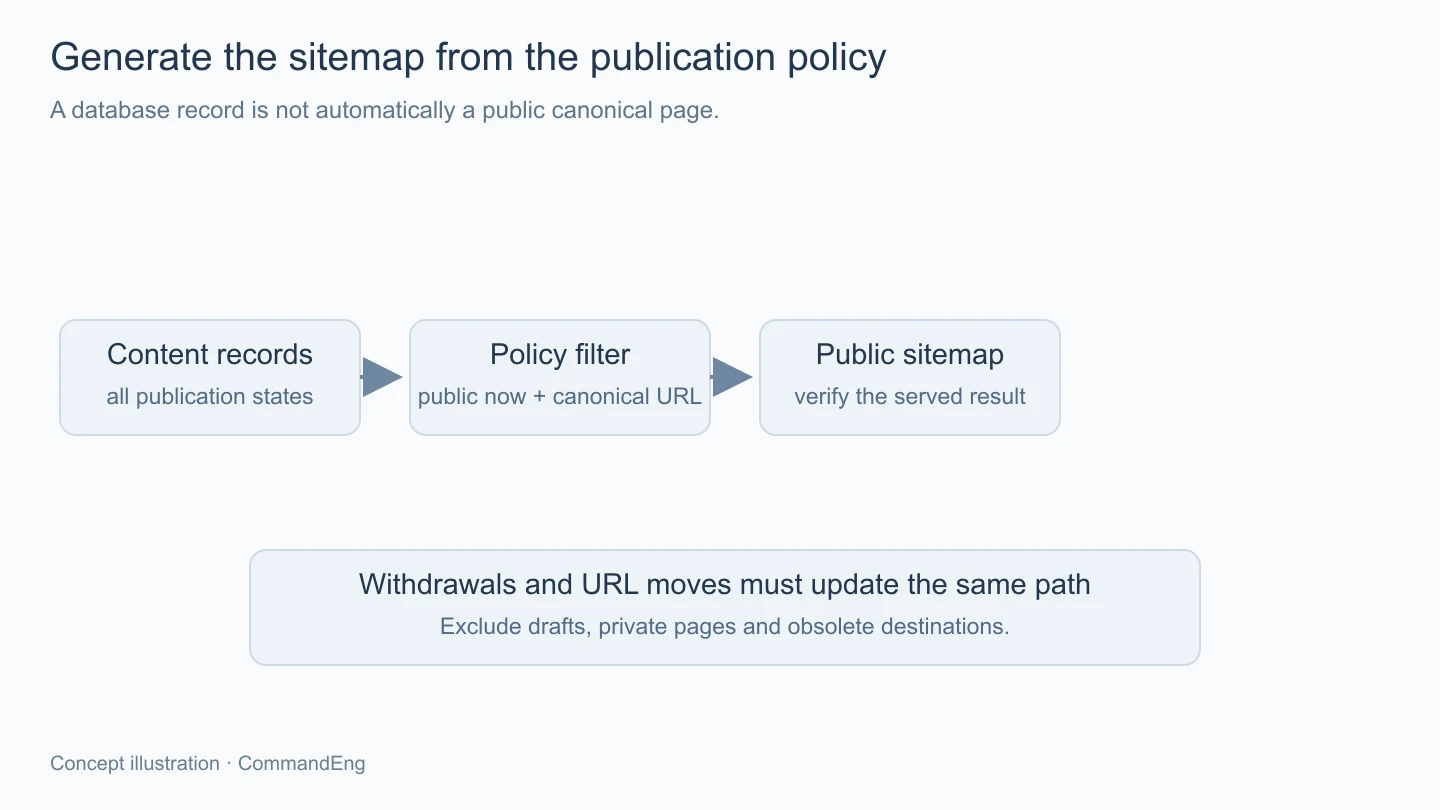
สำหรับเว็บที่มีวันเผยแพร่ล่วงหน้า ต้องใช้เวลาเป็นเงื่อนไขด้วย บทที่มีสถานะพร้อมแต่ยังไม่ถึงวันไม่ควรหลุดเข้ารายการสาธารณะก่อน ส่วนการถอนบทต้องถูกนำออกในเส้นทางเดียวกัน ไม่อาศัยว่าคนดูแลจะจำกลับมาแก้ไฟล์อีกแห่ง
หน้า tag หรือหมวดหมู่ก็ต้องตัดสินตามหน้าที่จริง ถ้ามีเนื้อหาและต้องการให้เป็นทางเข้าค้นหา ก็พิจารณาตามกติกานั้น แต่ไม่เพิ่มหน้าว่างหรือชุดตัวกรองจำนวนมากเพียงเพื่อทำให้ sitemap ยาวขึ้น
หาก sitemap ระบุ URL หนึ่ง แต่ canonical บนหน้าชี้อีก URL เรากำลังส่งสัญญาณคนละทาง ควรเลือกแนวเดียวแล้วตรวจทั้งจุดสร้างลิงก์ metadata และไฟล์รายการให้ตามกัน
การย้าย slug เป็นตัวอย่างที่เห็นงานนี้ชัด เมื่อเลือกปลายทางใหม่และมี redirect ตามที่ต้องการแล้ว sitemap ควรรายงานปลายทางใหม่ ส่วนลิงก์ภายในก็ควรพาไปที่นั่นโดยตรง ไม่เก็บ URL เก่าเป็นรายการหลักต่อเพราะยัง redirect ได้
แต่การใส่ URL หลักไม่ได้ทำให้ทุกหน้าถูก index แน่นอน Sitemap เป็นข้อมูลช่วยการพบและการเลือกหน้าที่เราต้องการ ระบบค้นหายังต้องเข้าถึงและประมวลผลหน้า จึงควรดูผลจากรายงานเป็นอีกขั้น
หากใช้หลายภาษา หน้าที่เป็นคำแปลจริงอาจมี URL หลักของแต่ละภาษา การเลือก canonical จึงต้องสอดคล้องกับโครงภาษาด้วย ไม่รวมทุกภาษาให้ชี้ไปหน้าเดียวเพียงเพราะอยู่ใน sitemap ไฟล์เดียวกัน
วันแก้ไขช่วยได้เมื่อรายงานอย่างถูกต้อง หากทุกครั้งที่สร้างไฟล์เปลี่ยน lastmod ของทุกหน้าเป็นเวลาปัจจุบัน แม้ตัวบทไม่ได้เปลี่ยน ข้อมูลนั้นก็ไม่ได้บอกว่าหน้าที่สำคัญต่อผู้อ่านมีการอัปเดตเมื่อไรจริง
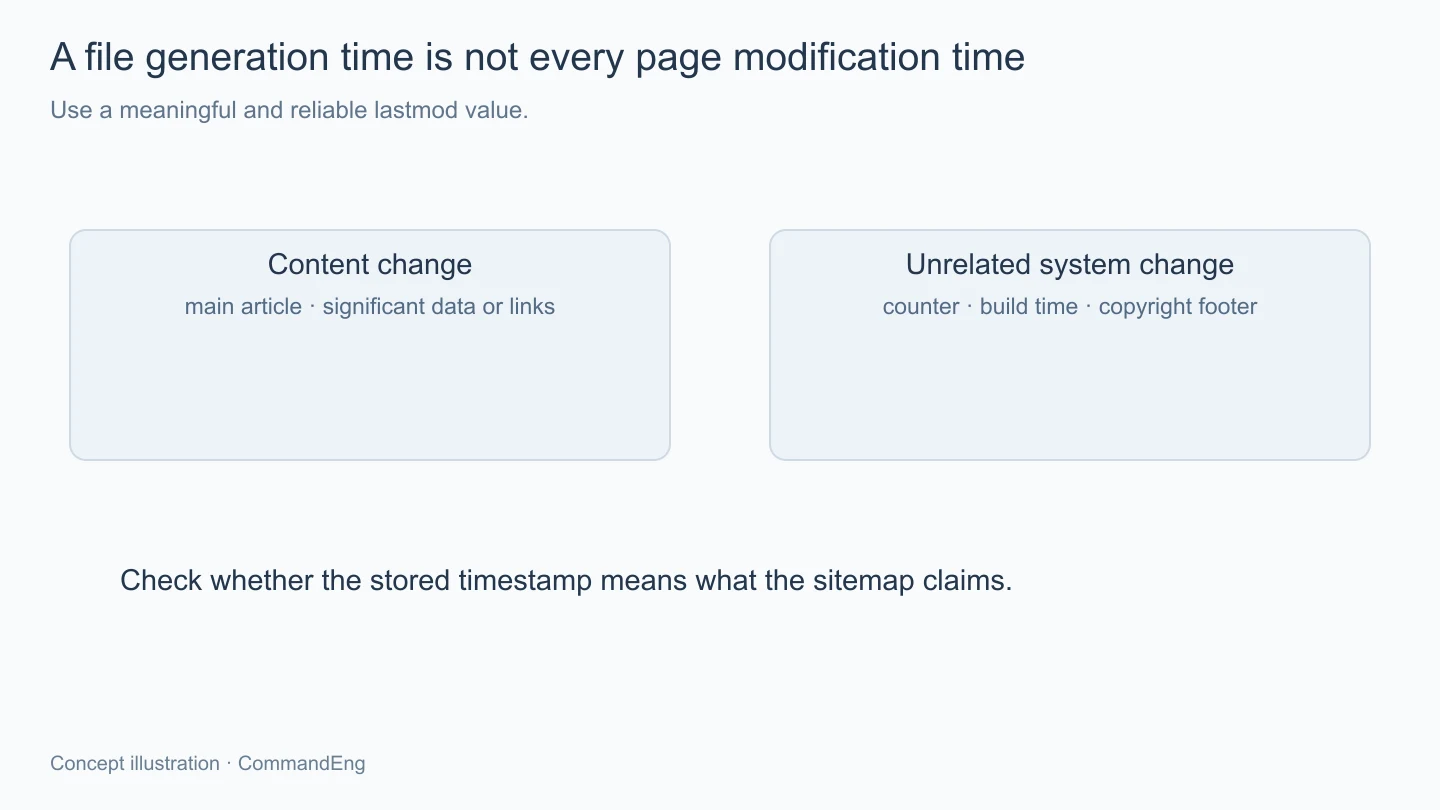
ควรแยกเวลาที่ระบบแตะ record ออกจากเวลาที่เนื้อหาสำคัญเปลี่ยน ตัวอย่างเช่น อัปเดตประเด็นในบท เปลี่ยนข้อมูลที่ใช้ตีความหน้า หรือแก้ลิงก์สำคัญ อาจต่างจากเพิ่มตัวนับหรือปรับข้อความลิขสิทธิ์ของทั้งเว็บไซต์
ถ้าระบบมี updatedAt ที่เปลี่ยนทุกครั้งจากหลายงาน ให้ตรวจว่าค่านั้นตรงกับความหมายที่ต้องการหรือไม่ อาจต้องมีฟิลด์สำหรับการอัปเดตเนื้อหาแทนการนำเวลาบันทึกทั่วไปไปใช้กับทุกหน้าที่ส่งออก
การไม่มีข้อมูลวันที่ที่เชื่อถือได้ควรถูกจัดการตามขอบเขตที่รู้ ไม่สร้างวันแก้ขึ้นมาเพื่อให้ทุกช่องดูครบ และควรระบุ timezone ในรูปแบบเวลาที่ใช้เพื่อไม่ให้วันเปลี่ยนเพราะขั้นแปลงข้อมูลระหว่างระบบ
ตัวอย่าง XML สมมติสำหรับบทความหนึ่งหน้า:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://example.com/content/mqtt-basics</loc>
    <lastmod>2026-06-10</lastmod>
  </url>
</urlset>
ใช้ URL แบบเต็มและจัดการอักขระพิเศษตาม XML ให้ถูก ไม่ต่อข้อความจาก slug หรือ query ลงไฟล์โดยไม่ escape ส่วน namespace กับ encoding ก็ควรตรงกับรูปแบบที่ประกาศ
Google ไม่ใช้ค่า priority กับ changefreq ใน sitemap จึงไม่ต้องเติมตัวเลขเหล่านี้เพื่อหวังให้บทหนึ่งถูกเลือกก่อน งานที่มีประโยชน์กว่าคือทำให้ URL และวันเปลี่ยนที่ส่งไปตรงกับหน้าจริง
สำหรับเว็บใหญ่ต้องดูขีดจำกัดขนาดไฟล์และจำนวน URL แล้วแยกไฟล์พร้อม sitemap index ตามความเหมาะสม แต่เว็บบทความขนาดเล็กไม่จำเป็นต้องทำโครงซับซ้อนก่อนมีเหตุผล ควรเลือกแบบที่ระบบสร้างและตรวจซ้ำได้ง่าย
หาก endpoint หรือ CDN เก็บแคชไว้ ต้องรู้ว่าหลังเผยแพร่บทใหม่รายการจะเปลี่ยนเมื่อไร ลองตรวจ URL ของ sitemap สาธารณะหลังเผยแพร่ ไม่ดูเพียงไฟล์หรือผล query ฝั่งหลังบ้านที่เพิ่งสร้างสำเร็จ
สุ่มตรวจรายการใหม่ รายการที่เปลี่ยน slug และรายการที่ถอน ว่าถูกใส่หรือเอาออกตามกติกา พร้อมเทียบสถานะปลายทางกับ canonical การทดสอบที่รวมกรณีเหล่านี้จะบอกคุณภาพของกระบวนการได้มากกว่านับจำนวนบรรทัดอย่างเดียว
เมื่อแจ้ง sitemap ผ่านเครื่องมือที่รองรับแล้ว ให้ดูสถานะการอ่านไฟล์กับปัญหาที่รายงาน แต่ยังต้องแยกจากสถานะ index ของ URL ภายใน การอ่านไฟล์สำเร็จไม่ได้หมายถึงทุกรายการผ่านขั้นประมวลผลต่อครบแล้ว
ควรมีบันทึกนโยบายสั้นๆ ว่าคัดหน้าอย่างไร ใช้วันไหน และข้อมูลเผยแพร่เปลี่ยนแล้วส่วนใดต้องถูกอัปเดต คนที่รับช่วงจะได้เพิ่มหมวดหรือฟิลด์ใหม่โดยไม่ทำให้ไฟล์รายการส่งความหมายต่างจากหน้าเว็บ
Sitemap ควรรวบ URL หลักที่เผยแพร่จริงตามเงื่อนไขเดียวกับหน้าเว็บ พร้อมรายงานวันอัปเดตที่เชื่อถือได้ เมื่อสร้างจากข้อมูลที่มีนโยบายชัดและตรวจไฟล์สาธารณะหลังเปลี่ยนเนื้อหา เราจะรักษารายการให้ตรงกับสิ่งที่อยากให้คนค้นพบได้ โดยยังแยกการแจ้ง URL ออกจากผลการนำเข้าดัชนีครับ