


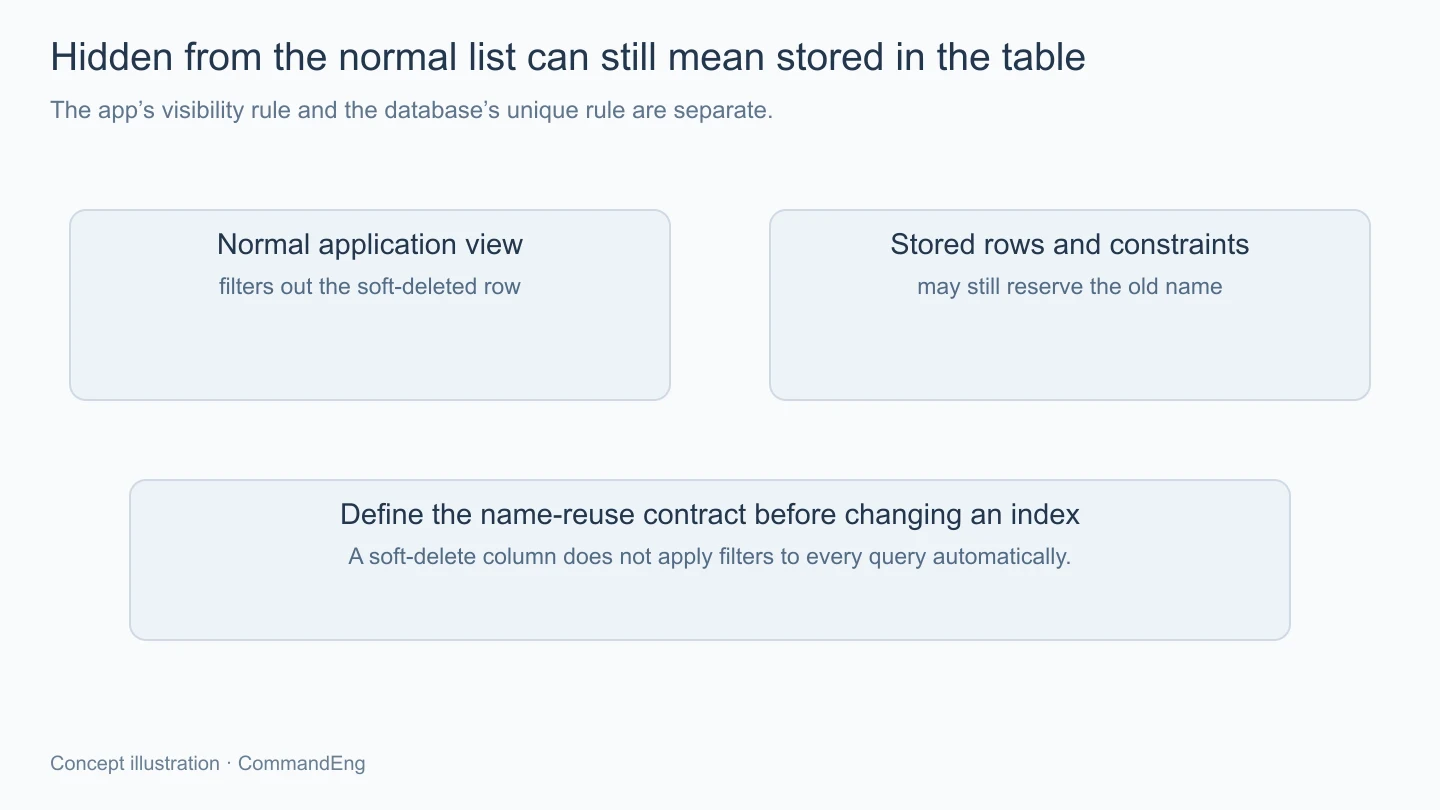
บางระบบไม่ได้ลบแถวออกจากฐานทันทีเมื่อคนกดลบ แต่เก็บเวลา deleted_at หรือสถานะไว้ แล้วไม่แสดงรายการนั้นในหน้าปกติ วิธีนี้ช่วยให้มีทางตรวจประวัติหรือกู้รายการตามนโยบายของงานได้ แต่สิ่งที่หายจากหน้าจอยังอาจอยู่ในฐานเหมือนเดิม
ความต่างจะเห็นชัดตอนสร้างรายการใหม่ด้วยชื่อหรือรหัสเดิม หน้าจอค้นไม่พบแล้ว แต่ฐานกลับแจ้งว่าค่าซ้ำ หากมองเฉพาะรายการที่แสดงก็อาจรู้สึกว่าข้อผิดพลาดขัดกับสิ่งที่เห็น ทั้งที่ constraint ยังครอบแถวเดิมซึ่งถูกซ่อนไว้อยู่
ก่อนแก้ index จึงควรตกลงความหมายของการลบกับการใช้ชื่อซ้ำก่อนครับ เพราะทางเลือกทางเทคนิคจะถูกหรือผิดขึ้นกับว่าระบบตั้งใจรักษาข้อตกลงใด
การใส่เวลา deleted_at ไม่ทำให้ฐานเข้าใจเองว่าต้องซ่อนแถวนี้จากทุก query แอปต้องใช้เงื่อนไขตามการออกแบบในหน้ารายการ การค้น การส่งออกและจุดอ่านอื่นๆ ไม่ใช่เพิ่มเงื่อนไขไว้หน้าเดียวแล้วถือว่าทุกทางมองสถานะเหมือนกันแล้ว
เมื่อมีงานเบื้องหลังหรือ raw query เพิ่มเข้ามา ก็ต้องทบทวนเส้นทางเหล่านี้ด้วย บางงานต้องไม่แตะรายการที่ลบแล้ว ขณะที่หน้าตรวจประวัติอาจจำเป็นต้องอ่านได้ตามสิทธิ์ จึงต้องบอกขอบเขตอย่างชัด ไม่ซ่อนเงื่อนไขทุกอย่างไว้จนคนทำงานต่อไม่รู้ว่าข้อมูลถูกกรองไปแล้ว
ข้อดีเรื่องกู้คืนก็มีเงื่อนไขตามข้อมูลที่เหลือและความสัมพันธ์ที่ยังรักษาไว้ การมีแถวอยู่ไม่ได้รับรองว่าไฟล์ภายนอกหรือรายการลูกยังอยู่ครบ ถ้ากระบวนการอื่นเก็บกวาดส่วนเหล่านั้นไปแล้ว ก็ต้องมีวิธีอธิบายสภาพที่กู้ได้จริง
บางงานต้องรักษารหัสไว้แม้เลิกใช้งาน เพื่อไม่ให้เอกสารหรือระบบภายนอกที่อ้างรหัสเดิมสับสนกับรายการใหม่ ในกรณีนั้น unique ที่ครอบแถวทั้งหมดอาจตรงตามเจตนา การแจ้งว่าค่าถูกใช้ไปแล้วควรช่วยคนค้นประวัติตามสิทธิ์ แทนการรีบปลดข้อจำกัดเพียงเพื่อให้บันทึกผ่าน
อีกแบบหนึ่งอาจตั้งใจให้ชื่อที่แสดงใช้ซ้ำได้เมื่อรายการเดิมถูกลบแล้ว โดยยังใช้ ID ถาวรแยกเจ้าของข้อมูล แบบนี้ต้องระบุว่า uniqueness ครอบเฉพาะรายการที่ยังใช้งาน และถ้ามีหลายองค์กรก็ควรบอกว่าชื่อนี้ไม่ซ้ำภายในองค์กรหรือทั้งระบบ
ยังมีเรื่องรูปแบบค่าที่ถือว่าเหมือนกัน เช่น ตัวพิมพ์เล็กใหญ่หรือการเว้นช่องว่าง การเลือก unique แบบใดควรสัมพันธ์กับกติกา normalize ที่ใช้จริง ไม่ให้หน้าจอบอกว่าชื่อเดียวกันแต่ฐานถือว่าไม่ซ้ำ หรือกลับกันตามเส้นทางรับข้อมูลคนละชุด
PostgreSQL รองรับ unique index บนชุดย่อยของตาราง โดยกำหนด predicate ว่าแถวใดอยู่ในขอบเขตที่ต้องไม่ซ้ำ ตัวอย่างแนวคิดนี้ใช้ชื่อ schema สมมติสำหรับงานที่อนุญาตให้ใช้ slug ซ้ำหลังลบ และยังแยกขอบเขตตาม tenant
CREATE UNIQUE INDEX example_items_active_slug
ON example_items (tenant_id, slug)
WHERE deleted_at IS NULL;
คำสั่งนี้อธิบายกติกาของแถวที่ยัง active ตามเงื่อนไข ไม่ได้ทำให้ query ทุกตัวกรอง deleted_at ให้อัตโนมัติ และต้องกำหนดความหมายของ tenant กับ slug รวมถึงกรณี null ให้ตรงกับสิ่งที่ต้องการบังคับด้วย
การเพิ่ม index ใหม่นี้ยังไม่ยกข้อจำกัด unique เดิมที่ครอบทุกแถวออกเอง หากของเดิมยังอยู่ มันก็ยังอาจปฏิเสธชื่อซ้ำตามกติกาเดิม ต้องสำรวจ schema กับข้อมูลก่อนวาง migration ไม่สั่งเปลี่ยน constraint ในฐานจริงตามตัวอย่างโดยไม่ตรวจผลกระทบ
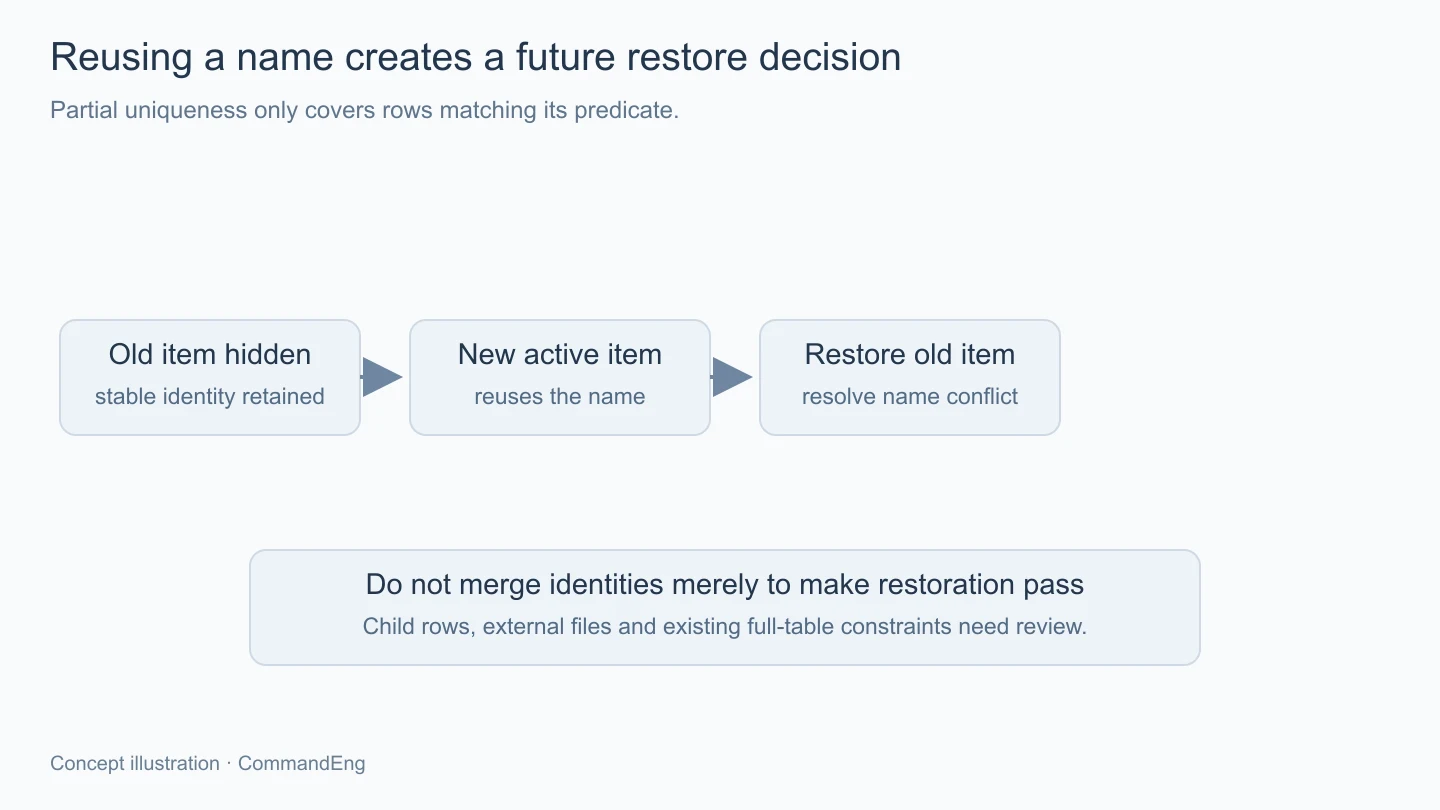
ถ้าอนุญาตให้นำชื่อเดิมไปสร้างรายการใหม่ได้ การกู้แถวเก่าด้วยการล้าง deleted_at ก็อาจทำให้มี active สองรายการชื่อเดียวกันได้ ซึ่ง partial unique index จะช่วยบังคับเงื่อนไขในจุดนี้ แต่แอปต้องมีคำตอบให้คนใช้ต่อ
ทางเลือกอาจเป็นให้เปลี่ยนชื่อก่อนกู้ ปฏิเสธจนกว่าจะจัดการรายการใหม่ หรือใช้กระบวนการที่เจ้าของงานอนุมัติตามบริบท สิ่งที่ไม่ควรทำคือแอบรวมสองรายการหรือชี้ข้อมูลอ้างอิงไปอีก ID เพียงเพื่อทำให้คำสั่งสำเร็จ โดยยังไม่รู้ว่าข้อมูลทั้งสองเป็นสิ่งเดียวกันจริงหรือไม่
กรณีมีคนสร้างกับกู้พร้อมกันก็ต้องให้เงื่อนไขที่ฐานช่วยตัดสิน ไม่ใช้เพียงค้นก่อนว่าไม่มีชื่อแล้วค่อยเขียนโดยไม่บังคับข้อจำกัด เพราะสองคำขออาจค้นผ่านพร้อมกัน การแจ้งความขัดแย้งจึงเป็นส่วนปกติที่ต้องออกแบบในหน้ากู้ด้วย
Foreign key ช่วยตรวจการอ้างถึงแถวตามข้อกำหนดของฐาน แต่การที่แถวแม่ยังอยู่พร้อม deleted_at ไม่ได้ทำให้ฐานปฏิเสธรายการลูกที่อ้างถึงมันเองทุกกรณี เงื่อนไขว่าแม่ต้องยัง active เป็นอีกกติกาที่ต้องวางให้ตรงตามงาน
จึงควรกำหนดว่าลบแม่แล้วรายการลูกถูกซ่อนตาม ยังค้นประวัติได้ หรือถูกจำกัดการแก้เพิ่ม และเมื่อกู้แม่กลับมาอะไรควรกลับมาด้วย ไม่อาศัยการที่หน้าจอไม่เห็นแม่แล้วปล่อยให้ worker ทำงานกับลูกต่อไปตามสภาพเดิมโดยไม่มีการตรวจ
ไฟล์และงานที่รอในคิวก็เป็นส่วนของวงจรนี้ ถ้างานเริ่มหลังผู้ใช้ลบรายการไปแล้ว ต้องตรวจว่ามันยังควรสร้างผลหรือไม่ ส่วนไฟล์ที่ลบถาวรต้องมีเงื่อนไขรักษาการอ้างอิงและช่วงกู้ตามนโยบาย ไม่ใช้เวลาเก่าของแถวเป็นเหตุเพียงอย่างเดียวสำหรับลบข้อมูลที่ยังถูกใช้อยู่
ชุดทดลองควรมีทั้งกติกาที่เก็บชื่อไว้ตลอดกับกติกาที่เปิดใช้ซ้ำตามที่ระบบเลือก ตรวจขอบเขตองค์กร ชื่อที่ normalize แล้วเท่ากัน และคำขอสร้างกับกู้ที่มาพร้อมกัน พร้อมดูหน้ารายการและทางอ่านที่ควรเห็นประวัติต่างกัน
บทนี้ไม่ได้เปลี่ยน schema หรือลบข้อมูลจริง ตัวอย่าง index ใช้อธิบายทางเลือกเท่านั้น ส่วนระยะเก็บและขั้นลบถาวรต้องเป็นนโยบายที่เจ้าของข้อมูลกับทีมตกลงตามงาน ไม่เกิดขึ้นเพียงเพราะเพิ่ม field deleted_at แล้ว
Soft delete ทำให้ข้อมูลยังอยู่ภายใต้กติกาที่แอปกำหนด จึงต้องตกลงทั้งการมองเห็น การใช้ชื่อซ้ำและการกู้คืนก่อนเลือก constraint เมื่อ index กับเส้นทางอ่านเขียนรักษานโยบายเดียวกัน เราจะอธิบายชื่อที่ซ้ำหรือการกู้ที่ติดเงื่อนไขได้ตรงเหตุผล พร้อมดูแลรายการลูกและไฟล์ที่เกี่ยวข้องตลอดวงจรข้อมูล