


เมื่อระบบเริ่มเก็บ trace ได้ เรามักอยากย้อนจากเวลาที่ผู้ใช้แจ้งปัญหาไปหาคำขอนั้น แล้วดูว่ามันรออยู่ตรงไหน แต่บางครั้งค้นแล้วไม่พบ ทั้งที่มี log ยืนยันว่างานเกิดขึ้นจริง การไม่มี trace จึงทำให้เกิดข้อสงสัยได้ว่าติดตั้ง instrumentation ไม่ครบหรือระบบส่งข้อมูลเสียหรือเปล่า
ก่อนเลือกสาเหตุต้องดูอีกเงื่อนไขหนึ่งคือระบบตั้งใจเก็บทุก trace หรือเลือกเก็บเพียงบางส่วน การเลือกนี้เรียกว่า sampling ซึ่งอาจเกิดตั้งแต่แอป ก่อนส่งเข้า collector หรือในขั้นประมวลผลภายหลังตามสถาปัตยกรรมที่ใช้
พอรู้ว่าข้อมูลผ่านการเลือกมาอย่างไร เราจะอ่านได้ทั้งเหตุที่หาไม่เจอและขอบเขตของสิ่งที่ trace ชุดนั้นใช้ยืนยันได้ครับ
Head sampling ตัดสินใจตั้งแต่ช่วงต้นโดยไม่ต้องรอเห็น trace ทั้งชุด จึงช่วยลดข้อมูลที่ต้องบันทึกและส่งต่อได้เร็ว การเลือกอาจอาศัยกติกาที่ทำให้แต่ละส่วนตัดสินใจสอดคล้องกันตามระบบที่ใช้ ไม่ควรปล่อยให้ทุกบริการสุ่มแยกกันโดยไม่ตรวจความสัมพันธ์
ข้อจำกัดคือ ตอนเริ่มต้นเรายังไม่รู้ว่าคำขอนั้นจะช้าหรือจบด้วย error หรือไม่ หากเลือกไม่เก็บไปตั้งแต่ต้น แล้วภายหลังงานเกิดปัญหา ก็ไม่มีรายละเอียดครบชุดให้เรียกคืนเพียงเพราะตอนนี้เราสนใจมันแล้ว
ดังนั้นข้อความว่าเก็บ trace บางส่วนกับข้อความว่าเก็บข้อผิดพลาดทุกครั้งจึงเป็นคนละคำสัญญา การตั้งกติกาตั้งแต่ต้นเพียงอย่างเดียวไม่ได้รับรองว่าจะเก็บทุกงานที่มี error เกิดขึ้นในช่วงท้าย
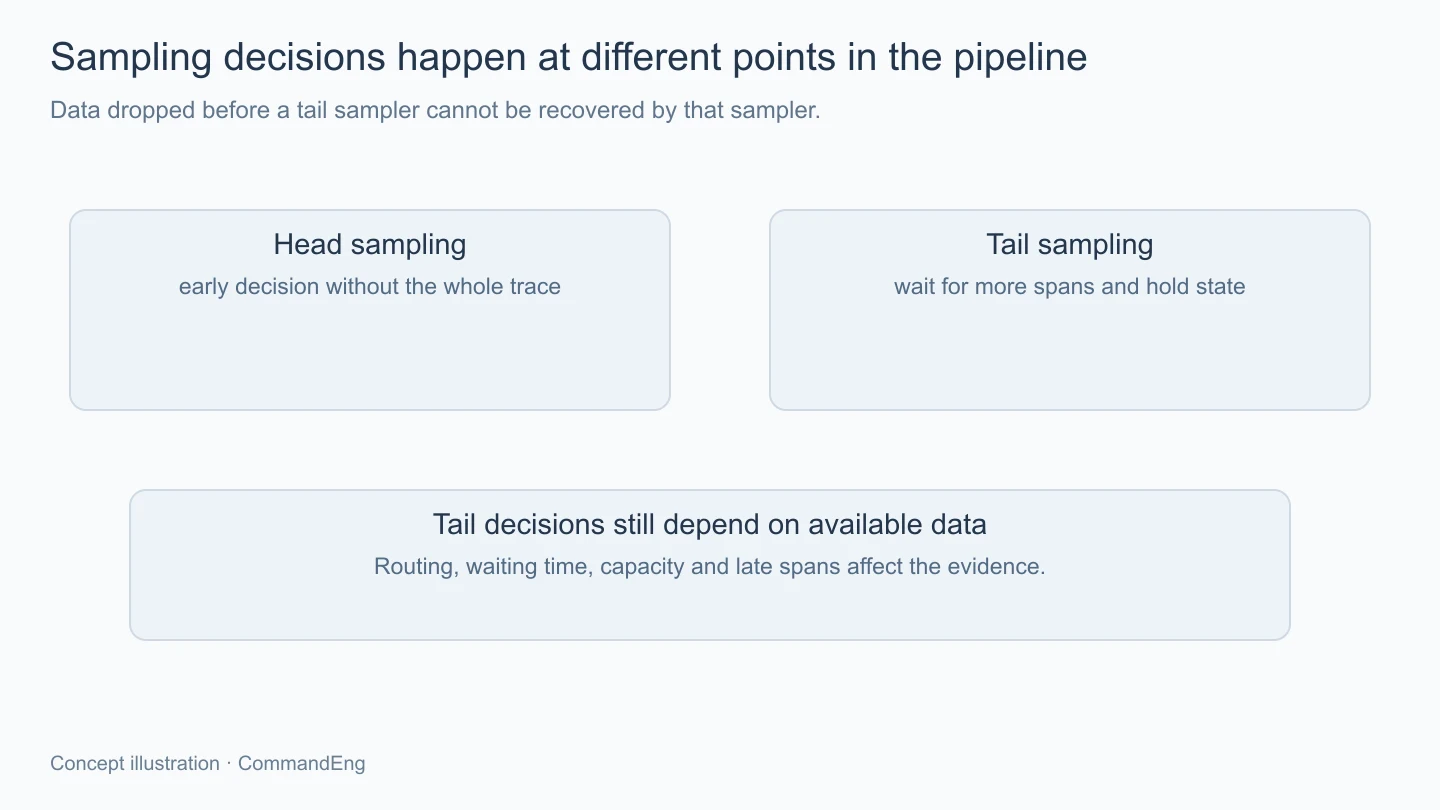
Tail sampling ใช้ข้อมูลจาก span ส่วนใหญ่หรือหลายส่วนของ trace มาช่วยตัดสินใจ จึงวางนโยบายตามอาการได้ เช่น เลือกเก็บงานที่มีสถานะผิดพลาด หรืองานที่ใช้เวลานานตามนิยามที่กำหนดไว้ แทนการตัดสินจากข้อมูลช่วงเริ่มเพียงอย่างเดียว
สิ่งที่ตามมาคือส่วนที่ตัดสินใจต้องรวบรวมและรักษาสถานะระหว่างรอ จึงใช้หน่วยความจำ เวลา และโครงสร้างการส่งข้อมูลที่สัมพันธ์กัน หาก span ของงานเดียวกระจายไปคนละจุดโดยไม่มีวิธีรวมตามที่ส่วนประมวลผลต้องการ การตัดสินใจก็อาจไม่เห็นบริบทครบตามนโยบาย
ระยะรอก็มีผล งานที่ยาวหรือ span ที่มาถึงช้าอาจไม่อยู่ในข้อมูลตอนตัดสินใจ จึงต้องอ่านพฤติกรรมของเครื่องมือกับค่าที่ตั้งจริง ไม่ใช้คำว่า tail แล้วถือว่าได้ดูผลสุดท้ายครบทุกเหตุการณ์โดยอัตโนมัติ
อีกข้อที่สำคัญคือ ข้อมูลที่ถูกทิ้งก่อนถึงจุดนี้จะไม่กลับมาเอง หากมี head sampling อยู่ด้านหน้า Tail sampling ก็ทำได้กับชุดที่ผ่านมาถึงแล้วเท่านั้น นโยบายเก็บ error ที่ปลายทางจึงไม่ควรถูกอธิบายว่ารับรองเก็บ error ทุกตัวของระบบ โดยไม่ดูเส้นทางก่อนหน้า
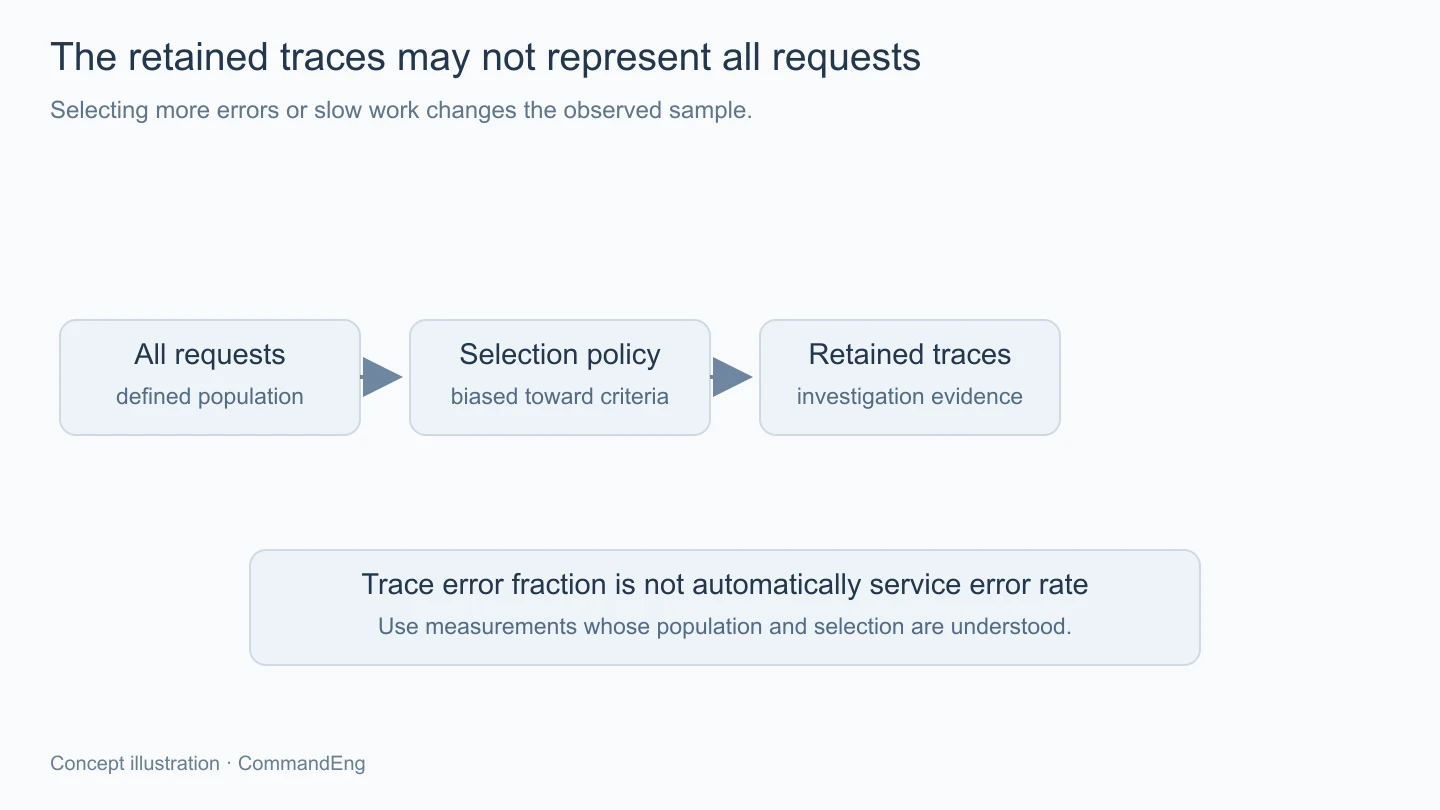
สมมติว่าตั้งใจเก็บงานผิดพลาดไว้มากกว่างานปกติเพื่อช่วยสืบปัญหา ในหน้ารายการ trace ที่เก็บก็ย่อมมีโอกาสเห็นสัดส่วน error สูงขึ้นตามการเลือกนั้น หากนำจำนวน error ในหน้านี้หารจำนวน trace ทั้งหมดที่เก็บ แล้วรายงานว่าเป็นอัตราความผิดพลาดของผู้ใช้ทุกคน ก็จะข้ามกติกาที่คัดข้อมูลมา
ลักษณะเดียวกันเกิดกับการเก็บงานช้าเป็นพิเศษ การกระจายเวลาในชุดที่เหลือไม่จำเป็นต้องแทนทั้งบริการ การอธิบายด้วยข้อมูล trace จึงควรบอกนโยบายที่เกี่ยวข้อง และใช้ข้อมูลที่วัดประชากรตามขอบเขตที่ต้องการเมื่อจะรายงานอัตรารวมหรือเป้าหมายบริการ
Metrics ที่ออกแบบนับงานในขอบเขตนั้นอาจเป็นแหล่งประกอบที่เหมาะกว่า แต่ต้องตรวจด้วยว่ามันถูกคำนวณก่อนหรือหลังการคัด trace หากสร้าง metrics จาก trace ที่ผ่าน sampling มาแล้ว ก็ยังต้องเข้าใจวิธีประมาณและข้อจำกัด ไม่คิดว่าเปลี่ยนเป็นกราฟตัวเลขแล้วอคติหายไปเอง
เมื่อเปลี่ยนนโยบายควรบันทึกช่วงที่เริ่มใช้ไว้ด้วย ไม่เช่นนั้นกราฟจาก trace ก่อนกับหลังอาจดูต่างเพราะการคัดข้อมูลเปลี่ยน ไม่ใช่เพราะผู้ใช้เจอ error มากขึ้นจริง การเปรียบเทียบจึงต้องรักษาทั้งช่วงเวลา ขอบเขตบริการ และเงื่อนไขการเลือกให้มองเห็นได้
คำขอที่หาไม่เจออาจถูกตัดตาม sampling หรืออาจติดปัญหาอีกชนิด เช่น ไม่มี span ถูกสร้าง ส่งออกไม่ผ่าน คิว telemetry เต็ม หรือข้อมูลถูกปฏิเสธที่ปลายทาง จึงควรแยกจุดตัดสินใจออกจากเส้นทางขนส่งข้อมูลก่อนตามปัญหา
การดูสุขภาพของ collector และ exporter ช่วยตอบว่าข้อมูลเข้ามาแล้วถูกส่งต่อได้หรือไม่ ส่วนสถานะของตัว sampler ช่วยดูว่ามันทำงานทันและใช้ทรัพยากรอยู่ในขอบเขตหรือเปล่า ต้องอิงตัวชี้วัดและความหมายที่ component รุ่นนั้นรองรับ ไม่ตั้งสมมติฐานว่าทุกตัวมี metric ชื่อเดียวกัน
อายุเก็บและสิทธิ์ค้นก็เป็นอีกชั้น บางครั้งข้อมูลเคยมีแต่พ้นระยะเก็บ หรือผู้ค้นกำลังมองคนละ environment กับเหตุการณ์ การไล่ตามเส้นทางตั้งแต่การสร้างจนถึงการค้นจึงช่วยลดการเปลี่ยนค่า sampling ทั้งที่สาเหตุอยู่ปลายทาง
ถ้าจุดประสงค์คือดูเส้นทางทั่วไป เราอาจต้องการตัวอย่างที่หลากหลายและเข้าใจวิธีเลือก ส่วนการตามปัญหารุ่นใหม่อาจต้องเพิ่มโอกาสเห็นบริการหรือกลุ่มงานที่เกี่ยวข้อง แต่การเพิ่มข้อมูลควรมีขอบเขตเวลาและทรัพยากร ไม่เปิดทุกอย่างค้างโดยไม่มีคนติดตามผล
สามารถตรวจด้วยชุดงานทดลองที่รู้จำนวนและชนิดไว้ล่วงหน้า แล้วเปรียบเทียบสิ่งที่แต่ละจุดรับกับสิ่งที่ backend เห็น รวมถึงงานที่ช้ากว่าปกติและ span ที่มาถึงภายหลัง โดยใช้ข้อมูลที่ไม่มีรายละเอียดลูกค้า บทนี้ยังไม่มีผลทดสอบ sampling หรือตัวเลขต้นทุนจริง จึงไม่เสนออัตราเดียวว่าประหยัดและเพียงพอกับทุกระบบ
Trace ที่ค้นได้เป็นหลักฐานตามขอบเขตการสร้าง การเลือกและการส่งข้อมูล Head กับ tail sampling ให้ข้อมูลประกอบการเลือกต่างกัน และต่างมีภาระที่ต้องดูแล เมื่อบอกกติกาเหล่านี้ได้ เราจะใช้ trace ตามปัญหาได้ตรงขึ้น พร้อมแยกสิ่งที่ไม่ถูกเก็บออกจากสิ่งที่ไม่เคยเกิด โดยไม่เอาชุดตัวอย่างไปแทนสถิติของระบบทั้งหมดอย่างไม่มีเงื่อนไข