บอร์ดรีสตาร์ตเอง ลองอ่าน watchdog ก่อน
ถ้าบอร์ดรีสตาร์ตเป็นพักๆ สิ่งแรกที่หลายคนนึกถึงมักเป็นแหล่งจ่ายหรือสาย USB ซึ่งก็เป็นจุดที่ควรตรวจ แต่ก่อนเปลี่ยนอุปกรณ์ไปเรื่อยๆ ยังมีข้อมูลจากระบบที่ช่วยบอกได้ว่ามันเริ่มใหม่เพราะอะไร และกำลังทำงานส่วนใดอยู่ก่อนเกิดเหตุ
หนึ่งในข้อความที่อาจพบคือ watchdog ครับ ชื่อนี้บอกว่ามีกลไกเฝ้าดูบางส่วนของระบบไม่ได้รับสัญญาณความคืบหน้าตามเงื่อนไข แต่ยังไม่ควรถูกแปลทันทีว่าเซนเซอร์ตัวใดเสีย หรือว่าต้องปิดตัวเฝ้าให้โปรแกรมเดินต่อ
บทนี้อยากค่อยๆ ไล่จากหลักฐานตอนเริ่มใหม่ ไปดูว่างานใดกำลังยึดเวลาหรือรอโดยไม่มีขอบเขต เพื่อให้แก้ที่พฤติกรรมของโปรแกรมและยังเหลือตัวช่วยตรวจปัญหาอยู่
เก็บเหตุเริ่มใหม่ก่อนแก้การตั้งค่า
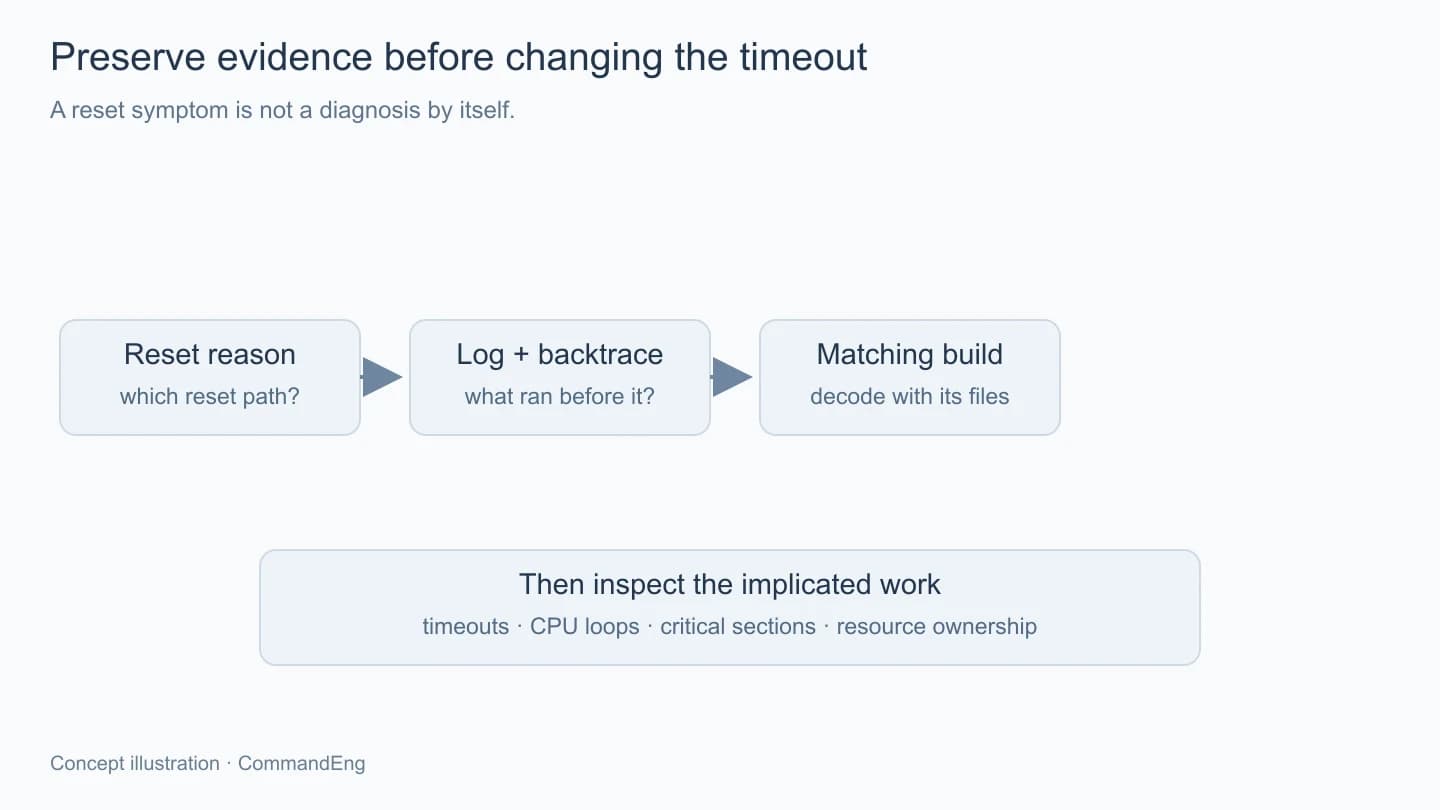
ใน ESP-IDF มีข้อมูล reset reason ให้ตรวจตอนเริ่มแอป ซึ่งช่วยแยกเหตุรีสตาร์ตหลายแบบได้ ควรเก็บพร้อมรุ่นเฟิร์มแวร์ ระยะเวลาตั้งแต่เปิด และข้อความท้ายๆ ของรอบก่อนเท่าที่เก็บได้ ไม่ใช้เพียงข้อสังเกตว่าไฟบนบอร์ดกะพริบแล้วเป็นหลักฐานของ watchdog
ถ้ามี panic หรือ backtrace ก็ควรเก็บให้ครบก่อนปรับโค้ด เพราะที่อยู่และสัญลักษณ์ต้องอ่านคู่กับไฟล์ของรุ่นที่เกิดเหตุ หากบิ้วใหม่แล้วทิ้งไฟล์เดิม เราอาจเสียข้อมูลที่ช่วยระบุตำแหน่งได้ไปโดยไม่จำเป็น
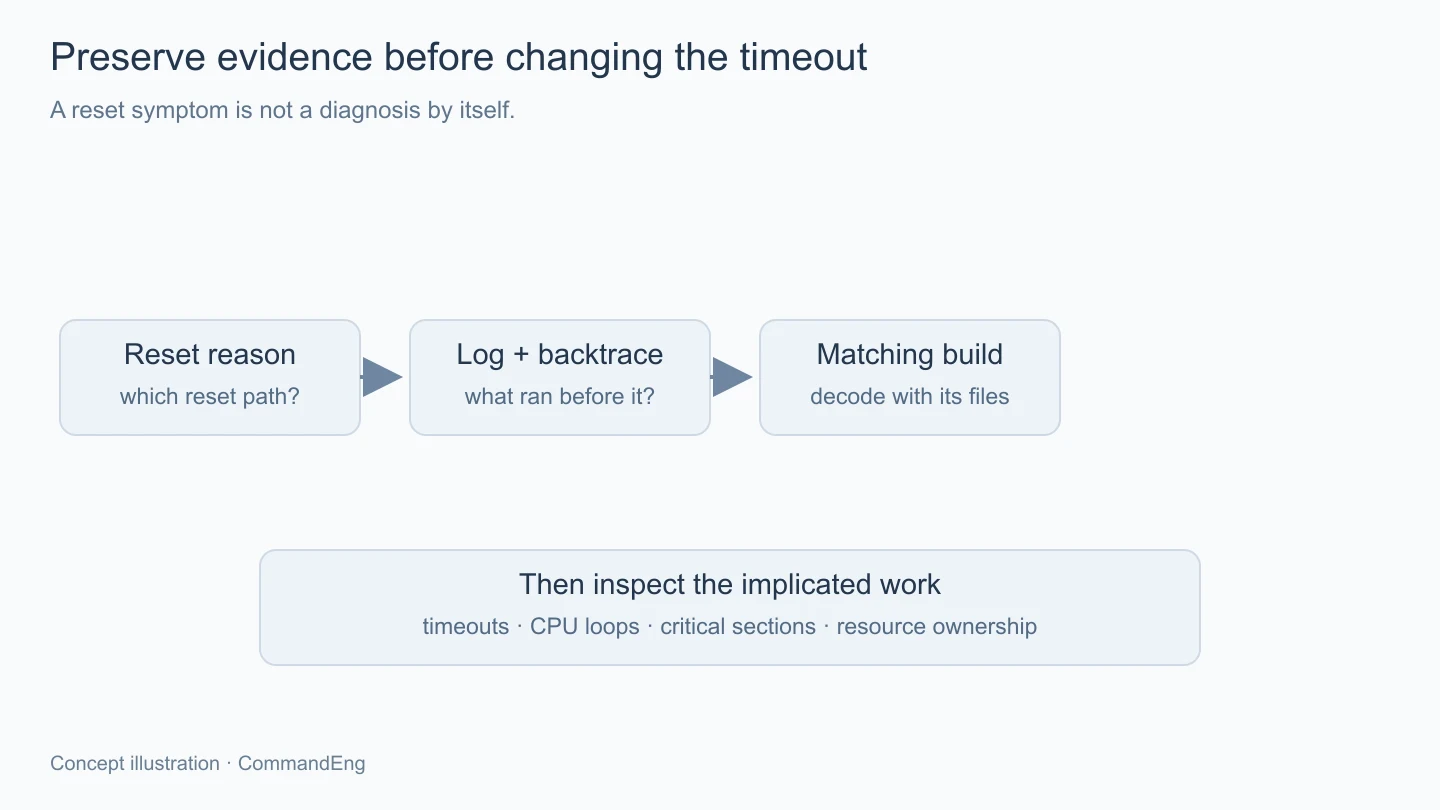
ส่วนเหตุไฟเลี้ยงผิดปกติก็ยังต้องตรวจตามหลักฐานของมัน หากข้อมูลชี้ไปอีกทาง เราไม่ควรฝืนเรียกทุกการรีเซตว่า watchdog การแยกชื่อเหตุให้ถูกตั้งแต่ต้นช่วยไม่ให้ไปเพิ่ม timeout ของซอฟต์แวร์เพื่อกลบปัญหาคนละชนิด
ในช่วงที่อาการเกิดนานๆ ครั้ง ลองเพิ่มบันทึกว่าเพิ่งเริ่มและจบงานสำคัญใด แต่ไม่พิมพ์ถี่จนการบันทึกกลายเป็นภาระใหม่ของระบบ เป้าหมายคือเห็นขอบเขตที่ค้าง ไม่ใช่ทำให้ log มากจนตามเหตุการณ์จริงไม่ทัน
watchdog แต่ละแบบกำลังดูคนละอย่าง
ESP-IDF มีหลายกลไกที่เกี่ยวข้อง เช่น interrupt watchdog กับ task watchdog ซึ่งใช้ตรวจความคืบหน้าคนละระดับ การเจอข้อความชื่อใดจึงมีผลกับวิธีไล่สาเหตุ ไม่ควรรวมทั้งหมดเป็นตัวตั้งเวลาที่ต้องคอย reset เหมือนกันเสมอ
งานที่ปิด interrupt นานหรืออยู่ใน critical section ยาวเกินอาจกระทบการทำงานระดับระบบ ขณะที่งานที่ใช้ CPU วนต่อเนื่องโดยไม่เปิดโอกาสให้งานอื่นได้ทำ ก็เป็นอีกลักษณะที่ต้องตรวจตามการเฝ้า task ที่ตั้งไว้ พฤติกรรมหลังตรวจพบยังขึ้นกับการตั้งค่าการแจ้งและ panic ด้วย
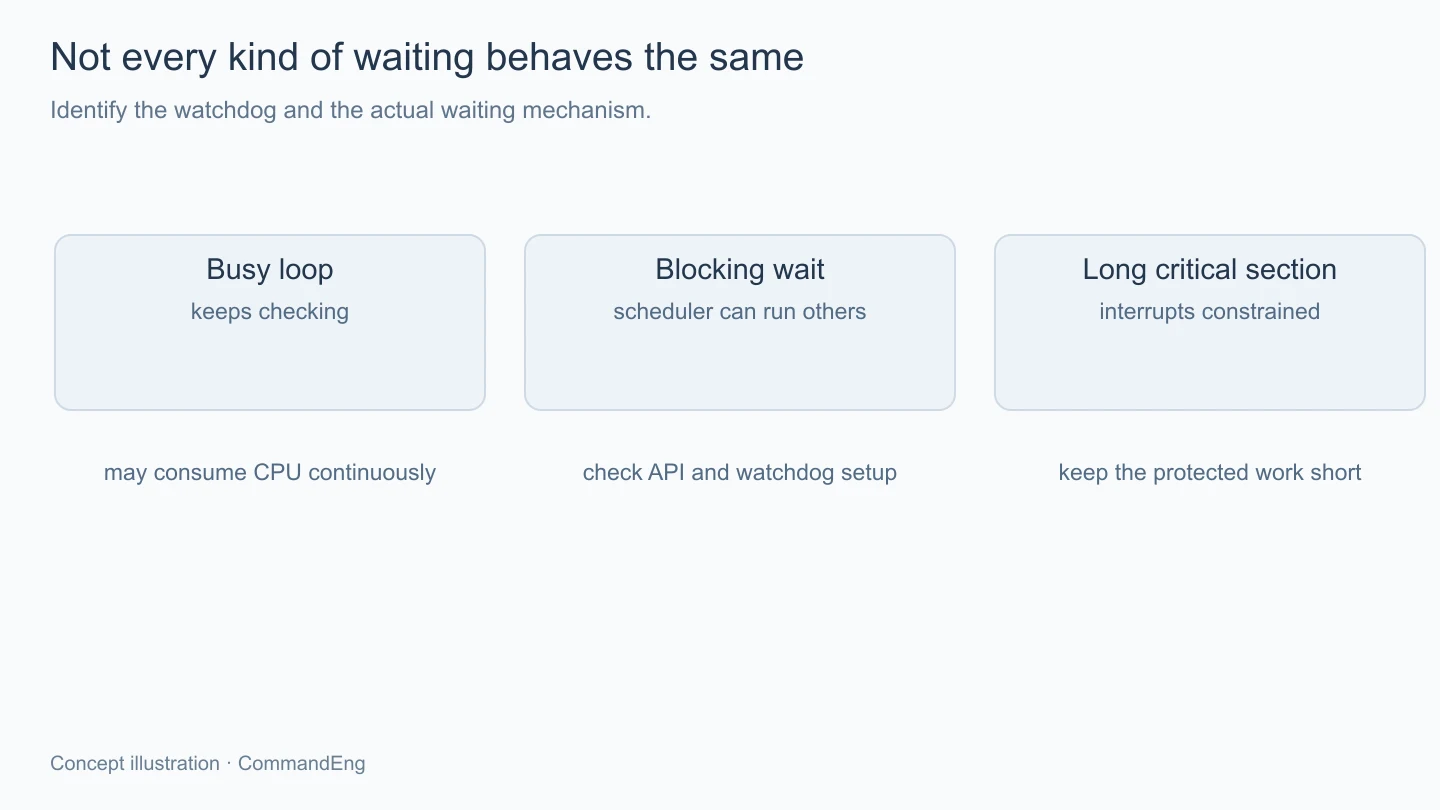
สิ่งสำคัญคือการรอไม่ได้ผิดทุกแบบ คำสั่งรอของระบบบางอย่างปล่อยเวลาให้ scheduler ไปทำงานอื่นได้ แต่ลูปที่วนตรวจเองตลอดอาจไม่ยอมคืนเวลา ส่วน task ที่สมัครให้ถูกเฝ้าไว้ก็ยังต้องตอบเงื่อนไขของมัน จึงต้องดูทั้ง API ที่รอและวิธีตั้ง watchdog ร่วมกัน
การเพิ่ม delay แบบสุ่มอาจทำให้อาการเปลี่ยน แต่ยังไม่บอกว่างานใดควรมีขอบเขตอย่างไร เราควรกลับไปตั้งคำถามว่าระหว่างรอนั้นระบบจำเป็นต้องทำอะไรต่อ และมีจุดใดที่กำลังถือทรัพยากรร่วมไว้จนงานอื่นไปต่อไม่ได้
หาขอบเขตของงานที่ยาวเกินคาด
เริ่มจากงานที่เกี่ยวข้องกับสิ่งภายนอก เช่น รอเครือข่าย อ่านอุปกรณ์ หรือประมวลผลข้อมูลจำนวนมาก แล้วตรวจว่าทุกเส้นทางมี timeout และทางออกเมื่อไม่สำเร็จหรือไม่ บางครั้งกรณีปกติจบเร็ว แต่เส้นทางผิดพลาดกลับวนไม่จบ
ลองจดระยะเวลาของแต่ละช่วงตามผลวัดจริง แยกเวลาที่ใช้คำนวณกับเวลาที่รอ ไม่สรุปจากชื่อฟังก์ชันเพียงอย่างเดียวว่าตัวนี้ต้องเร็ว เพราะฟังก์ชันเดียวกันอาจมีการเชื่อมต่อใหม่ ลองซ้ำ หรือเขียนข้อมูลถาวรซ่อนอยู่ภายใน
ถ้าเป็นงานคำนวณยาว อาจแบ่งเป็นส่วนที่มีขอบเขตและเปิดโอกาสให้ระบบทำงานอื่นตามจังหวะที่เหมาะสม ส่วนงานรออุปกรณ์ก็ควรใช้กลไกที่ framework รองรับ แทนการหมุนอ่านสถานะตลอดเวลาโดยไม่มีเหตุให้หลุดออก
การแยกเป็น task ใหม่อาจช่วยจัดหน้าที่ได้ แต่ไม่แก้ลูปที่ยังยึด CPU หรือถือ lock นานโดยอัตโนมัติ หากเพิ่ม priority ให้งานที่ค้าง ก็อาจทำให้งานที่จำเป็นส่วนอื่นได้เวลาน้อยลงกว่าเดิมด้วย
คอยเลี้ยง watchdog ต้องสัมพันธ์กับความคืบหน้า
ถ้าโค้ดเรียก reset watchdog ในทุกลูป แม้กำลังวนอยู่กับข้อผิดพลาดเดิม เราก็อาจทำให้ระบบดูเหมือนยังมีความคืบหน้าทั้งที่หน้าที่หลักไม่เคยสำเร็จ การวางจุดยืนยันจึงควรสะท้อนสิ่งที่กลไกนั้นต้องการเฝ้าจริง
เช่น งานหนึ่งต้องทำรอบประมวลผลให้ครบตามข้อกำหนด ก็ควรรู้ว่ารอบนั้นผ่านส่วนใดแล้วและยังตอบสนองได้หรือไม่ ไม่ให้ timer อีกตัวเลี้ยงแทนตลอดโดยไม่ได้ตรวจงานหลัก เพราะเมื่อส่วนที่สำคัญค้าง ตัวเฝ้าก็จะมองไม่เห็นสิ่งที่เราอยากให้ตรวจ
เรื่องนี้ไม่ได้แปลว่าห้ามเปลี่ยน timeout ทุกกรณี งานบางอย่างมีระยะเวลาที่ถูกต้องตามหน้าที่ของมัน แต่ควรมีหลักฐานว่าขอบเขตเวลาที่เลือกเหมาะสม และยังตรวจพบการค้างที่ต้องการได้ ไม่เพิ่มจนข้อความหายอย่างเดียวแล้วถือว่าแก้แล้ว
ทดลองกรณีที่ปลายทางไม่ตอบด้วย
เมื่อแก้เส้นทางรอแล้ว ควรลองสถานการณ์ที่ตั้งใจให้ล้มเหลวในชุดทดสอบ เช่น ไม่มีเครือข่ายหรืออุปกรณ์ไม่ตอบตามขอบเขตที่ปลอดภัย แล้วดูว่างานอื่นยังทำต่อได้หรือไม่ รวมถึงระบบรายงานสถานะให้ตามได้แค่ไหน
นอกจากไม่รีสตาร์ต ก็ควรตรวจว่ายังอ่านปุ่ม อัปเดตหน้าจอ หรือจัดการข้อมูลสำคัญได้ตามหน้าที่ที่กำหนด เพราะการทำให้บอร์ดไม่เริ่มใหม่โดยยังค้างทั้งระบบ ก็ไม่ได้ทำให้ประสบการณ์ใช้งานดีขึ้น
เก็บผลกับรุ่นที่แก้ไว้ด้วย หากอาการเกิดหลังเปิดทิ้งนานก็ควรมีเวลาทดสอบที่เหมาะกับรูปแบบนั้น ไม่ยืนยันจากการรันสั้นๆ ว่าปัญหาหายแน่นอน ส่วนบทนี้ยังไม่มีผลทดสอบของบอร์ดใด จึงใช้เป็นลำดับตรวจเพื่อไปเก็บหลักฐานต่อครับ
หากเพิ่มเครื่องมือวัดระยะเวลาไว้ในโค้ด ควรเปิดใช้เฉพาะเท่าที่จำเป็นและเทียบพฤติกรรมกับสภาพใช้งานด้วย เพราะ log หรือเครื่องมือดีบักอาจเปลี่ยนจังหวะของระบบได้ บันทึกวิธีเก็บข้อมูลไว้จะช่วยให้คนที่รับช่วงทำซ้ำและอ่านข้อจำกัดของหลักฐานชุดนั้นได้ถูกต้อง
สรุป
เมื่อพบ watchdog ให้เริ่มจากเก็บเหตุรีเซตและหลักฐานของรุ่นที่เกิด แล้วแยกว่าระบบกำลังเฝ้าอะไร ก่อนตรวจลูป งานรอ และช่วงถือทรัพยากรที่ยาวเกินไป การแก้ให้แต่ละงานมีขอบเขตและยืนยันความคืบหน้าอย่างมีความหมาย จะช่วยให้ watchdog ยังทำหน้าที่ของมัน และทำให้ระบบกลับมาทำงานหลักได้จริงครับ

